Thinking Inertia: なぜLLMは「考えるな」と言われても思考を止められないのか?
最近のLLMには、推論の過程を長く書き出す「思考モード」が標準で備わるようになりました。推論によって精度は向上しますが、トークン消費とレイテンシも増加します。そのため、「推論は不要なので答えだけを返してほしい」という場面 […]
Agent Skills の改訂がタスク成果とコストに与える影響
Claude Code などのコーディングエージェントでは、プロジェクトの作法を SKILL.md にまとめる使い方が広がっています。Agent Skills(エージェントスキル)と呼ばれるこの仕組みは、コマンドの追加や […]
Context Language Models: コンテキストを直接編集・自己管理するLLMの次世代アーキテクチャ
数十時間にわたって動き続けるAIエージェントを運用していると、精度以前にコンテキストの肥大化という壁にぶつかることがあります。検索結果やツール呼び出しのログ、過去のやり取りが際限なく積み上がり、コンテキストウィンドウの上 […]
Ollama × Jevライクモデルで始める意思決定モデルの活用
ChatGPTをはじめとするLLMは、チャットや文章生成では既に「超人的」と言えるレベルに達しています。しかし、実際の業務システムに目を向けると、「このサポートチケットはどのチームが担当すべきか」「この問い合わせは緊急か […]
JEV-as-a-Judge: 低コスト・高精度なLLM評価の最適戦略
LLMの出力をLLM自身に採点させる「LLM-as-a-Judge」は、プロンプト改善、RAGの検索・生成パイプラインのチューニング、社内ファインチューニング用のデータ選別など、開発サイクルにかなり定着しています。 とこ […]
Tokenizer解体新書: BPEとUnigramの比較から迫るLLM性能の真実
LLMを開発していると、モデルの構造や学習データには注意を払っても、入口にあるトークナイザは「とりあえずBPE」で済ませてしまうことが少なくありません。BPE(Byte-Pair Encoding: バイト対符号化)とU […]

AREX-Skill: GitHubリポジトリからAI研究を加速させる専門知識を蒸留する方法
自律的にコードを書き、実験を回し、結果を比較する「エージェント」が、機械学習研究の現場に入り込み始めています。もっとも、こうしたエージェントを実際に使ってみると、有名なライブラリの使い方を一つ間違えるだけで実験全体が無駄 […]
ASI-Bench: 科学的超知能への道のりと自理性の壁
LLMエージェントがコーディングやデータ分析、長時間にわたるタスク遂行など、様々なベンチマークで高いスコアを記録するようになってきました。そうした中で「AIは自律的に科学研究を進められるのか」という問いは、研究の場だけで […]
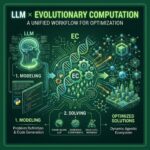
進化計算×LLM: モデリングから求解までの統合ワークフロー
大規模言語モデル(LLM: Large Language Model)を業務の意思決定に組み込もうとすると、「スケジューリングやリソース配分のような組合せ最適化問題に、LLMをどこまで使えるのか」という疑問にぶつかります […]
Strong-to-Weak Scaffolding: パラメータ更新なしで弱いモデルを鍛える推論時ハーネス設計
LLM(大規模言語モデル)を使ったエージェントシステムの実運用が広がるにつれて、コストの観点から小型・安価なモデルをどう活用するかが現実的な課題になっています。大型モデルに匹敵する性能を小型モデルに持たせる代表的な方法は […]