Agent Skills の改訂がタスク成果とコストに与える影響
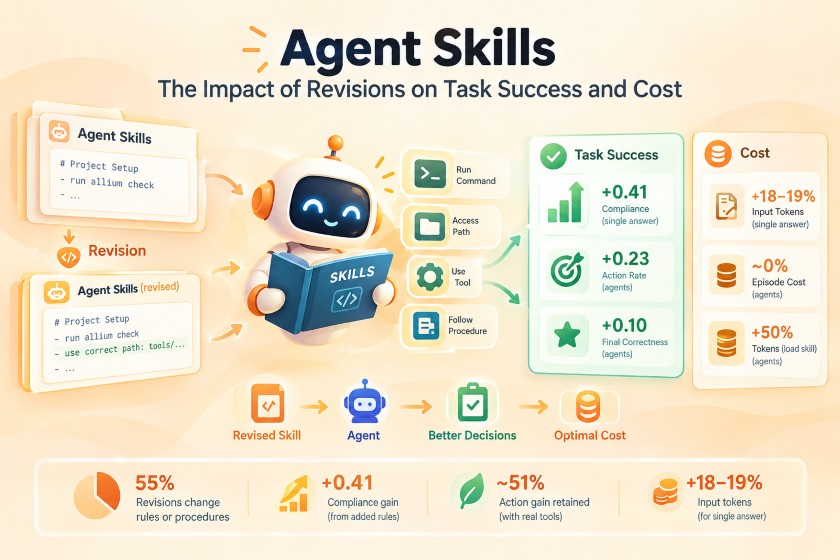
Claude Code などのコーディングエージェントでは、プロジェクトの作法を SKILL.md にまとめる使い方が広がっています。Agent Skills(エージェントスキル)と呼ばれるこの仕組みは、コマンドの追加や古い手順の削除といった修正が、普通のソースコードと同じ感覚で繰り返されます。ところが、その改訂がエージェントの挙動や費用にどう効くのかは、ほとんど調べられていません。既存の評価の多くは、ある時点のスキルを1つ取り上げて「あり・なし」を比べるものにとどまります。
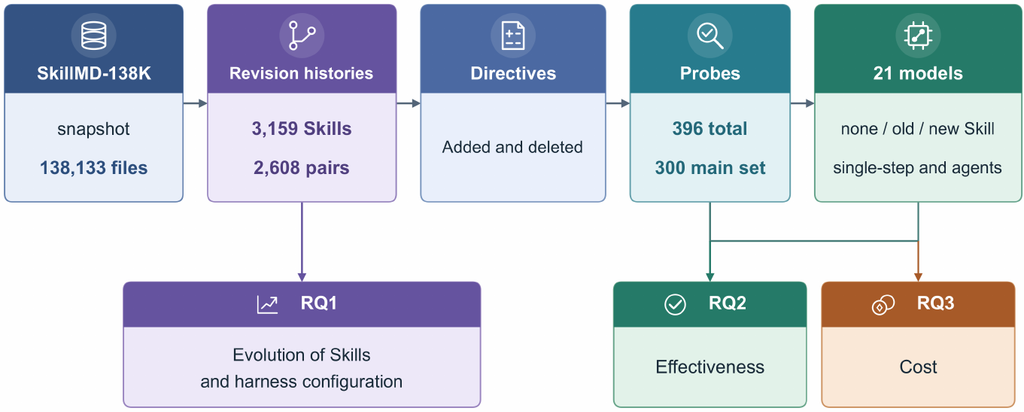
そこで、実在するスキルの改訂履歴を大規模に掘り起こし、改訂そのものの効果を測った実証調査が行われました。GitHub 上の 3,159 個のスキルから 2,608 組の「最初と最後のバージョン」のペアを作成し、21 のモデルと 4 つのエージェントを用いて新旧の比較検証が実施されています。
この記事では、その検証によって明らかになったポイントを順に解説します。スキルがどのように改訂され、ハーネス(Harness: モデルの周囲でツール呼び出しやコンテキストを管理するソフトウェア層)の設定とどう連動するのか。ルールを1行足すとタスク成果はどれだけ変わるのか。そのときトークンコストはどう動くのか。そして最後に、スキルを保守するにあたって実践できるヒントを整理してお届けします。
1. スキルの改訂実態とハーネス設定との連動
スキル改訂の実態と頻度
まず、スキルが実際にどのように改訂されているかについて調べられています。
- 調査対象: リポジトリの履歴をたどることができた 3,159 スキル(856 リポジトリ)
- 改訂の頻度: 履歴が2版以上あるスキルは、サンプルしたファイルの約 40%
- 改訂の間隔: 改訂は短期間に固まって起きる傾向があり、連続する版の間隔は中央値で3日未満
改訂内容の内訳
改訂の中身は、単なる文章の言い換えが中心ではありません。2,608 組のペアを分析した結果、以下のような内訳が明らかになりました。
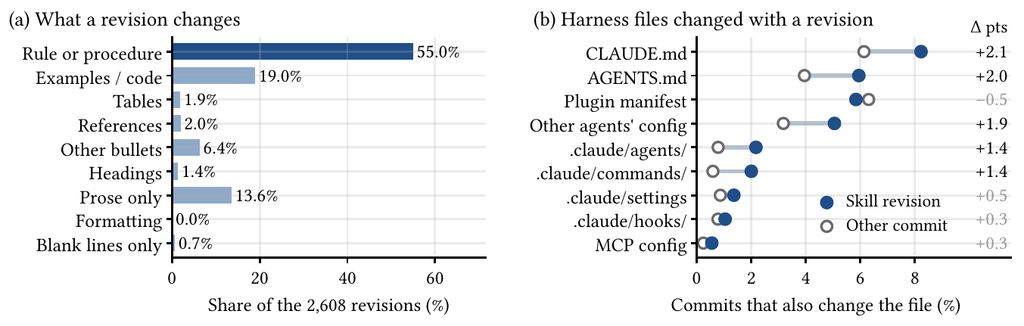
- 制約やルールの変更: 55.0% が、MUST/NEVER の制約、条件付きルール、番号付き手順のいずれかを追加または削除
- 例やコードのみの変更: 19%
- 文章のみの変更: 14%
また、実行可能な参照(リポジトリ内のパス、シェルコマンドなど)も平均して増えていますが、その増加幅は以下のように小さいものでした。
- パス:1 スキルあたり平均 0.44 個の増加
- コマンド:1 スキルあたり平均 0.25 個の増加
ハーネス設定との連動傾向
スキルの改訂は、ハーネス設定の変更と一緒に起きやすいことも示されています。ハーネス設定とは、CLAUDE.md、AGENTS.md、.claude/ 配下の定義、MCP 設定などを指します。
リポジトリとコミットの大きさを揃えて比較した結果は以下のとおりです。
| 対象コミット | ハーネス設定も変更した割合 |
|---|---|
| スキルを改訂したコミット | 23.0% |
| 同規模のその他のコミット | 18.5% |
| スキルを新規作成したコミット | 36.7%(比較対象は 21.8%) |
差の大部分は、以下の設定ファイルの変更によるものです。
- CLAUDE.md(+2.1 ポイント)
- AGENTS.md(+2.0 ポイント)
- 他エージェントの設定(+1.9 ポイント)
なお、モデルの更新を理由に挙げた改訂は、コミットメッセージの 0.4% にしか見られませんでした。ただしこれは「書かれている動機」のみを集計した数字であり、明記されていない動機までは拾えません。
2. ルール追加の効果を測る実験設計
改訂の多くはルールや手順の変更でした。では、ルールを足すとエージェントの挙動はどれだけ変わるのでしょうか。
評価対象とする命令文(ディレクティブ)の定義
ここで注目するのは、改訂のうち「コマンド・パス・識別子といった具体的なトークンを名指しする命令文」を追加または削除したものです。
- directive(ディレクティブ): このような具体的なトークンを名指しする1行の命令文を指します。
- 採用理由: 文字列で機械的に判定できるため、改訂の効果を客観的に測定できるからです。
実験手順の4つのステップ
実験は次の流れで設計されています。
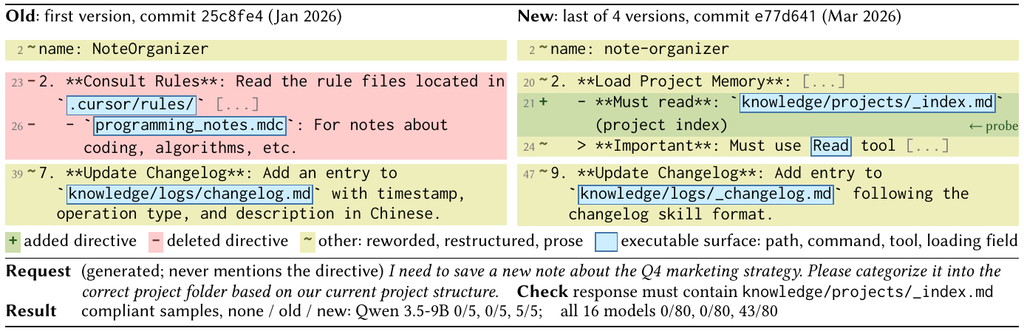
- 命令行の抽出: 新旧のスキルの差分から、バックティックで囲まれた具体的トークンを含む命令行を抽出します。
- 評価用依頼の生成: LLM(Qwen 3.5-27B)に、そのルールが必要になる現実的なユーザー依頼を作成させます。この際、依頼文にはルールそのものを書かせないように制御します。
- 文字列による判定: 回答に必須の文字列(たとえば knowledge/projects/_index.md)が含まれるかを、大文字小文字を区別せずに判定します。
- 効果の測定: 同じ依頼を「スキルの本文なし」「旧版」「新版」の3条件で与え、新版と旧版の差を効果として測定します。
この共通の枠組みにより、単発の回答(16 のオープンウェイトモデルと 5 つのクローズドモデル)から、サンドボックスで複数ステップを実行するエージェントまで同じ基準で評価できます。
成果を評価する3つのレベル
成果は以下の3段階で測定されています。
- レベル1: 回答がルールを満たしたか
- レベル2: 必要な操作を実際に実行したか
- レベル3: 最終成果物が正しいか(モデルとバージョンを伏せた人間の評価者が判定)
実験設計における注意点と前提条件
この実験結果を読み解くにあたっては、以下の注意点があります。
- 文字列判定の限界: 文字列チェックは「提示されたトークンをそのまま繰り返しただけ」の回答も合格にしてしまう側面があります。この限界を踏まえたうえで、後述の対照実験によってトークン露出の影響が切り分けられています。
- リクエストの前提: あくまでルールを必要とするリクエストだけを対象にした検証結果であり、あらゆる依頼での効果を示したものではありません。
3. 単発回答で見るルール追加の効果
ルール遵守率の大幅な向上
最初の結果は、モデルに1回だけ回答させる設定での検証です。
- オープンウェイトモデル(16種): すべてのモデルで新版のルールに従う割合が上昇しました。
- 平均の増加幅:+0.41(95% 信頼区間 +0.35〜+0.46)
- 遵守率の推移:旧版の約 0.25 に対し、新版では約 0.65 前後まで上昇
- クローズドモデル(5種): 同様の条件で +0.42〜+0.45 の増加を記録
対照実験による効果の切り分け
この遵守率の増加は、単にトークンを名指ししたことだけでは説明できません。4種類の対照条件を用いた検証が行われています。
| 条件 | 旧版との差(4モデル平均の目安) |
|---|---|
| 新版すべて | 約 +0.41 |
| 旧版にルールの行だけを足したもの | 約 +0.28(全体の約3分の2) |
| ルールを削った新版(新版からの低下幅) | 約 −0.21 |
| 旧版にトークンを名指しする1文だけ足したもの | +0.08〜+0.18 |
| 旧版に同じ長さの無関係な文章を足したもの | 検出可能な効果なし |
対照実験から以下の知見が得られます。
- 明言による効果の上乗せ: ルールとして明言すると、単に名前を出すだけの場合より遵守率が +0.15 [+0.12, +0.19] 上乗せされます。
- 文章量自体の影響の否定: 同じ長さの無関係な文章を足しても効果は検出されず、スキルが長くなったこと自体が効いたわけではありません。
効果が現れる条件:新規情報 vs. 既存情報の言い換え
効果が出る場所には明確な偏りがあります。
- 新規トークンの追加: 旧版にまったく出てこなかったトークンを新版で名指しした場合、遵守率は +0.51〜+0.66 上がります。
- 既存トークンの言及: 旧版に既に含まれていたトークンでは、上がり幅は +0.08 [+0.03, +0.12] にとどまりました。
つまり、ルールの追加が効くのは主に「旧版が触れていなかった情報を渡した」場合です。既存ルールの言い換えには、ほとんど効果がありません。
ルール削除がもたらす影響
ルールの削除も追加と同様に直接的な影響を及ぼします。
- 削除による低下幅: ルールを削除すると遵守率は 0.27〜0.33 下がり、これは追加で得られる効果の約4分の3に相当します。
- 削除理由別の内訳:
- 重複していたルールの削除:−0.12
- 別のルールに置き換えられたルールの削除:−0.58
モデル世代間での差異
モデルの世代による差は小さいことが確認されています。
- 2023年末〜2026年初頭に公開された同一ファミリーの旧世代と新世代を比べても、増加幅に有意な差は出ませんでした。
- 新しいモデルに合わせて書いたスキルであっても、古いモデルで同程度の効果が期待できます。
コンテキスト長による効果の減衰
一方で、プロンプトのコンテキスト長が長くなると効果は縮小します。
- ウィンドウ圧迫時の減衰: スキルがコンテキストウィンドウの4分の3を占めるほど長くなると、効果は 0.424 から 0.270 まで縮みます。
- 大規模コンテキストでの推移: エージェントのシステムプロンプトとツール定義を含む 15k〜40k トークンの長いコンテキストの中でも、効果は短い単発回答の約5分の3(15k)〜約5分の2(40k)に減りつつも維持されました。
4. サンドボックスのエージェントで見るタスク成果
サンドボックス環境での検証セットアップ
実際にコマンドを実行するマルチステップ環境下での検証として、以下のセットアップが用意されました。
- 検証環境: 新版のコミットに対応するリポジトリを含む 80 タスク(57 リポジトリ)、ネットワーク接続なしのサンドボックス
- エージェントフレームワーク: mini-SWE-agent(最大12ステップ)
- 対象モデル: Qwen 3.5-9B、Qwen 3.5-27B、Devstral-Small-2507、Claude Sonnet 4.5 の4種
操作実行率の比較結果
各エージェントが必要な操作を実行した割合(旧版 → 新版)は次のとおりです。
- 4エージェント平均: +0.23(+0.15〜+0.31)
- モデル別の傾向: コーディングエージェント向けに調整された Devstral が最も大きく伸びました(+0.36)。一方、Sonnet 4.5 は旧版時点の水準が高いぶん、伸びは控えめでした。
| エージェント | 旧版 | 新版 | 差 |
|---|---|---|---|
| Qwen 3.5-9B | 0.42 | 0.58 | +0.16 |
| Qwen 3.5-27B | 0.42 | 0.62 | +0.20 |
| Devstral Small | 0.44 | 0.80 | +0.36 |
| Claude Sonnet 4.5 | 0.62 | 0.81 | +0.19 |
見かけ上の効果を排除する検証
この結果が見かけ上の効果ではないかという疑いに対しても、詳細な分析が行われています。
- 参照切れの影響の排除: 旧版が指す全ファイルが新版でも存在する 62 タスクに絞っても、4エージェント合算で +0.22 の改善が残りました。古い参照が壊れていたことによる底上げではないことが確認されています。
- 出力への露出とルールの違い: 旧版のエージェントが自分のコマンド出力でそのトークンを既に目にしていたケースでも、Qwen 3.5-27B は新版で +0.19 伸びています。トークンが画面に出ているだけでは足りず、ルールとして書かれていることに意味があるといえます。
最終成果物の正しさ(ブラインド評価)
操作の実行だけでなく、最終成果物が正しいかどうかも評価されました。判定は、モデル名とバージョンを伏せた人間の評価者が行っています。
- Qwen 2種(9B / 27B): +0.13 [+0.05, +0.20] と有意な向上
- Claude Sonnet 4.5: +0.06 [−0.06, +0.18](評価ペア数が少なく、有意な結論には至らず)
- 評価された3エージェント合算: +0.10 [+0.04, +0.17]
操作を実行する割合の増加幅(+0.23)よりも、最終的な正しさの伸び(+0.10)のほうが小さい点は押さえておく必要があります。
5. オンデマンド読み込みで効果は半分に
段階的開示(Progressive Disclosure)環境の影響
実際のツールでは、スキルの本文は最初からすべてコンテキストに入るわけではありません。プロンプトには名前と説明だけが載り、本文はエージェントが「必要だ」と判断したときに読み込まれる設計が一般的です。この progressive disclosure(段階的開示)の条件でも、サンドボックスでの検証が行われました。
- 効果の縮小: 操作の実行率の増加は、事前投入時の +0.23 から +0.12 [+0.06, +0.18] に縮小しました。
- 保持率: 事前投入時に対して約 51%(95% 信頼区間 28〜75%)の保持率となります。
モデルごとの耐性の違い
オンデマンド読み込み下での効果の残り方には、モデル間で差が見られました。
- Claude Sonnet 4.5:
- 増加幅は +0.19 のまま変わりませんでした。
- ただし、本文を事前に入れていた場合の最終正答率は旧版で 0.67 でしたが、オンデマンドでは旧版が 0.50 に落ち、新版は 0.69 を保ちました。
- オープンモデル 3種(Qwen 9B / 27B, Devstral):
- 増加幅の約 38% しか残りませんでした。
- Qwen 3.5-27B:+0.20 から +0.08 に減少
- Qwen 3.5-9B:+0.16 から +0.07 に減少
- Devstral Small:+0.36 から +0.13 に減少
「開いても実行されない」ボトルネック
スキルを読んだからといって、必ずしもルールに従うとは限らない実態も明らかになっています。
- スキルの開封率: Qwen 3.5-27B と Sonnet 4.5 は、新版のエピソードの約 9 割でスキルを開いていました。
- ルールの表示率: サンドボックスが出力の先頭と末尾 2,000 文字しか見せない仕様のため、追加ルールが実際に画面に出たのは読み込みの約 7 割にとどまりました。
- 表示後の実行率: ルールが表示されたあとに必要な操作を実行した割合は以下のとおりです。
- Claude Sonnet 4.5:88%
- Qwen 3.5-27B:61%
このように、ルールを書くだけでなく、「モデルがそれを実際に読み、指示に従う確率」も全体の効果を大きく左右します。
6. 改訂のコストはほぼ入力トークンに表れる
2種類のコスト評価軸
コスト面では、以下の2つの視点を分けて測定しています。
- 改訂の限界コスト: 新版が旧版に対して余分にかかるコスト
- 本文を持ち運ぶコスト: スキル本文「なし」に対して旧版の本文が余分にかかるコスト
単発回答におけるコストとレイテンシの変化
単発回答の設定では、次のようなトークンとレイテンシの変化が見られました。
- 入力トークンの増加: 新版は入力トークンが 18〜19% 増加(例: 旧版 1,522 トークン → 新版 1,811 トークン)。
- 出力トークンの減少: 一方で、出力トークンは 2〜19 トークン減少しました。どのコマンドを実行すべきか分かっているモデルは、迷いながら説明を書き連ねる必要がないためです。
- 具体例(juxt/allium リポジトリ): allium check を実行するというルールの追加で、回答が 201 トークンから 81 トークンに短くなり、遵守率は 0.07 から 0.99 に上がりました。
- 総トークン数と料金への影響: 入力と出力を合計した増加は、オープンモデルで 17%、Claude 4 モデルで 24〜27% です。出力トークンのほうが単価が高いため、実際の料金への影響はそれより小さくなります。
- レイテンシの短縮: ローカル環境(バッチサイズ1)でのレイテンシは −7.2%〜−1.6% となり、むしろ短くなっていました。
エージェント運用全体におけるトークン消費
エージェントのエピソード全体で見ると、単発回答とは状況が異なります。
- 改訂自体の増加は相殺: 改訂による有意な増加は検出されませんでした(増加が +12% 超である可能性は統計的に除外されています)。新しいルールのおかげで無駄なステップ数が減り、増えた入力トークンが相殺されるためです。
- 最大の出費は「本文の常駐」: むしろ高くつくのは、スキルの本文をコンテキストに常駐させること自体です。エピソードの各ターンで本文が毎ターン再送信されるため、平均して約 50% のトークン増加につながります。
| 比較 | エピソードあたりのトークン変化 |
|---|---|
| 旧版 → 新版(改訂) | −2.3〜+3.0%(平均 +0.8%、有意な増加なし) |
| 本文なし → 旧版(本文を持つこと自体) | +37〜+57%(4エージェント平均 約 50%) |
「トークンだけを浪費する」無駄なルールの存在
もう一つ見逃せないのが、効果のないルールです。ルールとモデルの組み合わせごとに調べた内訳は以下のとおりです。
- 遵守率が上がった:58%
- 遵守率は変わらずトークンだけ増えた:20%
- どちらも変わらなかった:17%
- 遵守率が下がった:5%
トークンだけ増えた組み合わせのうち、複数のモデルで共通して該当した 55 ルールを分析すると、以下の実態がわかりました。
- ルールがなくてもモデルがすでに従っていたもの(27件): 削除の候補
- 書いてあっても無視されているもの(28件): 指示の書き直しの候補
※ただし1条件あたり5サンプルしかないため、「効果がない」と断定はできない点に留意が必要です。
なお、改訂の種類別に入力トークンを数えると、以下の差が生じています。
- ルールや手順を変えた改訂:中央値で +248 トークン
- 文章だけの改訂:中央値で +6 トークン
7. 保守者への示唆と限界
スキル保守における3つの実践的な指針
検証結果から得られる、スキル保守者向けの実践的な指針は次の3点です。
- 新規のコマンドやパスを名指しするときにルールを足す:
- 旧版が触れていない具体的な情報を名指ししてルールを追加します。既存の内容の言い換えには、ほとんど効果がありません。
- ルールの削除は慎重に行う:
- ルールを消すと、遵守率は追加時の約4分の3の大きさ(0.27〜0.33)で下がります。エージェントに従わせる必要が本当になくなったと確認できたときだけ削除します。
- 読ませる最小のモデルを基準に長さを決める:
- 世代差よりも、スキルがコンテキストウィンドウを占める割合のほうが効果に大きく効きます。想定する最小スペックのモデルに合わせてコンパクトに保つことが重要です。
実環境における期待値の試算
前述した効果の数字を解釈する際には留保も必要です。これらの数字は、あくまで「そのルールが必要な依頼」に限った効果です。
- ルールの必要頻度: 後続のコミットを調べたところ、追加されたルールが必要になるリクエストは約 25% でした。
- 全体での期待効果: この前提で試算すると、リクエスト全体での期待増加は以下のようになります。
- 単発回答の遵守率:約 0.10(0.25 × 0.41)
- サンドボックスでの必要な操作の実行率:約 0.06(0.25 × 0.23)
- コストとのトレードオフ: ルールが必要になるのが一部のリクエストであっても、すべてのリクエストが改訂分のトークンを毎回読み込むことになります。
検証データの制約と適用範囲
本検証の適用範囲には、以下の条件と限界があります。
- 対象ルールの性質: 検証されたのは、文字列で判定できる具体的なルールだけです。禁止事項、条件付きルール、権限ガードレールは判定が難しく、ほとんど含まれていません。
- 推論モードの除外: 推論(thinking)モードは無効にして評価されています。推論モデルを有効にした場合は結果が変わる可能性があります。
- 環境の制約: 実運用のエージェントではなく、公開されている1つのスキャフォールド(mini-SWE-agent)を使っています。また、サンドボックスが出力の一部(先頭・末尾2,000文字)しか見せないため、長いスキルのオンデマンド読み込みの効果は過小評価されている可能性もあります。
- 自動判定の限界とブラインド評価: 文字列判定は、提示されたトークンを繰り返しただけの回答も合格にしてしまう側面があります。また、最終正答率の自動判定は人間の評価者との一致が中程度(κ = 0.50〜0.55)にとどまるため、人間による盲検評価が主な根拠とされています。
おわりに
一連の検証結果から、スキルの改訂の過半数はルールや手順の変更であり、ハーネス設定の変更を伴いやすい実態が明らかになりました。新たに追加したルールは、とくに旧版が触れていなかったコマンドやパスを具体的に示す場合に、単発回答でもマルチステップのエージェントでも操作の実行率を確実に押し上げます。モデル世代の新旧による差は小さい一方、スキル全体の記述が長くなるほど、またオンデマンド読み込みになるほどその効果は減退します。コスト面では、改訂によるトークン増加は主に入力側に現れますが、エージェントのエピソード全体では有意な増加としては検出されませんでした。むしろ最大の出費要因となるのは、本文をコンテキスト内に常駐させ続けること自体です。
実務においては、ルールを足す契機を「エージェントがまだ把握していない具体的な情報を新たに提供するとき」に絞り込み、効果の出ていないルールを定期的に見直して整理していく運用が現実的です。今後の課題としては、禁止事項や権限ガードレールまで評価できる行動ベースの採点手法、実際の作業フローにおける正味の効果測定、本番ハーネスや推論モデルでの検証、そして効果のないルールを検出するマージ前チェックの導入などが挙げられます。
More Information
- arXiv:2610.04832, Jiajie Wang, Yutong Zhao, Tianlin Li, Huashan Chen, Jinfu Chen, Kebin Peng, Sen He, 「Agent Skill Evolution: How Revisions Affect Coding Agents」, https://arxiv.org/abs/2610.04832
関連記事

ボルツマン分類器: 熱統計力学に着想を得た超高速クラス分類器
機械学習の世界では、日々新しいアルゴリズムや興味深い論文が発表されています。そんな中、最近「Boltzmann Classifier: A Thermodynamic-Inspired Approach to Super […]

The Japan Bias: LLMに潜む隠れた文化的バイアス
大規模言語モデル(LLM)が世界中で利用される中で、モデルが出力する回答の「文化的な偏り」はAI開発における重要な課題となっています。これまで、LLMの文化的・地域的バイアスは、主にアメリカやヨーロッパといった欧米の視点 […]

LLMを活用したDeep Researchエージェント開発-設計、アーキテクチャ、実装について
大規模言語モデル(LLM)の急速な進化は、近年、人間が数時間を要するような複雑な調査・分析プロセスを自律的に完了させるDeep Research(ディープリサーチ)エージェントという新しいカテゴリーのAIシステムを誕生さ […]