MAPIEではじめるコンフォーマル予測入門
機械学習モデルを業務に組み込もうとすると、「この予測はどのくらい信用していいのか」を必ず聞かれます。売上予測が 120 だったとして、それが 100〜140 の間に収まりそうなのか、50〜190 くらいまで振れうるのかで、取るべきアクションはまるで違います。分類でも事情は同じで、「確率 0.7 で猫」と出ても、その 0.7 が本当に 7 割の確からしさを表しているとは限りません。
以前このブログでは、NGBoost や XGBoostLSS を使って、予測分布そのものを推定する方法を紹介しました。強力なアプローチですが、正規分布やガンマ分布といった分布の形を仮定する必要があり、その仮定が外れると区間の信頼性も崩れてしまいます。
そこで今回取り上げるのがコンフォーマル予測(Conformal Prediction)です。分布の形を仮定せず、どんなモデルにも後付けでき、しかも「90% の区間なら本当に 90% の確率で正解を含む」という有限サンプルでの保証が付きます。本記事では、これを scikit-learn 互換の API で手軽に使える Python ライブラリ MAPIE を使って、回帰・分類・時系列・リスク制御・キャリブレーションの 5 つのユースケースを実装しながら解説します。
コンフォーマル予測の基礎
非適合度スコアと分位点
コンフォーマル予測の手順は驚くほど単純です。回帰を例に説明します。
- データを 学習用(train)、キャリブレーション用(conformalize)、テスト用(test) の 3 つに分けます。
- 学習用データでモデル \(\hat{f}\) を学習します。
- キャリブレーション用データの各サンプルについて、非適合度スコア(conformity score) を計算します。もっとも基本的なスコアは絶対残差 \(s_i = |y_i – \hat{f}(x_i)|\) です。
- スコア \(s_1, \dots, s_n\) の \(\lceil (n+1)(1-\alpha) \rceil / n\) 分位点 \(\hat{q}\) を求めます。
- 新しい入力 \(x\) に対しては、\([\hat{f}(x) – \hat{q},\ \hat{f}(x) + \hat{q}]\) を予測区間とします。
要するに「キャリブレーションデータで、モデルがどのくらい外したか」を集計し、その分布の上位 \(\alpha\) を切り取った幅を区間にしている、というだけの話です。分類の場合も考え方は同じで、たとえばスコアを \(1 – \hat{p}_{y}(x)\)(正解クラスの予測確率を 1 から引いたもの)とすれば、しきい値 \(\hat{q}\) 以下のスコアになるクラスをすべて集めたものが予測集合になります。
周辺カバレッジ保証
この単純な手続きから、次の保証が得られます。
$$P\left(Y_{n+1} \in C(X_{n+1})\right) \geq 1 – \alpha$$
ここで \(C(x)\) は予測区間(または予測集合)です。この保証が成り立つための条件は、データが交換可能(exchangeable) であること、つまりデータの並び順を入れ替えても同時分布が変わらないことだけです。i.i.d. であれば交換可能なので、多くの表形式データではこの前提を満たします。モデルが線形回帰でも勾配ブースティングでもニューラルネットでも、データの分布が正規でも裾が重くても、保証はそのまま成り立ちます。
ただし、注意点が 2 つあります。
- 周辺(marginal)カバレッジの保証であること。データ全体で平均して \(1-\alpha\) を満たすという意味であり、特定の \(x\) の近くで \(1-\alpha\) を満たす(条件付きカバレッジ)ことまでは保証しません。後述する回帰の例で、この違いがはっきり現れます。
- 区間が狭いかどうかは保証しないこと。モデルの精度が悪ければ区間は広くなります。保証されるのはあくまで「外さない確率」です。
MAPIEの概要
MAPIE(Model Agnostic Prediction Interval Estimator)は scikit-learn-contrib 傘下のライブラリで、scikit-learn 互換の推定器であれば何にでもコンフォーマル予測を適用できます。インストールは pip で済みます。
$ pip install mapie主なモジュールと機能を表にまとめます。
| モジュール | 主なクラス・関数 | 用途 |
|---|---|---|
mapie.regression | SplitConformalRegressor, CrossConformalRegressor, JackknifeAfterBootstrapRegressor, ConformalizedQuantileRegressor, TimeSeriesRegressor | 回帰の予測区間 |
mapie.classification | SplitConformalClassifier, CrossConformalClassifier | 分類の予測集合 |
mapie.conformity_scores | AbsoluteConformityScore, GammaConformityScore, LACConformityScore, APSConformityScore, RAPSConformityScore など | 非適合度スコア |
mapie.risk_control | BinaryClassificationController, MultiLabelClassificationController など | 適合率・再現率などのリスク制御 |
mapie.calibration | TopLabelCalibrator, VennAbersCalibrator | 予測確率のキャリブレーション |
mapie.metrics | regression_coverage_score, classification_mean_width_score など | カバレッジ・区間幅などの評価 |
mapie.conditional_conformal_prediction | ConditionalSplitConformalRegressor など | 条件付きカバレッジ保証 |
mapie.exchangeability_testing | FixedDatasetExchangeabilityTest, OnlineMartingaleTest など | 交換可能性の検定 |
v1 系の API の基本形
v1.0 で API が整理され、以下の 3 ステップが基本形になりました。
from mapie.regression import SplitConformalRegressor

mapie = SplitConformalRegressor(estimator=model, confidence_level=0.9, prefit=False)
mapie.fit(X_train, y_train)                      # 1. モデルを学習
mapie.conformalize(X_conformalize, y_conformalize)  # 2. 非適合度スコアを計算
y_pred, y_pis = mapie.predict_interval(X_test)   # 3. 予測区間を出力
旧バージョン(0.x)との主な違いは次のとおりです。
alphaの代わりにconfidence_level(\(=1-\alpha\))をコンストラクタで指定する- 分割系の手法は
fit()とconformalize()が分離され、交差検証系の手法はfit_conformalize()で一度に処理する - 区間は
predict_interval()、集合はpredict_set()で取得する(predict()は点予測のみを返す) prefit=True(デフォルト)にすると学習済みモデルをそのまま渡せ、fit()を省略してconformalize()から始められる
predict_interval() が返す区間は形状 (n_samples, 2, n_confidence_levels) の配列で、[:, 0, k] が下限、[:, 1, k] が上限です。confidence_level にリストを渡すと、複数の信頼水準を一度に計算できます。
MAPIEで使える主なアルゴリズム
コードに入る前に、MAPIE に実装されている代表的な手法を概観しておきます。
回帰
非適合度スコアも差し替えられます。"absolute"(\(|y-\hat{y}|\)、全サンプルで同じ幅)のほかに、"gamma"(\(|y-\hat{y}|/\hat{y}\)、予測値に比例した幅)や "residual_normalized"(残差の大きさを別モデルで推定して正規化)が用意されています。
| 手法 | MAPIE のクラス | 概要 |
|---|---|---|
| Split CP | SplitConformalRegressor | 前節で説明した基本形。学習と較正でデータを分けるので計算は速いが、学習に使えるデータが減る |
| CV+ / Jackknife+ | CrossConformalRegressor | K-fold で学習した K 個のモデルの out-of-fold 残差を使う。データを無駄にしないが K 回学習が必要 |
| Jackknife+-after-Bootstrap | JackknifeAfterBootstrapRegressor | ブートストラップで作ったモデル群の OOB 残差を使う。アンサンブルと相性が良い |
| CQR | ConformalizedQuantileRegressor | 分位点回帰で上下の境界を予測し、その誤差をコンフォーマル補正する。入力によってノイズの大きさが違う(不均一分散)データに強い |
分類
| スコア | 概要 | 特徴 |
|---|---|---|
| LAC | \(1-\hat{p}_y(x)\) | 平均集合サイズが最小になる。ただし簡単なサンプルにも難しいサンプルにも同じしきい値を使うので適応性は低い |
| APS | 確率の高い順にクラスを並べ、正解クラスまでの累積確率 | 難しいサンプルほど集合が大きくなる(適応的) |
| RAPS | APS に、順位が一定以上のクラスへのペナルティを加えたもの | クラス数が多いときに APS の集合が膨らみすぎるのを抑える |
| Top-K | 正解クラスの順位 | 全サンプルで同じサイズの集合になる |
時系列
時系列データは自己相関や分布シフトがあるため、交換可能性の前提が崩れます。MAPIE の TimeSeriesRegressor は次の 2 つの手法を提供しています。
- EnbPI(Ensemble batch Prediction Intervals): ブロックブートストラップで作ったアンサンブルの OOB 残差を使い、新しい観測が入るたびに残差を入れ替えて分布の変化に追従する
- ACI(Adaptive Conformal Inference): 区間が外れたら \(\alpha_t\) を小さくして区間を広げ、当たったら少し狭める、というオンライン更新 \(\alpha_{t+1} = \alpha_t + \gamma(\alpha – \mathrm{err}_t)\) を行う。長期的な平均カバレッジが目標値に収束する
リスク制御とキャリブレーション
コンフォーマル予測の考え方は「正解を含む確率」以外の指標にも拡張できます。Learn Then Test(LTT) は、しきい値の候補ごとに「リスクが目標を超えている」という帰無仮説を検定し、多重検定の補正をかけたうえで棄却できたしきい値だけを採用する手法です。これにより「適合率 0.9 以上を信頼度 90% で保証するしきい値」のような、業務要件に直結した保証が得られます。
また、MAPIE には予測確率そのものを補正するキャリブレーション機能もあります。特に Venn-Abers 予測器は、「ラベルが 0 だったら」「1 だったら」の 2 通りで等調回帰(isotonic regression)を行い、確率の区間 \([p_0, p_1]\) を得るという、コンフォーマル予測と同じ系譜の手法です。
Pythonによる実践
ここからは、5 つのユースケースについてコードを動かしながら見ていきます。環境構築には uv を使いました。
$ uv init samples --python 3.12
$ cd samples
$ uv add mapie scikit-learn matplotlib pandas
ユースケース1: 回帰の予測区間(Split / CV+ / CQR)
まずは基本の回帰です。\(x\) が大きいほどノイズが大きくなる、不均一分散の人工データを用意します。
from mapie.regression import (
    ConformalizedQuantileRegressor,
    CrossConformalRegressor,
    SplitConformalRegressor,
)
from mapie.utils import train_conformalize_test_split

RANDOM_STATE = 42
CONFIDENCE_LEVEL = 0.9


# --- 1. データ生成: x が大きいほどノイズが大きくなる (不均一分散) ---
def make_data(n_samples: int, rng: np.random.Generator):
    x = rng.uniform(0, 5, n_samples)
    noise = rng.normal(0, 0.2 + 0.4 * x)
    y = x * np.sin(x) + noise
    return x.reshape(-1, 1), y


rng = np.random.default_rng(RANDOM_STATE)
X, y = make_data(3000, rng)

(
    X_train, X_conformalize, X_test,
    y_train, y_conformalize, y_test,
) = train_conformalize_test_split(
    X, y,
    train_size=0.6, conformalize_size=0.2, test_size=0.2,
    random_state=RANDOM_STATE,
)
train_conformalize_test_split は、データを学習・較正・テストの 3 つに分割する MAPIE のユーティリティです。公式ドキュメントでは、較正用データを少なくとも 200 件程度確保することが推奨されています。
続いて、3 つの手法で予測区間を作ります。
base_model = GradientBoostingRegressor(
    n_estimators=200, max_depth=3, min_samples_leaf=30, random_state=RANDOM_STATE
)

# --- 2. Split Conformal: fit -> conformalize -> predict_interval ---
split_reg = SplitConformalRegressor(
    estimator=base_model,
    confidence_level=CONFIDENCE_LEVEL,
    conformity_score="absolute",
    prefit=False,
)
split_reg.fit(X_train, y_train)
split_reg.conformalize(X_conformalize, y_conformalize)
y_pred_split, y_pis_split = split_reg.predict_interval(X_test)

# --- 3. Cross Conformal (CV+): 学習用と conformalize 用をまとめて渡す ---
X_train_full = np.vstack([X_train, X_conformalize])
y_train_full = np.concatenate([y_train, y_conformalize])

cv_reg = CrossConformalRegressor(
    estimator=base_model,
    confidence_level=CONFIDENCE_LEVEL,
    method="plus",
    cv=5,
    random_state=RANDOM_STATE,
)
cv_reg.fit_conformalize(X_train_full, y_train_full)
y_pred_cv, y_pis_cv = cv_reg.predict_interval(X_test)

# --- 4. Conformalized Quantile Regression ---
cqr = ConformalizedQuantileRegressor(
    estimator=GradientBoostingRegressor(
        loss="quantile", n_estimators=200, max_depth=3, min_samples_leaf=30,
        random_state=RANDOM_STATE,
    ),
    confidence_level=CONFIDENCE_LEVEL,
)
cqr.fit(X_train, y_train)
cqr.conformalize(X_conformalize, y_conformalize)
y_pred_cqr, y_pis_cqr = cqr.predict_interval(X_test)
SplitConformalRegressor は prefit=False にしておくと、fit() でモデルの学習まで MAPIE がやってくれます。CrossConformalRegressor は交差検証で out-of-fold 残差を計算するので、較正用データを分ける必要がなく、fit_conformalize() に全データをそのまま渡します。ConformalizedQuantileRegressor は分位点損失のモデルを 1 つ渡すだけ。下側・上側・中央の 3 つの分位点モデルは内部で学習されます。
評価には mapie.metrics.regression の関数を使います。全体のカバレッジに加えて、\(x\) の範囲を 3 分割して範囲ごとのカバレッジも計算してみます。
from mapie.metrics.regression import (
    regression_coverage_score,
    regression_mean_width_score,
)

# x の範囲ごとのカバレッジ (条件付きカバレッジの目安)
x_bins = [(0.0, 5 / 3), (5 / 3, 10 / 3), (10 / 3, 5.0)]
for name, pis in results.items():
    cov = regression_coverage_score(y_test, pis)[0]
    width = regression_mean_width_score(pis)[0]
    cov_by_x = []
    for lo, hi in x_bins:
        mask = (X_test[:, 0] >= lo) & (X_test[:, 0] < hi)
        cov_by_x.append(regression_coverage_score(y_test[mask], pis[mask])[0])
結果は次のとおりです。
target coverage = 0.9
method              coverage   width   coverage by x (low / mid / high)
Split (absolute)       0.902   4.518   0.995 / 0.941 / 0.744
CV+                    0.910   4.634   0.995 / 0.961 / 0.750
CQR                    0.908   3.988   0.935 / 0.897 / 0.889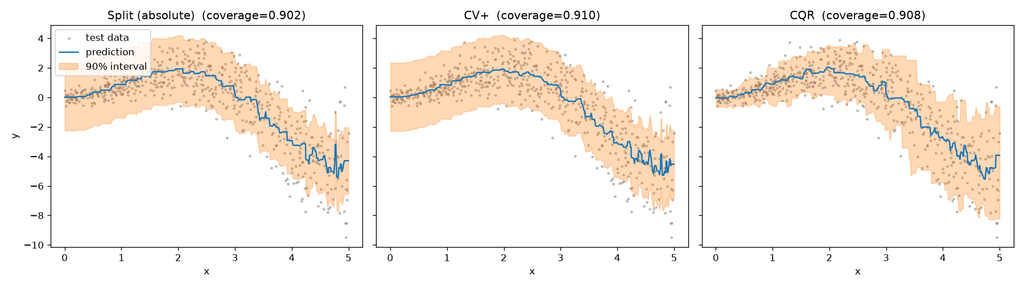
3 つの手法とも、全体のカバレッジは目標の 0.9 を満たしています。これがコンフォーマル予測の保証です。
ところが、\(x\) の範囲ごとに見ると様子が違います。Split と CV+ は絶対残差スコアを使うため、区間幅が全域でほぼ一定です。その結果、ノイズの小さい左側では区間が広すぎ(カバレッジ 0.995)、ノイズの大きい右側では狭すぎます(0.744)。周辺カバレッジは満たしていても、条件付きカバレッジは満たしていない典型例です。
CQR は分位点回帰で入力ごとの幅を学習するので、どの範囲でもカバレッジが 0.89〜0.94 に揃い、平均幅も最も狭くなりました。全体のカバレッジだけ見ていたら、この差には気づけません。不均一分散が疑われるデータなら、個人的にはまず CQR から試します(conformity_score="residual_normalized" も選択肢です)。
なお、confidence_level にはリストも渡せます。
multi_reg = SplitConformalRegressor(
    estimator=base_model,
    confidence_level=[0.5, 0.8, 0.95],
    prefit=False,
)
multi_reg.fit(X_train, y_train).conformalize(X_conformalize, y_conformalize)
_, y_pis_multi = multi_reg.predict_interval(X_test)
multi confidence levels: (600, 2, 3)
coverage: [0.52  0.823 0.953]
width   : [1.438 3.32  5.814]
区間の配列は (600, 2, 3) となり、各信頼水準に対応するカバレッジが得られています。
ユースケース2: 分類の予測集合(LAC / APS / RAPS)
次は分類です。クラス同士が重なり合う 6 クラス分類の人工データを作り、ランダムフォレストを学習させます。今回は学習済みモデルを prefit=True で渡すパターンを使います。既存のモデルに後から不確実性を付け足したい場合は、この使い方が便利です。
from mapie.classification import SplitConformalClassifier

# --- 2. 学習済みモデルを用意 (prefit=True で使う) ---
clf = RandomForestClassifier(n_estimators=300, random_state=RANDOM_STATE)
clf.fit(X_train, y_train)
print(f"accuracy of base model: {clf.score(X_test, y_test):.3f}\n")

# --- 3. 非適合度スコアを変えて予測集合を作る ---
settings = {
    "lac": ("lac", None),
    "aps": ("aps", None),
    "aps-rand": ("aps", {"include_last_label": "randomized"}),
    "raps-rand": ("raps", {"include_last_label": "randomized"}),
}
pred_sets = {}
for name, (score, score_params) in settings.items():
    mapie_clf = SplitConformalClassifier(
        estimator=clf,
        confidence_level=CONFIDENCE_LEVEL,
        conformity_score=score,
        prefit=True,
        random_state=RANDOM_STATE,
    )
    mapie_clf.conformalize(X_conformalize, y_conformalize)
    y_pred, y_pred_set = mapie_clf.predict_set(X_test, conformity_score_params=score_params)
    pred_sets[name] = y_pred_set[:, :, 0]  # (n_samples, n_classes)
predict_set() は点予測と予測集合のタプルを返します。予測集合は形状 (n_samples, n_classes, n_confidence_levels) の bool 配列で、True のクラスが集合に含まれます。APS と RAPS では、conformity_score_params で include_last_label を指定できます。デフォルトの True は、累積確率がしきい値を超えたクラスまで集合に含める保守的な設定です。"randomized" にすると、最後のクラスを確率的に含めるかどうか決めるので、カバレッジが目標値に近づきます。
accuracy of base model: 0.857

target coverage = 0.9
score       coverage  mean size     SSC   empty
lac            0.892      1.097   0.000   0.011
aps            0.966      1.923   0.960   0.000
aps-rand       0.891      1.543   0.000   0.059
raps-rand      0.881      1.431   0.000   0.059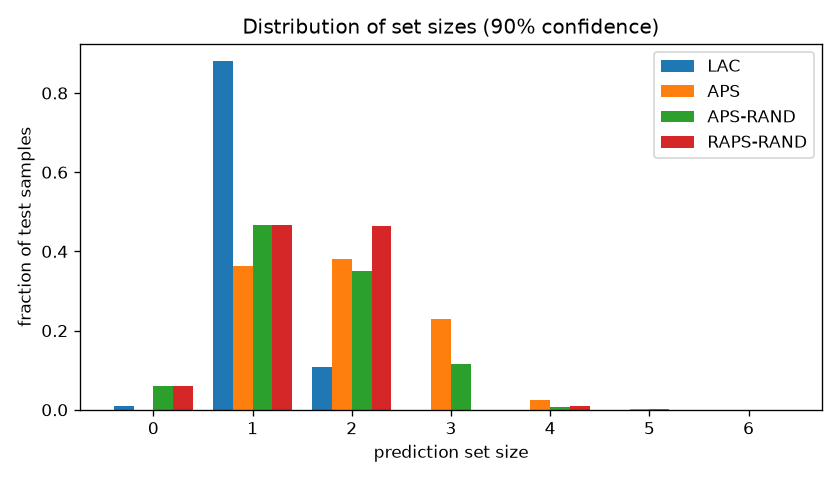
各スコアの特徴がよく表れています。
- LAC は平均集合サイズが 1.10 と最も小さく、9 割近くのサンプルでクラスを 1 つに絞り込めています。その代わり、どのクラスの確率も低いサンプルでは空集合(サイズ 0)が出ます。
- APS(デフォルト)は集合が大きく、カバレッジは 0.966 と目標をかなり上回っています。
include_last_label=Trueの保守性によるものです。 - APS / RAPS(randomized) はカバレッジが目標付近に収まり、集合サイズも抑えられます。ただし、ランダム化の副作用として空集合も出るようになります。RAPS はクラス数が多い(ImageNet のような)場面で真価を発揮する手法なので、6 クラス程度では APS との差は小さめです。
表の SSC(Size-Stratified Coverage)は、集合サイズごとにカバレッジを計算し、その最小値をとった指標です(classification_ssc_score)。条件付きカバレッジの目安になります。LAC や randomized 版が 0 になっているのは、空集合のビンのカバレッジが当然 0 になるためです。
実務で面白いのは、予測集合のサイズを「モデルの迷い度」として使える点です。LAC の集合サイズ別に、元のモデルの正解率を集計してみます。
accuracy of base model by LAC set size:
  size=0: n=  13  accuracy=0.385
  size=1: n=1057  accuracy=0.900
  size=2: n= 130  accuracy=0.554
サイズ 1 のサンプルでは正解率 0.90 ですが、サイズ 2 では 0.55、空集合では 0.39 まで落ちます。たとえば「集合サイズが 1 なら自動処理、2 以上か空集合なら人が確認する」といった振り分けルールを、統計的な裏付けのある形で作れます。
ユースケース3: 時系列の予測区間(EnbPI / ACI)
3 つ目は時系列です。24 ステップ周期の季節性を持つ系列を作り、途中(t=1100)でノイズの標準偏差を 1.0 から 3.0 に急増させます。予測には過去 24 ステップのラグ特徴量を使います。
TimeSeriesRegressor は、v1 でも旧来の fit() / predict() スタイルの API を保っています。cv に BlockBootstrap を渡すと EnbPI になります。
from mapie.regression import TimeSeriesRegressor
from mapie.subsample import BlockBootstrap

# --- 2. EnbPI: BlockBootstrap でアンサンブルを作る ---
cv = BlockBootstrap(n_resamplings=20, length=48, overlapping=True, random_state=RANDOM_STATE)
model = RandomForestRegressor(n_estimators=50, max_depth=10, random_state=RANDOM_STATE)

enbpi = TimeSeriesRegressor(
    estimator=model, method="enbpi", cv=cv, agg_function="mean", n_jobs=-1
)
enbpi.fit(X_train, y_train)

# (a) update なし: 学習時の残差だけで区間を作る
y_pred_static, y_pis_static = enbpi.predict(
    X_test, ensemble=True, confidence_level=CONFIDENCE_LEVEL
)

# (b) update あり: 1 step ごとに観測値で残差を更新しながら予測する
y_pred_upd = np.zeros(len(X_test))
y_pis_upd = np.zeros((len(X_test), 2, 1))
y_pred_upd[:1], y_pis_upd[:1] = enbpi.predict(
    X_test[:1], ensemble=True, confidence_level=CONFIDENCE_LEVEL
)
for step in range(1, len(X_test)):
    enbpi.update(X_test[step - 1 : step], y_test[step - 1 : step], ensemble=True)
    y_pred_upd[step : step + 1], y_pis_upd[step : step + 1] = enbpi.predict(
        X_test[step : step + 1], ensemble=True, confidence_level=CONFIDENCE_LEVEL
    )
ブロックブートストラップは、時系列の連続した区間(ここでは長さ 48)をまとめてリサンプリングするので、自己相関の構造を壊さずにアンサンブルを作れます。update() は、モデルを再学習せずに残差のプールだけを新しい観測で入れ替えます。
ACI では method="aci" を指定し、ステップごとに adapt_conformal_inference() を呼んで \(\alpha_t\) を更新します。
# --- 3. ACI: 外れたら区間を広げ、当たったら狭める ---
aci = TimeSeriesRegressor(
    estimator=model, method="aci", cv=cv, agg_function="mean", n_jobs=-1
)
aci.fit(X_train, y_train)

gamma = 0.05
y_pred_aci = np.zeros(len(X_test))
y_pis_aci = np.zeros((len(X_test), 2, 1))
y_pred_aci[:1], y_pis_aci[:1] = aci.predict(
    X_test[:1], ensemble=True, confidence_level=CONFIDENCE_LEVEL, allow_infinite_bounds=True
)
for step in range(1, len(X_test)):
    X_obs, y_obs = X_test[step - 1 : step], y_test[step - 1 : step]
    aci.update(X_obs, y_obs, ensemble=True)
    aci.adapt_conformal_inference(X_obs, y_obs, gamma=gamma, confidence_level=CONFIDENCE_LEVEL)
    y_pred_aci[step : step + 1], y_pis_aci[step : step + 1] = aci.predict(
        X_test[step : step + 1],
        ensemble=True,
        confidence_level=CONFIDENCE_LEVEL,
        allow_infinite_bounds=True,
    )
ACI では、外れが続くと \(\alpha_t\) が 0 以下になり、区間が無限大になることがあります。allow_infinite_bounds=True はそれを許容するオプションです。
分布シフトの前後でカバレッジを比較した結果がこちらです(n_inf は無限区間が出たステップ数)。
target coverage = 0.9
method               cov(all) cov(before) cov(after) width(after)  n_inf
EnbPI (no update)       0.644       0.906      0.403        3.450      0
EnbPI (update)          0.724       0.909      0.553        4.972      0
ACI (gamma=0.05)        0.872       0.899      0.847       14.967     32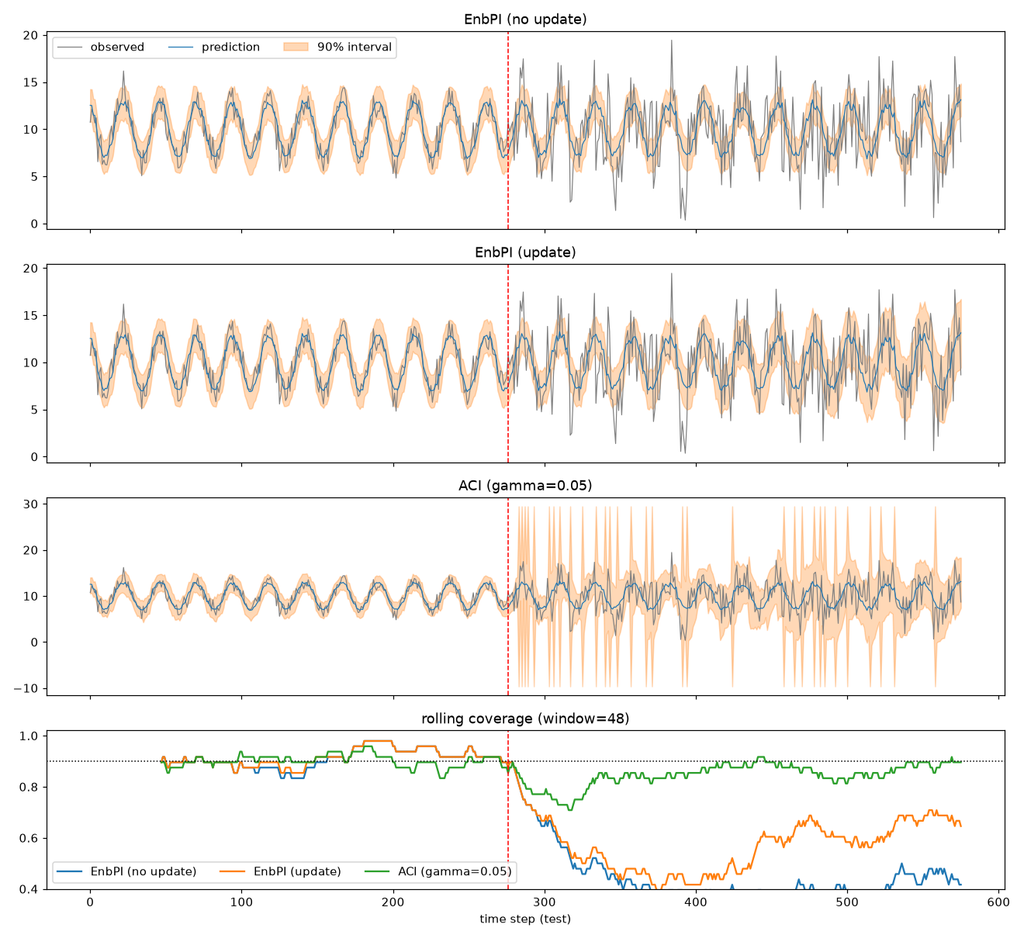
シフト前はどの手法もカバレッジ 0.9 前後で、きちんと機能しています。違いが出るのはシフト後です。
- EnbPI(update なし) は学習時の残差のまま区間を作り続けるので、カバレッジが 0.40 まで落ち込みます。
- EnbPI(update あり) は残差プールを少しずつ入れ替えるため、区間が徐々に広がり、カバレッジも回復傾向にあります。ただし、プールには約 800 件の古い残差が残っているので、追従はゆっくりです。
- ACI は外れた直後から \(\alpha_t\) を調整するので、ローリングカバレッジが素早く 0.9 付近に戻ります。その代償として、シフト直後は区間が大きく振動し、32 ステップで無限区間が出ました(表の
width(after)は、無限区間を有限値にクリップして計算したものです)。
gamma を大きくすると反応は速くなりますが、区間幅はより不安定になります。実際の運用では、許容できる区間の変動とのトレードオフで調整することになります。
補足として、MAPIE 1.5.0 の
TimeSeriesRegressor.update()は、呼び出すたびに仕様変更を告知するUserWarningを出します。ループ内で何百回も呼ぶとログが埋まるので、サンプルコードではwarnings.filterwarningsで抑制しています。
ユースケース4: リスク制御で適合率を保証する
4 つ目は、二値分類のしきい値選択です。たとえば不正検知で「アラートを出したもののうち 9 割以上は本当に不正であってほしい」という要件があるとします。これは 適合率(precision)≥ 0.9 という要件です。
正例が 20% の不均衡データで勾配ブースティングを学習し、BinaryClassificationController で「適合率 ≥ 0.9 を信頼度 90% で保証するしきい値」を探します。
from mapie.risk_control import BinaryClassificationController, precision, recall

RANDOM_STATE = 42
TARGET_PRECISION = 0.9
CONFIDENCE_LEVEL = 0.9
# しきい値の候補。候補が多いほど多重検定の補正が厳しくなるため, 粗めのグリッドにする。
# また, 予測陽性が 0 件になる高すぎる値 (例: 0.99) を含めると precision が
# 定義できず p 値が NaN になり, Bonferroni-Holm で有効なしきい値が見つからなくなる (mapie 1.5.0)
THRESHOLDS = np.round(np.arange(0.3, 0.91, 0.05), 2)

# (中略: データ生成・学習)

controller = BinaryClassificationController(
    predict_function=clf.predict_proba,
    risk=precision,
    target_level=TARGET_PRECISION,
    confidence_level=CONFIDENCE_LEVEL,
    list_predict_params=THRESHOLDS,
)
controller.calibrate(X_calib, y_calib)
y_pred_ctrl = controller.predict(X_test)
predict_function には predict_proba を、risk には MAPIE が用意している precision オブジェクトを渡します。calibrate() を実行すると、保証を満たすしきい値の集合(valid_predict_params)と、その中から選ばれた最良のしきい値(best_predict_param)が得られます。
threshold=0.50 (default): precision=0.884  recall=0.593

valid thresholds: 0.60 ... 0.90 (7 candidates)
best threshold  : 0.60
threshold=0.60 (controlled): precision=0.914  recall=0.534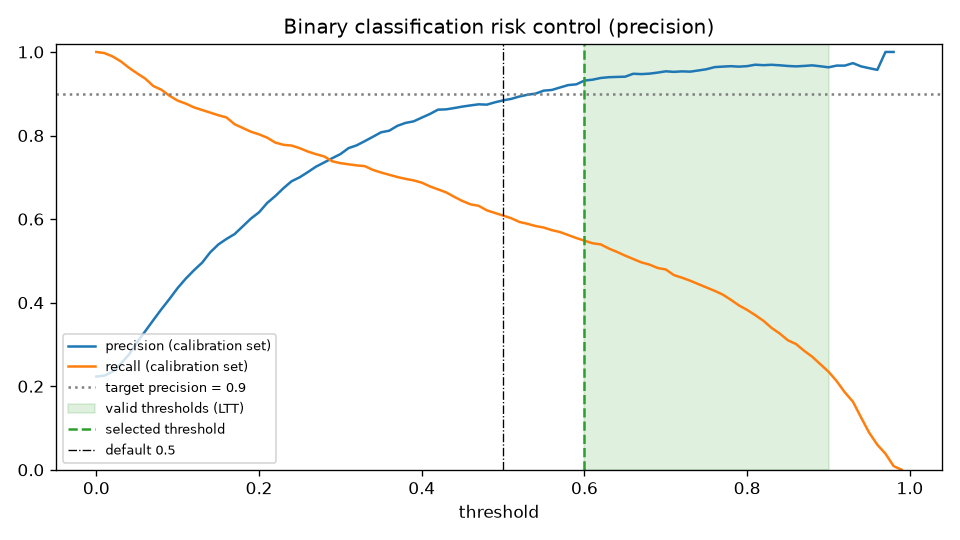
デフォルトのしきい値 0.5 では適合率が 0.884 で、要件を満たしていません。コントローラーが選んだしきい値 0.60 では、テストデータの適合率が 0.914 になりました。図4 の緑の帯が「適合率 ≥ 0.9 と統計的に言える」しきい値の範囲です。キャリブレーションデータ上の適合率が 0.9 をわずかに超えた直後ではなく、少し余裕を持った位置から始まっているのは、有限サンプルの揺らぎを考慮して検定しているからです。
本当に保証が成り立っているのか、キャリブレーションとテストの分割を 200 回変えて確かめてみます。
200 trials: P(test precision >= 0.9) = 1.000  (should be >= 0.9, no valid threshold: 0)
threshold range over trials: 0.60 - 0.75
200 回すべてでテストの適合率が 0.9 以上になりました。保証は「90% 以上の確率で満たす」なので、余裕を持ってクリアしています。LTT はもともと保守的な手法で、目標を上回りやすい傾向があります。
複数のリスクを同時に制御することもできます。risk と target_level をリストにし、best_predict_param_choice で有効なしきい値の中からどれを選ぶかを指定します。
multi_controller = BinaryClassificationController(
    predict_function=clf.predict_proba,
    risk=[precision, recall],
    target_level=[TARGET_PRECISION, 0.35],
    confidence_level=CONFIDENCE_LEVEL,
    list_predict_params=THRESHOLDS,
    best_predict_param_choice=recall,  # 条件を満たすしきい値の中で recall 最大のものを選ぶ
)
しきい値候補の設計でハマったこと
実はこのサンプル、最初は
calibrate()が「有効なしきい値が見つからない」という警告を出すだけで、まったく動きませんでした。原因は 2 つありました。1 つ目は、候補の数が多いほど多重検定の補正(デフォルトは Bonferroni-Holm)が厳しくなり、有効なしきい値が見つかりにくくなることです。デフォルトの 0〜0.99 の 100 点ではなく、0.05 刻み程度に絞ると検出力が上がります。2 つ目は、予測陽性が 0 件になるほど高いしきい値(0.99 など)を候補に含めると、適合率が計算できずに p 値が NaN になることです。MAPIE 1.5.0 時点の Bonferroni-Holm の実装はこの NaN を最小値として拾ってしまい、有効なしきい値が 1 つも見つからなくなります。候補の上限は、キャリブレーションデータに十分な予測陽性が残る範囲に抑えておくのが安全です。
ユースケース5: 予測確率のキャリブレーション(Venn-Abers / Top-Label)
最後は、予測確率そのものの補正です。予測集合やリスク制御とは目的が異なりますが、「確率 0.8」を本当に 8 割の確からしさとして使いたい場面(期待値の計算や、他システムへの確率の受け渡しなど)では、ここがずれていると困ります。
まずは二値分類です。過信(確率が 0 や 1 に張り付く)しがちな Gaussian Naive Bayes を、VennAbersCalibrator で補正します。3 つのモードを試します。
from mapie.calibration import TopLabelCalibrator, VennAbersCalibrator

# (a) 補正なし
nb = GaussianNB().fit(X_fit, y_fit)
proba_raw = nb.predict_proba(X_test)

# (b) prefit: 学習済みモデルを別のキャリブレーションデータで補正
va_prefit = VennAbersCalibrator(estimator=nb, cv="prefit")
va_prefit.fit(X_calib, y_calib)
proba_va_prefit = va_prefit.predict_proba(X_test)

# (c) IVAP: 学習とキャリブレーションの分割を内部で行う
va_ivap = VennAbersCalibrator(
    estimator=GaussianNB(), inductive=True, random_state=RANDOM_STATE
)
va_ivap.fit(X_train, y_train, calib_size=0.3)
proba_va_ivap = va_ivap.predict_proba(X_test)

# (d) CVAP: クロスバリデーションで複数の IVAP を作って統合する
va_cvap = VennAbersCalibrator(
    estimator=GaussianNB(), inductive=False, n_splits=5, random_state=RANDOM_STATE
)
va_cvap.fit(X_train, y_train)
proba_va_cvap = va_cvap.predict_proba(X_test)
評価には expected_calibration_error(ECE)を使います。ただし注意点があり、この関数の第 1 引数 y_true は 正解ラベルではなく「予測が正解したかどうか(0/1)」 です。引数名からは想像しにくいので、ラッパー関数を作っておくと安全です。
def confidence_ece(y_true, proba, num_bins=10):
    """MAPIE の ECE は「予測が正解したか (0/1)」を第 1 引数に取る."""
    correct = (np.argmax(proba, axis=1) == y_true).astype(int)
    return expected_calibration_error(correct, proba, num_bins=num_bins)
[binary] GaussianNB + Venn-Abers
method                     ECE   Brier  LogLoss
GaussianNB (raw)        0.1206  0.1585   0.6815
Venn-Abers (prefit)     0.0237  0.1406   0.4363
Venn-Abers (IVAP)       0.0237  0.1406   0.4363
Venn-Abers (CVAP)       0.0104  0.1387   0.4305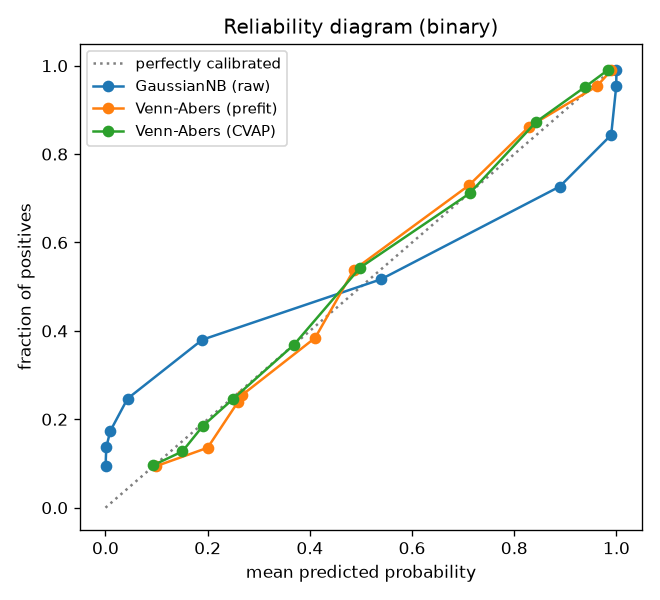
補正前の ECE 0.12 が、Venn-Abers によって 0.01〜0.02 まで改善しました。図5 を見ると、補正前の Naive Bayes は予測確率が 0 付近と 1 付近に集中しており、典型的な過信状態です。補正後は対角線にほぼ沿っています。データを使い回せる CVAP が最も良い結果になりました(prefit と IVAP が同じ値なのは、今回のコードでは内部の分割がたまたま一致したためです)。
Venn-Abers ならではの機能として、確率の区間 \([p_0, p_1]\) も取り出せます。
proba_merged, p0_p1 = va_prefit.predict_proba(X_test, p0_p1_output=True)
Venn-Abers multiprobability [p0, p1] (first 5 samples):
  raw=0.880 -> p0=0.718, p1=0.729, merged=0.721
  raw=0.001 -> p0=0.192, p1=0.201, merged=0.199
  raw=0.789 -> p0=0.600, p1=0.639, merged=0.615
  raw=0.999 -> p0=0.935, p1=0.963, merged=0.937
  raw=0.031 -> p0=0.262, p1=0.265, merged=0.264
mean width of [p0, p1]: 0.0156
Naive Bayes が「0.001」と言い切っていたサンプルが、補正後は約 0.2 になっています。\([p_0, p_1]\) の幅は確率推定そのものの不確かさを表し、キャリブレーションデータが少ない領域ほど広くなります。
多クラス分類では、最大確率のクラス(top-label)の確率だけを補正する TopLabelCalibrator も使えます。
tlc = TopLabelCalibrator(
    estimator=RandomForestClassifier(
        n_estimators=200, max_depth=8, random_state=RANDOM_STATE
    ),
    calibrator=calibrator,  # "sigmoid" or "isotonic"
    cv="split",
)
tlc.fit(X_train, y_train, calib_size=0.3, random_state=RANDOM_STATE)
[multiclass] RandomForest + TopLabel / Venn-Abers
method                 top-label ECE  accuracy
RandomForest (raw)            0.2379     0.783
TopLabel (sigmoid)            0.0356     0.779
TopLabel (isotonic)           0.0375     0.779
Venn-Abers (IVAP)             0.0564     0.791

TopLabel (sigmoid) predict_proba (first 3 samples):
[[  nan   nan   nan   nan 0.814]
 [  nan   nan   nan   nan 0.651]
 [  nan   nan   nan 0.837   nan]]
ランダムフォレストは確率が 0.5 付近に寄りがちな「自信のなさ」が知られており、top-label ECE は 0.24 と大きめです。TopLabelCalibrator で 0.04 程度まで改善しました。出力を見るとわかるとおり、TopLabelCalibrator.predict_proba() は top-label 以外の列が NaN になるので、後続の処理では np.nanmax や np.nanargmax を使う必要があります。全クラスの確率が必要なら、多クラスにも対応した VennAbersCalibrator(内部では one-vs-one で二値の Venn-Abers を組み合わせています)を使ってください。
おわりに
MAPIE を使って、回帰・分類・時系列・リスク制御・キャリブレーションの 5 つを一通り動かしてみました。
- 回帰は Split / CV+ / CQR。不均一分散があるなら CQR
- 分類は LAC / APS / RAPS。集合サイズは「迷い度」として振り分けに使える
- 時系列は EnbPI と ACI。分布シフト後の追従の速さがまるで違う
- リスク制御は LTT。「適合率 ≥ 0.9」をそのまま統計的な保証にできる
- キャリブレーションは Venn-Abers と Top-Label
既存のモデルには手を付けず、数行足すだけで分布を仮定しない保証付きの区間が手に入る。ここがコンフォーマル予測のいちばんの魅力です。NGBoost や XGBoostLSS で分布の仮定に悩んでいた頃に知っていれば、と少し思いました。ただ、保証はあくまで周辺カバレッジで、交換可能性が前提です。回帰の例で見たように、全体の数字だけで安心しないほうがいいです。
個人的に一番実務で使えそうだと感じたのは、リスク制御でした。「しきい値をいくつにするか」は現場でよく揉める話題ですが、「適合率 0.9 を 90% の信頼度で保証できるのはこの範囲」と根拠付きで出せるのは強いです。そのぶん、しきい値候補の切り方次第で何も出てこなくなるという癖もあるので、そこは注意してください。
MAPIE にはほかにも、feature_map で指定したグループごとに条件付きカバレッジを保証する条件付きコンフォーマル予測(ConditionalSplitConformalRegressor など、pip install "mapie[conditional]" が必要)や、置換検定やマルチンゲールで交換可能性を確かめる mapie.exchangeability_testing、本番環境でリスクの悪化を監視する RiskMonitoring、マルチラベルやセマンティックセグメンテーション向けの MultiLabelClassificationController / SemanticSegmentationController があります。今回は試せていないので、条件付きコンフォーマル予測あたりから別の記事で触ってみるつもりです。
More Information
- MAPIE GitHub / MAPIE Documentation
- Angelopoulos, A. N., & Bates, S. (2021). A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification. arXiv:2107.07511
- Barber, R. F., et al. (2021). Predictive inference with the jackknife+. The Annals of Statistics.
- Romano, Y., Patterson, E., & Candès, E. (2019). Conformalized Quantile Regression. NeurIPS.
- Romano, Y., Sesia, M., & Candès, E. (2020). Classification with Valid and Adaptive Coverage. NeurIPS.
- Angelopoulos, A. N., et al. (2021). Uncertainty Sets for Image Classifiers using Conformal Prediction. ICLR.
- Xu, C., & Xie, Y. (2021). Conformal prediction interval for dynamic time-series. ICML.
- Gibbs, I., & Candès, E. (2021). Adaptive Conformal Inference Under Distribution Shift. NeurIPS.
- Angelopoulos, A. N., et al. (2021). Learn then Test: Calibrating Predictive Algorithms to Achieve Risk Control. arXiv:2110.01052
- Vovk, V., & Petej, I. (2014). Venn-Abers Predictors. UAI.
関連記事

Pythonで始める因果推論入門
昨今、ビジネスでは、データに基づいた意思決定がますます求められています。しかし、データから得られるのは、あくまで相関関係です。因果関係を正しく理解することで、我々はより確実な予測を行い、効果的な対策を立てることができるよ […]

ディープラーニングモデルの量子化: PyTorchによる実践解説
近年、ディープラーニングは画像認識、自然言語処理、音声認識など、多岐にわたる分野で目覚ましい成果を上げています。しかし、これらの高精度なモデルは、しばしば膨大なパラメータ数を持ち、その結果として大きなメモリ消費量や計算コ […]
バイブコーディングのリアル: ソフトウェア開発におけるAI活用の罠と対策
自然言語でAIと対話しながらコードを生成する「Vibe Coding(バイブコーディング)」。Claude CodeやGemini CLIといったコーディングエージェントの登場により、プロトタイピングの開発速度は劇的に向 […]