SO-Arena: System One モデルの能力スペクトルと信頼性の検証
問い合わせをどの部署に回すか、次にどのツールを呼ぶか、エージェントの作業が本当に終わったか。こうした定型的な判断は、ソフトウェアの中で毎日大量に発生します。推論トークンを長々と出力する System Two 型のモデル(いわゆる推論モデル)でも答えは出せますが、1件ごとに数秒かかり、コストもかさみます。
そこで使われ始めているのが System One モデルです。あらかじめ決めた選択肢に対する確率分布を、思考の過程を書き出さずに1回の forward pass で返すモデルを指します。出力が構造化されているので後段のプログラムからそのまま扱え、遅延も小さく抑えられます。ただし「総合スコアが高いからこのモデルにしよう」と決めてよいかは、また別の問題です。苦手なドメインはないか。選択肢の並び順を変えたら答えが変わらないか。正しい選択肢が一つもないときに、それに気づけるか。
SO-Arena は、こうした疑問に答えるためのベンチマークです。11 ドメイン・2,919 タスクで System One モデルを評価し、能力(capability) と 判断の信頼性(decision reliability) を別々の軸として測っています。21 モデルを評価した結果、性能が最上位のモデルでも信頼性では 7 位にとどまることが明らかになっています。
この記事では、SO-Arena の設計の考え方、評価指標の中身、主な実験結果、そして実務でモデルを選ぶ際に何が言えるかを順に紹介します。
1. System One モデルと既存評価の課題
System One モデルの定式化
SO-Arena では、System One モデルを「与えられた状態と判断の仕様を、取りうる結果に対する構造化された予測に写像するモデル」と定義しています。
1 件の判断は \(x = (s, q, C)\) の 3 つ組で表されます。
- \(s\)(状態・入力情報): モデルに渡す情報です。テキスト、構造化レコード、検索で得た文書、操作履歴などが入ります。
- \(q\)(問い): 「何を決めたいか」を表します。
- \(C = {c_1, \dots, c_K}\)(選択肢): 候補となる結果とその説明です。
モデルはこの \(C\) 上の確率分布 \(p_\theta(\cdot \mid x)\) を返します。各確率は 0 以上で、合計は 1 になります。
3 種類の出力形式
出力形式は以下の 3 種類に分かれます。
| 形式 | 中身 | 予測の取り方 |
|---|---|---|
| choice(カテゴリ選択) | 順序のない選択肢から 1 つ選ぶ | 確率が最大の選択肢 |
| noul(二値判定) | yes/no の質問 | 「yes」の確率 |
| score(順序評価) | 段階的なレベルから選ぶ | 確率最大のレベルの評点。隣のレベルには部分点 |
score で隣のレベルにだけ部分点を与えるのには理由があります。レベルに順序があっても、各段階の「意味の距離」が等間隔とは限らないためです。
既存ベンチマークに足りないもの
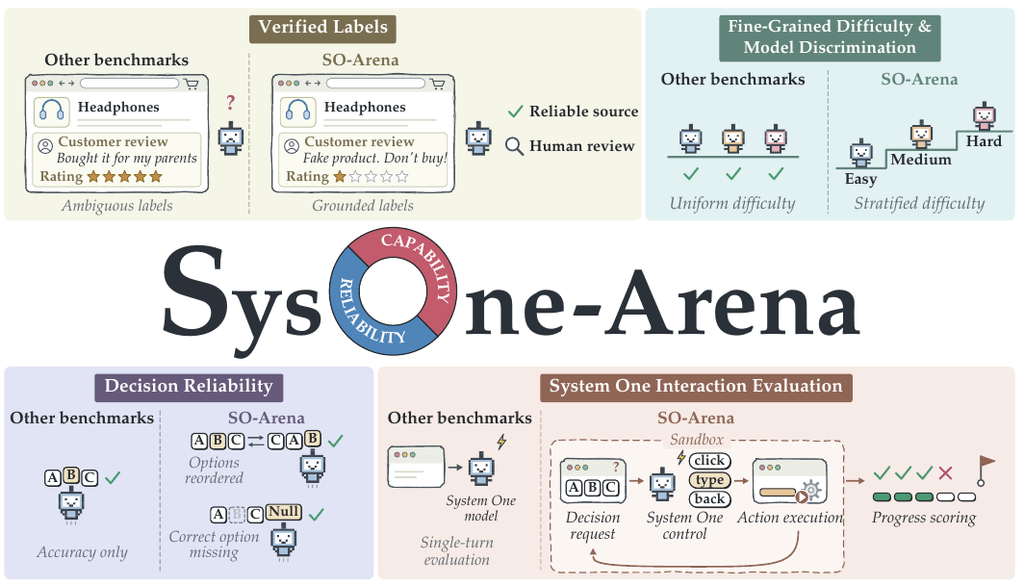
System One モデルの評価に必要な要件として、次の 4 点が挙げられます。
- 根拠のある正解ラベル: 商品レビューの評価のように、ラベルがモデルに見える情報から本当に導けるとは限りません。たとえば「Bought it for my parents」というレビュー本文だけでは星の数は決まりません。
- 難易度の区別: 簡単な問題ばかりだと、どのモデルも正解してしまい差がつきません。
- エージェント設定での評価: 単発の判断だけでなく、行動を選んで環境を進める場面や、記録された実行結果を検証する場面も見る必要があります。
- 選択肢の変化に対する信頼性: 正解率だけでは、並び順への過敏さや「正解がない」状況への鈍さは見えません。
2. SO-Arena の設計
タスクの構成
5 つの能力ファミリーと 11 ドメイン
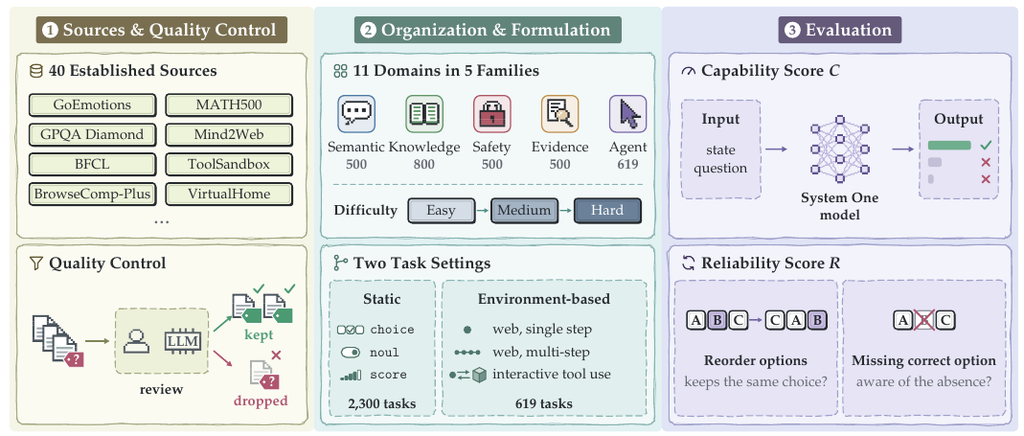
SO-Arena は、40 の公開データセット・ベンチマーク・環境から集めたタスクを 11 ドメインに整理し、さらに次の 5 つの能力ファミリーにまとめています。
- 意味理解(Semantic understanding): 感情理解、意図分類・ルーティング
- 知識・推論(Knowledge and reasoning): 数学、コード理解、科学的推論、知識・常識
- 安全・ポリシー順守(Safety and policy compliance): 有害性やリスクの判定
- 根拠の評価(Evidence assessment): 検索・リランキング、タスク完了の検証(Task Completion Verification)
- エージェントのタスク完了(Agent task completion): ツール・API 利用、Web 操作
正解ラベルの品質管理とデータ形式の統一
タスクの構築にあたっては、ラベルの品質管理と形式の統一が行われています。
- 正解ラベルの品質管理:
- 元データのラベルを参照解として残しつつ、人手と LLM の両方で確認し、疑わしい項目は除外されています。
- 各タスクには出典、バージョン、元の ID が記録され、モデル由来のラベルにはメタデータで印が付いています。
- データ形式の統一(choice 形式への変換):
- 自由記述で答える数学問題のように選択肢がない元データについては、以下の 3 つからディストラクタ(誤答の選択肢)を作成し、choice 形式に変換しています。
- ベースモデルの誤答
- 解答途中の中間結果
- ルールで作ったニアミス(惜しい誤答)
- 自由記述の回答を必要とするタスクは対象外です。
- 自由記述で答える数学問題のように選択肢がない元データについては、以下の 3 つからディストラクタ(誤答の選択肢)を作成し、choice 形式に変換しています。
難易度ティアと 2 つのタスク設定
難易度ティア
- ティアの構成: 11 ドメインのうち 9 ドメインには easy / medium / hard の難易度ティアがあります。数学だけは AIME の問題 30 件からなる very hard ティアも持ちます。
- ティアがないドメイン: 感情理解と知識・常識の 2 ドメインは、判断の複雑さを系統的に変えにくいためティアがありません。
- 注意点: ティアは各ドメインの中での相対的な基準であり、ドメイン間では較正されていない点に注意が必要です。数学の hard と Web 操作の hard が同じ難しさというわけではありません。
2 つのタスク設定
タスクの設定は次の 2 つに分かれます。
- 静的タスク(2,300 件): 固定された入力を見て判断します。
- 環境ベースのタスク(619 件): Web やツールの環境の観測をもとに、行動を評価したり選んだりします。内訳は以下の通りです。
- Web(337 件): 記録されたページ 1 枚に対する判断が 100 件、参照ルートに沿って連続で行動を選ぶタスクが 237 件です。
- 対話的なツール利用(282 件): BFCL や ToolSandbox のシミュレータ上で実際に行動を実行します。
履歴依存の検証(タスク完了検証の hard ティア)
特に工夫されているのが、タスク完了検証の hard ティアにある履歴依存の検証です。
- 家庭内シミュレータ VirtualHome で一度成功した実行の後ろに、「家電を操作し、対象の物を動かし、また戻す」という一連の手順を付け足します。
- すると、最終状態はゴールを満たしているのに、途中で「物が所定の位置にない状態で家電のスイッチを入れた」ような軌跡ができます。
- モデルは最終状態だけでなく、各操作の直前に条件が守られていたかまで判定しなければなりません。
- 最終状態がまったく同じで途中の条件だけが違う軌跡も検証用に用意されているので、最終状態を見るだけでは正解できないようになっています。
設計の次は、これらのタスクをどう採点するかです。
3. 能力スコアと信頼性スコア
能力スコア C
能力スコアは、各ドメインの最も難しいティアのタスクだけを使って計算します(数学は hard と very hard、ティアのないドメインは全タスク)。
$$C(m) = \frac{100}{D} \sum_{d=1}^{D} \frac{1}{|T_d|} \sum_{i \in T_d} c_i(m)$$
各変数の意味と計算の特徴は以下の通りです。
- \(c_i(m) \in [0, 1]\):モデル \(m\) がタスク \(i\) で得た得点
- \(T_d\):ドメイン \(d\) の最難ティアのタスク集合
- \(D\):ドメイン数
- 均等な重み付け: まずドメインごとに平均を取り、それをさらにドメイン数で平均しています。つまり、タスク数の多いドメインがスコアを支配しないようドメインを均等に重み付けしています。
- 最難ティアへの絞り込み: 上位ティアに絞っているのは、難しいタスクでの差をスコアに反映させるためです。
信頼性の 2 つの要素
信頼性は 2 つのテストで測ります。
① 選択肢の順序に対する安定性(option order stability)
各問題を元の順序に加えて 12 通りに並べ替えて出題し、答えが変わらないかを確かめます。答えは位置ではなく選択肢の中身で照合します。
$$S(m) = \frac{A(m) – p_e}{1 – p_e}, \quad A(m) = \frac{1}{12M} \sum_{i=1}^{M} \sum_{r=1}^{12} \mathbb{1}\{a_i^{(r)} = a_i^{(0)}\}, \quad p_e = \frac{1}{M} \sum_{i=1}^{M} \frac{1}{K_i}$$
- \(A(m)\):「並べ替えても元の答えを選び続けた割合」です。
- \(p_e\):選択肢が \(K_i\) 個ある問題でランダムに選んだ場合に一致する確率です。
- \(S\):ランダムに選べば 0、常に同じ答えなら 1 になるよう正規化されています。
- 注意点: この指標が見ているのは一貫性で、正しさではありません。同じ誤答を選び続けるモデルでも \(S\) は高く出ます。
➁ 正解の欠落に気づく力(null discrimination)
各問題を、「そのままの版」と「正解の選択肢を抜いた版」の 2 通りで出題します。モデルが出す「正解が含まれていない確率」\(p_{\text{null}}\) で 2 つの版をどれだけ見分けられるかを ROC 曲線の AUC で測り、次のように変換します。
$$N(m) = 2 \mathrm{AUC}(m) – 1$$
- 偶然と同じなら \(N = 0\) になります。
- 正解のない版すべてに正解のある版より高い \(p_{\text{null}}\) を付けられれば \(N = 1\) です。
信頼性スコア R の算出
最後に、2 つを幾何平均でまとめたものが信頼性スコアです。
$$R(m) = \begin{cases} \sqrt{S(m) N(m)} & S(m) > 0 \text{ かつ } N(m) > 0 \\ 0 & \text{それ以外} \end{cases}$$
- 幾何平均を使っているので、どちらか一方だけが高くても \(R\) は伸びません。
- 片方が偶然以下なら 0 になります。
- 「並べ替えに強い」と「正解がないことに気づける」の両方がそろって初めて信頼できる、という考え方です。
4. 実験と主な結果
評価対象モデルと実験設定
評価対象は全 21 モデルで、内訳は次の通りです。
- オープンウェイトの System One モデル(16 モデル): パラメータ数は 0.4B〜31B
- ハイブリッドモデル(1 モデル): System One と System Two を自動で切り替える StartLux Auto
- クローズドな意思決定 API(2 モデル): Jev API 1.14、OpenAI Decisions
- 比較の基準となる System Two モデル(2 モデル): GPT-6 Sol、GPT-6 Luna
実験では以下の項目を測定・評価しています。
- レイテンシ: 性能に加えて、H100 GPU 1 枚でのタスクあたりのレイテンシを測定しています。
- 信頼性の評価対象: StartLux Auto と GPT-6 の 2 モデルを除いた、System One の 18 モデルで評価しています。
主な実験結果
主な結果は次の通りです。
- 性能では System Two が首位: GPT-6 Sol が 82.3、Luna が 79.7 で、どの System One モデルよりも高いスコアでした。System One の最上位は GLiDE と KnowLine-31B(ともに 70.2)で、Luna との差は約 10 ポイントです。
- 速度は桁違い: オープンウェイトの System One モデルはすべて 1 タスク 0.3 秒以内で答えており、GPT-6 の 2 モデルより数十倍高速です。最小の Laya(0.4B)は平均 6 ms でした。
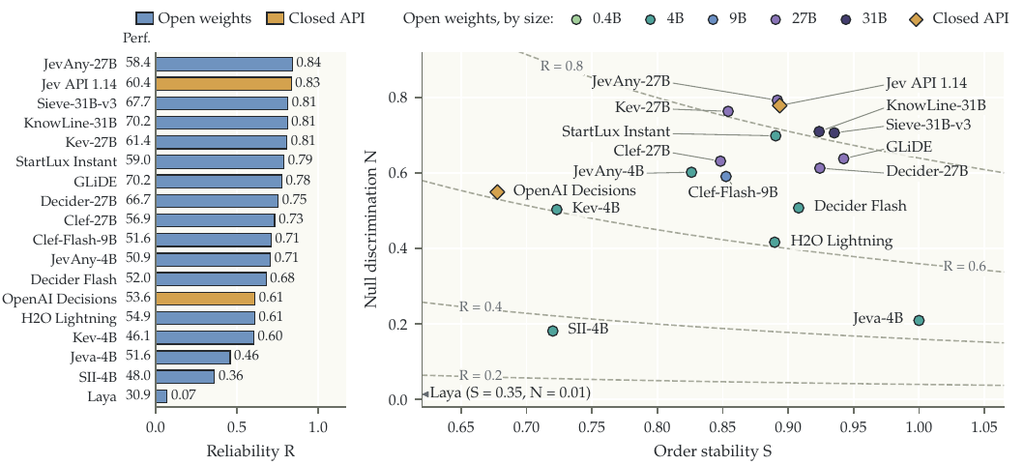
- 性能と信頼性の順位はずれる: 信頼性が最も高かったのは JevAny-27B(\(R = 0.84\))と Jev API 1.14(0.83)ですが、性能では 18 モデル中 8 位と 6 位です。性能が首位タイの GLiDE は、信頼性では 7 位(0.78)でした。
- 順序安定性はおおむね良好: 18 モデル中 14 モデルが \(S > 0.8\) でした。並び順に敏感だったのは Laya(0.35)、SII-4B、Kev-4B、OpenAI Decisions(0.68〜0.72)の 4 モデルです。
- 正解欠落への気づきは大きくばらつく: \(N\) は偶然と同じ水準から約 0.8 まで広く分布しました。同じファミリーなら大きいモデルのほうが高いものの、4B のモデルが 9B や 27B のモデルを上回る例もあり、規模だけでは決まりません。
| モデル | 種別 | 性能 C | 信頼性 R |
|---|---|---|---|
| GPT-6 Sol | System Two(クローズド) | 82.3 | — |
| KnowLine-31B | System One(オープン、31B) | 70.2 | 0.81 |
| GLiDE | System One(オープン、27B) | 70.2 | 0.78 |
| Jev API 1.14 | System One(クローズド API) | 60.4 | 0.83 |
| JevAny-27B | System One(オープン、27B) | 58.4 | 0.84 |
速度と性能の関係を見ると、パレートフロンティア(同じ速さで最も性能の高いモデルの集合)は、小型で速いモデルから GLiDE まで右肩上がりに伸びています。速さを少し犠牲にすれば性能が上がる、素直な関係です。一方、信頼性のほうはこの線とは別の動きをします。
5. ドメイン別の差と信頼性の要因
System Two との差はドメインによって違う
総合スコアで約 10 ポイントの差があっても、すべてのドメインで負けているわけではありません。GPT-6 Luna と、オープンウェイトの System One モデルのうち 2 つのサイズの最上位(StartLux Instant 4B と GLiDE 27B)を medium・hard ティアで比べると、ドメインは次の 3 つのカテゴリに分かれます。
| カテゴリ | ドメイン | Luna との差 | 差を縮めるもの |
|---|---|---|---|
| 直接的な意味判断 | 知識・常識、感情理解、検索・リランキング | ほぼ互角(GLiDE が上回るドメインもある) | バックボーン強化も思考もあまり効かない |
| 細かい根拠付きの判断 | 意図・ルーティング、Safety、完了検証、ツール利用、Web 操作 | GLiDE は 4 ポイント以内、4B は最大 29 ポイント差 | より新しく大きいバックボーン |
| 多段の導出 | 数学、科学的推論、コード理解 | 両モデルとも大差 | 思考(特に数学・科学) |
2 種類の「伸びしろ」の検証
さらに、次の 2 種類の「伸びしろ」も測定されています。
- バックボーンの利得: 同じファミリーで小さいモデル(Qwen3.5 ベース)から大きいモデル(Qwen3.8-27B ベース)に替えたときの差を見ます。
- 思考の利得: StartLux Auto の思考を常にオンにした場合と常にオフにした場合の差を見ます。
結果には明確な違いが見られました。
- 根拠付きの判断: 5 ドメインすべてで大きいモデルのほうがスコアが高く、その差は思考による改善を大きく上回りました。
- 数学: 思考の効果が大きく、StartLux Auto のスコアは 50.8 から 92.5 に上がって Luna に迫ります。思考の連鎖(chain-of-thought)は主に数学や記号推論で効く、という先行研究の知見とも合う結果です。
信頼性は何で決まるか
順序安定性 S の要因
- 順序安定性 \(S\) は、性能とほぼ連動しています。
- ポイントは、答えが変わる割合(flip 率)が、元々正解していた問題では 4.3% なのに対し、誤答していた問題では 25.7% と大きく跳ね上がることです。
- つまり、並び順で答えがぶれるのは、主にモデルが分かっていない問題だということになります。
正解欠落への気づき N の要因
- 正解欠落への気づき \(N\) は事情が違い、性能との関係が弱く、同程度の性能でもばらつきが大きくなっています。
- Kev-27B、Jev API 1.14、JevAny-27B の 3 モデルは、性能上位 4 モデル(GLiDE、KnowLine-31B、Sieve-31B-v3、Decider-27B)のいずれよりも \(N\) が高く、その差はブートストラップの信頼区間でも 0 を上回っていました。
- このことから、性能スコアから \(S\) はかなり予測できるが、\(N\) はほとんど予測できないので直接測る必要があるという結論が導かれます。
解釈するときの注意点
数字を読むときには、いくつか割り引いて考えたい点があります。
- ドメイン間での難易度比較はできない:
ティアはドメインごとの相対的な基準なので、ドメインをまたいで hard ティアのスコアを比べても難しさの比較にはなりません。 - タスク数の少ないティアがある:
たとえば完了検証の hard ティアはわずか 20 問です。付録のデータとして、hard ティアだけで集計し直すとこのドメインの思考の利得が +7.3 から −15.0 へ反転することが示されています。この規模だと、細かい差は誤差に埋もれます。 - 回答の拒否やコンテキスト長超過は 0 点扱いになる:
- OpenAI Decisions は、有害な推論トレースを含む Safety の問題や、患者ポータルのように機微な情報を含む Web の問題で回答を拒むことがあり、その分は不正解として数えられています。
- Laya も、コンテキスト長(8,192 トークン)を超える Web タスクでは 0 点です。
おわりに
SO-Arena は、System One モデルを「総合精度」という 1 つの数字でなく、ドメインごとの能力と判断の信頼性という 2 つの軸で評価するベンチマークです。根拠を確認した正解ラベル、ドメインごとの難易度ティア、エージェント環境での行動選択と完了検証、そして選択肢を操作して信頼性を測るテストを組み合わせています。21 モデルの評価からは、オープンウェイトの System One モデルが System Two より数十倍速いこと、難しいタスク(特にエージェント系)では性能が落ちやすいこと、そして性能の高さが信頼性の高さを保証しないことが示されました。
実務でモデルを選ぶ際の示唆ははっきりしています。まず、総合スコアではなく、自分の用途に近いドメインのスコアで比べることです。感情分類や検索の関連度判定のような意味判断なら、小型の System One モデルで十分なことが多そうです。ルーティングやツール選択では、バックボーンの大きさが効きます。数学のような多段の導出が必要なら、思考を使うモデルを残す選択肢が現実的です。そして、「該当なし」を返せることが欠かせない用途では、正解欠落への気づき \(N\) を別に測っておく必要があります。これは性能スコアからは読み取れないからです。
今後の System One モデルには、能力と信頼性の両方を伸ばすことが求められます。ベンチマーク側にも、ドメインをまたいで比べられる難易度の物差しや、少数しかない hard ティアの拡充といった改善の余地が残っています。
More Information
- arXiv:2611.15777, Lichen Li, Ziping Dong, Sicheng Feng, Qi Li, Xinchao Wang, 「SO-Arena: Benchmarking the Capability Spectrum and Reliability of System One Models」, https://arxiv.org/abs/2611.15777
関連記事
LLMの量子化がもたらす「アライメントの崩壊」
LLM(大規模言語モデル)をクラウドやエッジ環境で実運用する際、推論コストやメモリ使用量を削減するための「量子化」は欠かせない技術です。しかし、実社会のハイステークスな領域への適用が進むにつれ、量子化がハルシネーションや […]

Stable Baselines3 で検証する: 強化学習のトレーディングエージェントは Buy & Hold に勝てるか?
以前の記事では、強化学習の基本概念から最新のトレンドまでを俯瞰し、Stable Baselines3(SB3)を使った実装例も紹介しました。ただ、実際に手を動かそうとすると、公開されている Gym 環境の多くはロボット制 […]

マルチモーダル推論の最前線と技術的ブレークスルー
AIが高度化する現代において、推論能力は人間知能の中核をなす重要な要素です。近年、大規模言語モデル(LLM)は、算術、常識推論、記号推論といった分野で目覚ましい進歩を遂げ、その推論能力を大きく向上させてきました。しかし、 […]