Anomalib入門: GPUレス環境で試す画像の異常検知
これまでに、表形式データ向けの異常検知ライブラリとして PyOD と、ディープラーニングを使った DeepOD を紹介してきました。どちらも表形式や時系列のデータには強力ですが、画像を対象にした異常検知は守備範囲の外にあります。
画像の異常検知、たとえば製造ラインの外観検査では、「この画像は異常か」だけでなく「画像のどこが異常か」まで知りたい場面がほとんどです。そうした用途に特化したライブラリが Anomalib です。ただ、ディープラーニングと聞くと GPU が必須に思えますが、今回取り上げる PaDiM と PatchCore はネットワークの学習を一切行わない手法であり、GPU のないノート PC の CPU だけでも実用的な時間で動作します。
この記事では、Anomalib を使った画像異常検知の実装手順を整理したうえで、PaDiM と PatchCore を CPU 環境で実際に動かし、設定ごとの学習時間と精度のトレードオフを検証します。
画像異常検知の基礎概念
画像異常検知では、多くの場合、正常画像だけを使って学習します。製造現場では正常品の画像はいくらでも集まりますが、不良品の画像はめったに集まらず、欠陥の種類もあらかじめ網羅できないためです。そこで「正常からどれだけ外れているか」を異常スコアとして出力します。
出力には次の 2 つのレベルがあります。
- 画像単位:画像全体が異常かどうか(異常スコアと判定)
- ピクセル単位:画像のどこが異常か(異常マップ、ヒートマップ)
PyOD や DeepOD との一番大きな違いは、このピクセル単位の出力です。異常の位置が分かれば、検査員が確認すべき箇所を示したり、欠陥の大きさを測ったりできます。
Anomalib の概要
特徴と収録アルゴリズム
Anomalib は、Intel の OpenVINO チームが開発している画像・動画向けの異常検知ライブラリです。PyTorch Lightning をベースにしており、多くのアルゴリズムを共通の API(fit / test / predict / export)で扱えます。主な特徴は次のとおりです。
- 豊富なアルゴリズム:特徴量ベースの手法、知識蒸留、正規化フロー、再構成ベースの手法、CLIP を使ったゼロショット手法などを収録
- データセットの自動ダウンロード:VisA、MVTec AD、BTech などのベンチマークを読み込めるほか、自前の画像フォルダもそのまま扱える
- 評価と可視化の内蔵:AUROC や F1 スコアの計算、スコアの正規化、閾値の自動決定、ヒートマップ画像の出力までを一通りカバー
- デプロイ:OpenVINO や ONNX 形式にエクスポートして推論を高速化可能
収録されている代表的なアルゴリズムは下表のとおりです(一部抜粋)。
このうち知識蒸留や正規化フローの手法は、ネットワークを何十エポックも学習するため、CPU だけで動かすのは現実的ではありません。そこで今回は、CPU でも実用的に動く PaDiM と PatchCore を取り上げます。
| Model | Year | Type | Paper |
|---|---|---|---|
| GANomaly | 2018 | 再構成(GAN) | arXiv:1805.06725 |
| PaDiM | 2020 | 特徴量の分布モデル | arXiv:2011.08785 |
| STFPM | 2021 | 知識蒸留 | arXiv:2103.04257 |
| PatchCore | 2021 | 特徴量のメモリバンク | arXiv:2106.08265 |
| CFlow | 2021 | 正規化フロー | arXiv:2107.12571 |
| DRAEM | 2021 | 再構成+識別 | arXiv:2108.07610 |
| FastFlow | 2021 | 正規化フロー | arXiv:2111.07677 |
| Reverse Distillation | 2022 | 知識蒸留 | arXiv:2201.10703 |
| EfficientAD | 2023 | 知識蒸留+オートエンコーダ | arXiv:2303.14535 |
| WinCLIP | 2023 | CLIP によるゼロショット / 少数ショット | arXiv:2303.14814 |
PaDiM と PatchCore の仕組み
2 つの手法に共通する考え方は、「ImageNet で事前学習済みの CNN の特徴を物差しにする」ことです。処理の流れは次の 3 ステップになります。
- 学習済みの CNN(ResNet など)に正常画像を通し、中間層の特徴マップを取り出す
- 特徴マップの各点は元画像の小さな領域(パッチ)に対応するので、正常パッチの特徴を記録しておく
- テスト画像の各パッチについて、正常の記録からどれだけ離れているかを測る(これが異常マップになり、その最大値が画像の異常スコアになる)
ネットワークの重みは更新せず、学習データに対して順伝播を 1 回行うだけなので、GPU がなくても動きます。2 つの手法の違いは、正常パッチの特徴をどう記録するかにあります。
- PaDiM(Patch Distribution Modeling):パッチの位置ごとに、正常特徴の分布を多変量ガウス分布で近似します。テスト時はマハラノビス距離で外れ具合を測ります。統計量を計算するだけなので学習は非常に高速ですが、位置ごとに分布を持つため、撮影位置のそろった画像に向いています。
- PatchCore:正常パッチの特徴を、位置に関係なくメモリバンクに貯めておきます。テスト時は最近傍との距離で外れ具合を測ります。メモリバンクが巨大にならないよう、coreset サブサンプリング(k-center greedy)で代表的なパッチだけを残します。原論文では MVTec AD で画像単位の AUROC 約 99% を報告しています。
Python による実装例
セットアップ
ここからは実際にコードを動かしていきます。今回は uv でプロジェクトを作成し、Python 3.11、anomalib 2.7.0 の環境で検証しました。
# プロジェクトの作成
$ uv init --package --python 3.11 anomalib-intro
$ cd anomalib-intro

# Anomalib のインストール (Windows では CPU 版の PyTorch が入る)
$ uv add anomalib
pip を使う場合は
pip install anomalibでもインストールできます。
データセットの準備
画像異常検知のベンチマークといえば MVTec AD が定番です。ただ、執筆時点(anomalib 2.7.0)では、Anomalib に組み込まれた MVTec AD のダウンロード URL が 404 になっており、自動ダウンロードができませんでした。MVTec AD を使いたい場合は、公式サイトから手動でダウンロードする必要があります。
そこで今回は、Amazon が公開している VisA(Visual Anomaly) データセット(ライセンスは CC BY 4.0)を使います。VisA は 12 カテゴリ、計 10,821 枚(正常 9,621 枚、異常 1,200 枚)の画像からなり、ピクセル単位の正解マスクが付いています。1 枚の画像に複数の物体が写っていたり、構造が複雑だったりと、MVTec AD より難しいデータセットです。今回はその中から、ろうそくが 4 個写った candle カテゴリ(学習用の正常画像 900 枚、テスト画像 200 枚)を対象にしました。
学習と評価
PaDiM で学習と評価を行うコードは次のとおりです。MODEL_NAME を "patchcore" に変えれば、そのまま PatchCore で動きます。
# -*- coding: utf-8 -*-
import sys
import time

from anomalib.data import Visa
from anomalib.engine import Engine
from anomalib.models import Padim, Patchcore
from lightning.pytorch import seed_everything

# Windows (cp932) のコンソールで進捗バーの記号が書けずに落ちるのを防ぐ
sys.stdout.reconfigure(encoding="utf-8", errors="replace")
sys.stderr.reconfigure(encoding="utf-8", errors="replace")

# ----------------------------------------
# 1. 設定
# ----------------------------------------
MODEL_NAME = "padim"  # "padim" or "patchcore"
CATEGORY = "candle"   # VisA のカテゴリ
IMAGE_SIZE = (256, 256)
seed_everything(42, workers=True)

# ----------------------------------------
# 2. データセット (初回は datasets/visa に自動ダウンロード, 約 1.9GB)
# ----------------------------------------
datamodule = Visa(
    root="datasets/visa",
    category=CATEGORY,
    train_batch_size=16,
    eval_batch_size=16,
    num_workers=0,  # Windows では 0 が無難
)

# ----------------------------------------
# 3. モデル
# ----------------------------------------
if MODEL_NAME == "padim":
    model = Padim(
        backbone="resnet18",
        layers=["layer1", "layer2", "layer3"],
        pre_processor=Padim.configure_pre_processor(image_size=IMAGE_SIZE),
    )
else:
    model = Patchcore(
        backbone="wide_resnet50_2",
        layers=("layer2", "layer3"),
        coreset_sampling_ratio=0.001,  # CPU では小さめに (既定値は 0.1)
        pre_processor=Patchcore.configure_pre_processor(
            image_size=IMAGE_SIZE, center_crop_size=IMAGE_SIZE
        ),
    )

# ----------------------------------------
# 4. 学習と評価
# ----------------------------------------
engine = Engine(default_root_dir="results", accelerator="cpu", devices=1)

t0 = time.perf_counter()
engine.fit(model=model, datamodule=datamodule)
print(f"fit: {time.perf_counter() - t0:.1f} sec")

results = engine.test(model=model, datamodule=datamodule)
for name, value in results[0].items():
    print(f"{name}: {value:.4f}")
実装上のポイントは次の 5 つです。
Visa:データセットを読み込む DataModule です。初回実行時に自動でダウンロードと展開が行われます(展開後は約 3.7GB)。自前の画像を使う場合は、正常画像と異常画像のフォルダを指定するFolderに置き換えます。configure_pre_processor:入力画像のリサイズなど、前処理の設定を作成します。seed_everything:PaDiM は特徴の次元をランダムに選び、PatchCore は coreset の初期点をランダムに選びます。シードを固定しないと実行ごとに結果が変わるため、明示的に固定しています。Engine:Lightning の Trainer のラッパーで、fitで学習し、testで評価します。sys.stdout.reconfigure:Windows のコンソール(cp932)では、進捗バーの記号「•」を出力できずにUnicodeEncodeErrorで止まることがあったため、その対策として入れています。
PaDiM を実行した結果は次のようになりました。
fit: 43.5 sec
image_AUROC: 0.8695
image_F1Score: 0.8276
pixel_AUROC: 0.9800
pixel_F1Score: 0.1951
image_* が画像単位、pixel_* がピクセル単位の指標です。ピクセル単位の F1 スコアが 0.1951 と低く見えるのは、異常領域が画像全体に比べて非常に小さく、わずかな誤検知でも適合率が大きく下がるためです。閾値に依存しない AUROC で見ると、ピクセル単位で 0.9800 に達しており、異常の位置自体はよく捉えられています。
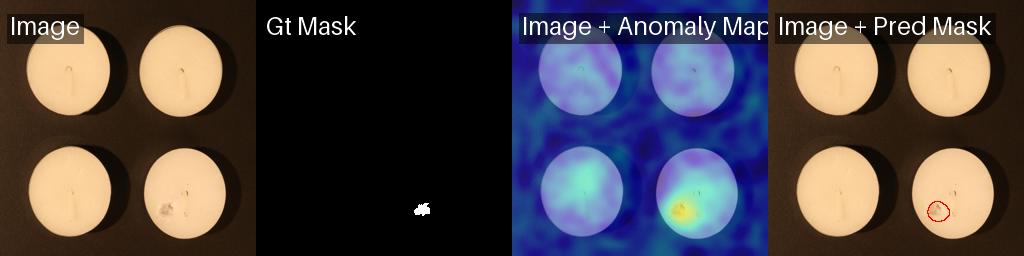
また、実行後は results/ 以下に、元画像・正解マスク・異常マップ・予測マスクを並べた可視化画像が保存されます。PatchCore(wide_resnet50_2)での出力例は次のとおりです。
右下や右上のろうそくにある小さな汚れや傷を、異常マップが的確に捉えていることが分かります。

学習済みモデルで推論する
学習済みのチェックポイントを読み込めば、任意の画像に対して推論だけを実行することもできます。
異常スコアは 0〜1 に正規化されており、0.5 を超えると異常と判定されます。推論時間は CPU でも 1 枚あたり 0.1 秒前後でした。
from anomalib.data import PredictDataset
from anomalib.engine import Engine
from anomalib.models import Patchcore

# 前処理、閾値、正規化の設定はチェックポイントに含まれている
model = Patchcore.load_from_checkpoint("results/Patchcore/Visa/candle/v0/weights/lightning/model.ckpt")
dataset = PredictDataset(path="path/to/images", image_size=(256, 256))

engine = Engine(default_root_dir="results/predict", accelerator="cpu", devices=1)
predictions = engine.predict(model=model, dataset=dataset)

for batch in predictions:
    for path, score, label in zip(batch.image_path, batch.pred_score, batch.pred_label):
        print(f"{path}: score={float(score):.3f}, anomaly={bool(label)}")
CPU での速度と精度
設定ごとの比較結果
ここからは、AMD Ryzen AI 9 HX 370(12 コア)、メモリ 96GB、GPU なしのノート PC で、モデルやパラメータを変えながら速度と精度を計測した結果を見ていきます。対象データは VisA の candle(学習用の正常画像 900 枚、テスト画像 200 枚)で、入力解像度は特に記載がない限り 256×256 です。
| モデル | バックボーン | coreset 比率 | 学習時間 | 画像 AUROC | ピクセル AUROC |
|---|---|---|---|---|---|
| PaDiM | resnet18 | – | 44 秒 | 0.870 | 0.980 |
| PatchCore | resnet18 | 0.0001 | 43 秒 | 0.832 | 0.924 |
| PatchCore | resnet18 | 0.001 | 157 秒 | 0.947 | 0.977 |
| PatchCore | resnet18(224×224) | 0.001 | 88 秒 | 0.935 | 0.971 |
| PatchCore | wide_resnet50_2 | 0.001 | 229 秒 | 0.970 | 0.983 |
| PatchCore | resnet18 | 0.005 | 1,007 秒 | 0.970 | 0.984 |
| PatchCore | resnet18 | 0.01 | 2,101 秒 | 0.979 | 0.986 |
PatchCore の比率 0.01 の行のみ、シードを固定する前に実行した結果です。なお、学習時間は実行ごとに 2〜3 割ほどばらつきます(同じ
wide_resnet50_2+ 比率 0.001 の条件でも、171 秒の回と 229 秒の回がありました)。
PatchCore の学習時間はほぼ coreset 選択で決まる
PatchCore を Anomalib の既定値に近い設定(coreset 比率 0.01)で動かすと、学習に約 35 分(2,101 秒)かかりました。しかし内訳を調べてみると、CNN による特徴抽出はわずか 23 秒で終わっており、残りの 34 分 20 秒はすべて coreset の選択処理に費やされていました。
coreset 選択に使われる k-center greedy は、「選択済みの点から最も遠い点を 1 つ追加する」という操作を繰り返すアルゴリズムです。1 点追加するたびに全パッチとの距離を計算し直すため、計算量はおおよそ次のようになります。
$$\text{パッチ数} N \times \text{coreset サイズ} (= \text{比率} \times N) = \text{比率} × N^2$$
今回は 900 枚 × 32×32 パッチで、全体で約 92 万個のパッチがあります。比率 0.01 ではそこから約 9,200 点を順番に選ぶため、この反復計算がボトルネックになります。計算時間が coreset 比率には比例し、パッチ数(画像枚数 × 解像度²)には 2 乗で効くため、学習画像が多いデータセットほど急激に重くなります。
CPU でのおすすめ設定と注意点
上の計測結果からは、次の 3 つの傾向が読み取れます。
- 比率を下げると、学習時間はほぼ比例して短くなる
coreset 比率を 0.01 → 0.005 → 0.001 と下げると、学習時間は 35 分 → 17 分 → 2.6 分まで短縮されました。 - 削りすぎると精度が崩れる
比率 0.0001(91 点しか残らない設定)まで減らすと、画像 AUROC が 0.832 まで落ち、PaDiM(0.870)を下回りました。 - 比率を下げた分、バックボーンを強くするのが効率的
バックボーンをwide_resnet50_2に変更すると特徴抽出は約 3 倍重くなりますが(22 秒 → 70 秒)、ボトルネックである coreset 選択の時間はほとんど変わりません。その結果、wide_resnet50_2+ 比率 0.001 は、resnet18+ 比率 0.005 と同じ精度(画像 AUROC 0.970)を約 4 分の 1 の時間で達成できました。
これらを踏まえると、CPU 環境では次のように使い分けるのが現実的です。
- まず手早く試すなら PaDiM:1 分以内で学習が終わり、異常の位置もそれなりに捉えられます。ただし、パッチの位置ごとに共分散行列を保持するため、モデルファイルが 169MB と大きめになる点には注意が必要です。
- 精度を求めるなら PatchCore(
wide_resnet50_2、coreset 比率 0.001):3〜4 分ほど待てば、画像 AUROC 0.970 の高い精度が得られます。
なお、今回の計測は VisA の candle という 1 カテゴリのみで、各設定 1 回ずつ実行した結果です。対象物の性質や学習データの枚数によって最適な比率は変わる可能性があるため、実データに適用する際はいくつかの比率で精度の飽和点を確認するのが安全です。
おわりに
この記事では、画像異常検知ライブラリの Anomalib を使い、事前学習済み CNN の特徴量を利用する PaDiM と PatchCore を CPU 環境で検証しました。データセットの読み込みから学習・評価、ヒートマップの可視化、チェックポイントからの推論までを共通の API で記述でき、PyOD や DeepOD では扱えなかった「画像のどこが異常か」という問題に数十行のコードでアプローチできます。
一番の収穫は、ネットワークの重みを更新しない PaDiM や PatchCore であれば、GPU なしのノート PC でも実用的な時間と精度で動かせることを手元の実験で確かめられた点です。とくに PatchCore では、学習時間のほぼすべてが coreset 選択に費やされていることを突き止め、coreset 比率を 0.001 に抑える代わりにバックボーンを wide_resnet50_2 に強化することで、学習時間を約 35 分から 3〜4 分まで短縮しつつ画像 AUROC 0.970 を維持できました。
一方で、PaDiM は撮影位置が揃っていることを前提としており、PatchCore もパッチ数が増えると計算量が 2 乗で増加するという制約があります。それでも、製造ラインの外観検査のような課題をまずは手元の PC で小さく試してみたいときに、Anomalib は心強い出発点になりそうです。
More Information
- Akcay, Samet, et al. “Anomalib: A Deep Learning Library for Anomaly Detection.” ICIP. 2022. arXiv:2202.08341
- Defard, Thomas, et al. “PaDiM: a Patch Distribution Modeling Framework for Anomaly Detection and Localization.” ICPR Workshops. 2020. arXiv:2011.08785
- Roth, Karsten, et al. “Towards Total Recall in Industrial Anomaly Detection.” CVPR. 2022. arXiv:2106.08265
- Sener, Ozan, and Silvio Savarese. “Active Learning for Convolutional Neural Networks: A Core-Set Approach.” ICLR. 2018. arXiv:1708.00489
- Zou, Yang, et al. “SPot-the-Difference Self-Supervised Pre-training for Anomaly Detection and Segmentation.” ECCV. 2022. arXiv:2207.14315
- Bergmann, Paul, et al. “MVTec AD — A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection.” CVPR. 2019.
- GitHub: open-edge-platform/anomalib
関連記事
AIエージェントの信頼性を決定づけるハーネス設計の最前線
LLMエージェントを本番環境で運用し始めると、多くの開発者が共通の課題に直面します。温度パラメータ(temperature)を下げて同一の入力を与えた場合でも、実行ごとにツールの呼び出し順序や最終出力が微妙に変動してしま […]

ローカルLLMはソフトウェア開発に活用できるのか?
近年、大規模言語モデル(LLM)の進化は目覚ましく、多くの分野でその活用が期待されています。しかし、その強力な性能を享受するには、クラウドベースでの運用が主流であり、API利用コストや外部APIへソースコードを送信するこ […]

TruthTorchLMによるLLMのハルシネーション検出
大規模言語モデル(LLM)の目覚ましい進化は生活やビジネスに革新をもたらす一方で、事実に基づかない情報を生成するハルシネーションが問題となっています。特に医療や金融といった高リスクな分野では、LLM出力の信頼性と正確性が […]