
Random Attention: KVキャッシュ削除により推論を加速させる
DeepSeek-R1 や Qwen3、Phi-4-reasoning といった推論特化型の大規模言語モデルは、難しい問題を解くために数万トークンにおよぶ思考連鎖(Chain of Thought: 思考の途中経過をテキ […]

AREX-Skill: GitHubリポジトリからAI研究を加速させる専門知識を蒸留する方法
自律的にコードを書き、実験を回し、結果を比較する「エージェント」が、機械学習研究の現場に入り込み始めています。もっとも、こうしたエージェントを実際に使ってみると、有名なライブラリの使い方を一つ間違えるだけで実験全体が無駄 […]
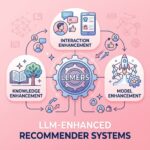
LLMERS: LLM強化型レコメンデーションシステムの全体像
大規模言語モデル(Large Language Model: LLM)に推薦結果を直接生成させると、1回の応答に数秒かかります。ミリ秒単位の応答が求められるレコメンデーションシステム(Recommender System […]

宇宙物理学における基盤モデル
近年、深層学習を大量のデータで一度事前学習し、それを多様なタスクに使い回す「基盤モデル(Foundation Model)」という言葉が、天文学のデータ解析でも目にする機会が増えています。ただし、Transformerを […]
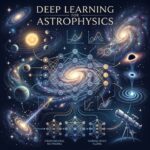
宇宙物理学×深層学習:基礎アーキテクチャからAIエージェントまでを概観する
現代の天文学は、Vera C. Rubin天文台やRoman宇宙望遠鏡などに代表される次世代の観測サーベイの稼働により、かつてない規模のデータ主導型科学へと急激に移行しています。こうした膨大なデータを前にして、従来の解析 […]
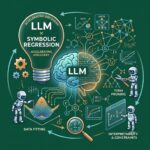
LLM×シンボリック回帰: 科学的発見を加速する次世代アプローチ
観測データから物理法則や数学的関係式を導き出すシンボリック回帰(SR: Symbolic Regression)をご存知でしょうか?従来の手法では、探索空間の組み合わせ爆発や、事前知識をシステムに組み込む難しさが長年の課 […]
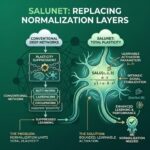
SaluNet: ディープラーニングに正規化は必要なのか?
ディープラーニングモデルの学習を安定させる上で、Batch Normalization (バッチ正規化) や Layer Normalization (レイヤー正規化) といった正規化層は、長らく不可欠な技術とされてきま […]
XAI (説明可能なAI) の終焉と新たなパラダイム
近年、LLM(大規模言語モデル)やDNN(ディープニューラルネットワーク)などのAI技術が高度化する中で、モデルの「ブラックボックス化」がシステム構築における大きな課題となっています。この不透明性を解消し、AIへの信頼を […]
次元削減の罠: なぜt-SNEやUMAPを誤用するのか?
データ探索や可視化の現場において、t-SNEとUMAPはデファクトスタンダードとしての地位を確立しています。多くの実務者が、高次元データの構造を理解するためにこれらのアルゴリズムを信頼し、クラスター分析や異常検知といった […]
Qwen3-TTS: 思い通りの声を創り出すAI音声合成
Qwenチーム(Alibaba Cloud)は、最新の多言語対応音声合成(TTS)モデルシリーズ「Qwen3-TTS」を公開しました。本モデルは500万時間以上という圧倒的な規模の音声データで学習され、日本語を含む10言 […]