JEV-as-a-Judge: 低コスト・高精度なLLM評価の最適戦略
LLMの出力をLLM自身に採点させる「LLM-as-a-Judge」は、プロンプト改善、RAGの検索・生成パイプラインのチューニング、社内ファインチューニング用のデータ選別など、開発サイクルにかなり定着しています。
ところが、判定の精度を上げようとしてGPT-6などの推論モデルを判定モデルに据えると、途端にコストの壁にぶつかります。推論モデルは思考プロセス(CoT: Chain of Thought)を出力するため、1回の判定で消費されるトークン数が跳ね上がります。その結果、API課金が膨らむだけでなく、逐次生成による待ち時間も長くなってしまいます。モデルを更新するたびに何千件ものテストケースを再評価する現場では、判定そのもののランニングコストと遅延はもはや無視できない開発コストです。
さらに厄介なのが、モデルの「過信」です。LLMに「この判定の確信度は?」と尋ねても、間違っている回答に対して平然と高い確率を返してくることがよくあります。そのため、「この採点をどこまで信じていいのか」という不確実性の見極めが常に付きまといます。
こうしたコストと信頼性の課題に対して、明快な解決アプローチを提示したのがカーネギーメロン大学の研究チームです。
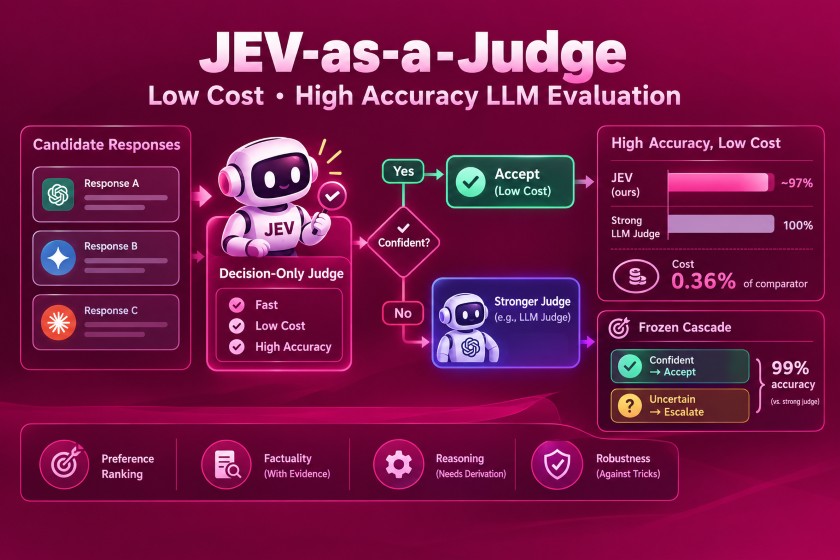
この研究で着目したのは、判定理由を文章で一切書かず、判定ラベルとその確率だけを直接返す TypeSafe JEV です。16種類のモデル構成や人手によるブラインド裁定を交えて検証した結果、通常の選好判定や根拠付きの事実確認において、最強の比較対象である GPT-6 Astra との精度差はわずか3ポイント以内に収まり、評価費用はその0.36%(約277分の1)に抑えられることが分かりました。
さらに、JEV が迷ったときだけ上位モデルに判定を委ねる「確信度カスケード」を組むと、GPT-6 の精度の99%を約57%の費用で維持できることも実証されています。
思考トークンのコスト肥大と、LLMの過信問題
LLMの自動評価を実務でスケールさせる上で、大きなボトルネックとなっている課題は2つあります。
思考トークンによるコストと遅延の増大
推論モデルは、長い思考の連鎖を展開することで難しい問題の判定精度を高めます。しかし実際の評価タスクには、「2つの回答のうち一方が明らかに優れているケース」や「参照ドキュメントと完全に一致しているケース」など、熟考するまでもない平易な判定が数多く含まれています。そうした日常的な判定にまで長大な思考トークンを消費させていては、API代も待ち時間も無駄に膨らむ一方です。
自己申告確信度の過信
安価なモデルで一次判定を行い、難問だけを高級モデルに回したいと考えても、LLMの自己申告する確信度はあまりあてになりません。誤った判定に対しても高い確率を割り当ててしまう過信傾向があるため、「どの判定を受理し、どの判定を上位モデルに再判定させるべきか」を安全に見分けるのが困難です。
この2点を受けて、研究では次の2つの問いを立てて検証が進められました。
- 判定理由を一切書かない JEV は、安価な一次判定として実用に耐えうるのか?
- 上位モデルへのエスカレーションが必要な入力を、モデル自身の不確実性シグナルで正しく選別できるのか?
JEVと確信度カスケード
判断専用モデル「TypeSafe JEV」とは
評価手法の流れを整理すると、人間の専門性による評価から、判定理由を自然言語で説明する「生成型LLM判定」へと移行してきました。JEV はその次の段階として、「型付きの判定ラベルと確率のみを返す」スタイルをとっています。
- 人手による評価は専門性が高いものの、時間と人件費がかかりすぎてスケールしません。
- 生成型LLM判定は採点理由を丁寧に言語化してくれる反面、トークン課金と生成待ち時間が膨らみます。
- 判定専用モデル(JEV)は理由文の生成を一切やめ、判定ラベルと確信度確率だけを高速・安価に返します。
検証で使われた TypeSafe JEV(v1.13)はホスト型APIサービスで、状態(state)、自然言語の指示、出力型を入力として受け取ります。出力形式には以下の3種類があります。
| プリミティブ | 返す内容 |
|---|---|
| Choice | 指定したラベル集合の確率分布(主実験で使用) |
| Noul | 「yes」である確率 |
| Score | 順序付きルーブリック段階の確率分布 |
料金体系は入力100万トークンあたり0.042ドルで、出力トークンへの課金は無料(0ドル)という設計です。
実際のやり取りは次のように極めてコンパクトです。証拠文(evidence)と検証対象の主張(claim)を渡し、3つのラベルから選ばせると、確定判定とラベルごとの確率分布が返ってきます。
JEV が返した確率分布の中で、最も高い確率値を最大確率 \(q = \max_k p_k\) と定義し、これを「モデルがその判定にどれだけ確信を持っているか」の指標として扱います。
// リクエスト例
{
  "model": "jev-1.13.0",
  "state": {
    "evidence": "The verified ledger records that Aster0 delivered 11 crates.",
    "claim": "Aster0 delivered 11 crates."
  },
  "questions": {
    "verdict": {
      "type": "choice",
      "instructions": "Assess the relation of the claim to the verified evidence only.",
      "criteria": { "supported": "...", "contradicted": "...", "unknown": "..." }
    }
  }
}

// レスポンス例
{
  "answers": {
    "verdict": {
      "type": "choice",
      "choice": "supported",
      "confidence": 1.0,
      "probabilities": { "contradicted": 0.0, "unknown": 0.0, "supported": 1.0 }
    }
  },
  "usage": { "input_tokens": 416, "output_tokens": 42 }
}
確信度カスケード
全件を高価な推論モデルに投げる代わりに、JEV と上位モデル(GPT-6 等)を組み合わせるのが「確信度カスケード」です。
仕組みはとても明快です。
- 1段目で JEV を呼び出し、判定ラベルと最大確率 \(q\) を取得する
- \(q\) をあらかじめ定めた閾値 \(\tau\) と比較する
- \(q \ge \tau\) なら、JEV の判定をそのまま採用して処理を終了する(Accept)
- \(q < \tau\) なら、JEV が迷っていると判断し、元の入力を上位モデルへ転送して再判定させる(Escalate)
さらに、2つの回答を比較するペアワイズ評価では、入力順序を反転させた両パターン \((A, B)\) と \((B, A)\) を実行し、位置を揃えて平均化した確率 \(\bar{p}(A)\) を算出することで、モデル固有の位置バイアス(先頭の選択肢を選びやすい傾向など)をきれいに相殺しています。
JEVの実力と得意・不得意の境界線
研究では JEV を含む17種類のモデル構成を比較し、合計1,300件以上のデータセットで検証しています。その結果から見えてきた要点は次の3つです。
JEVが単独で通用する得意分野
一般的なチャットの選好判定(RewardBench)や、提示された証拠に基づく事実性判定(HaluEval)、多肢選択の最終回答照合では、JEV は最強モデルである GPT-6 Astra に迫る精度を出しました。
通常の選好判定では、JEV(92.2%)と GPT-6(93.5%)の差はわずか1.3ポイントでした。事実性判定(HaluEval)に至っては、ベンチマーク上の数字だけ見ると JEV(87.5%)が GPT-6(86.7%)を上回っています。
ここで興味深いのが、人手によるブラインド裁定です。JEV と GPT-6 の両方が不正解とされた26件を人間が確認したところ、実に24件(約92%)でベンチマーク側の正解ラベルの方が間違っていたことが分かりました。このラベルノイズを補正して計算し直すと、真の正解率は JEV が95.8%、GPT-6 が98.3%となります。いずれにしても「GPT-6 に対して3ポイント以内の僅差に踏みとどまる」という結論は揺らぎません。
それでいて、JEV の費用は1,000判定あたり0.044ドルと、GPT-6(12.182ドル)のわずか0.36%です。応答速度も中央値0.152秒と12倍以上高速でした。1,312件の全リクエストに対してエラーなく有効な出力を返しており、可用性の面でも安定しています。
| 判定 | 通常の選好 (RewardBench) | 難しい正誤 (JudgeBench) | 根拠付き事実性 (HaluEval) | 1,000判定の費用 | 中央値レイテンシ |
|---|---|---|---|---|---|
| JEV 1.13 | 92.2% | 78.6% | 87.5% | 0.044ドル | 0.152秒 |
| GPT-4.1 mini | 89.0% | 64.0% | 86.2% | 0.390ドル | 0.548秒 |
| GPT-5.4 | 93.0% | 90.9% | 88.3% | 4.810ドル | 1.440秒 |
| GPT-6 Astra | 93.5% | 93.1% | 86.7% | 12.182ドル | 1.885秒 |
JEVが明確に負ける苦手分野
一方で、JEV 単独では太刀打ちできない苦手分野もはっきりと分かれています。
1つ目は、客観的な正誤を判定する難関タスク(JudgeBench)です。GPT-6 の93.1%に対し、JEV は78.6%と14.5ポイントの大差をつけられました。ドメイン別に見ると、推論ドメインでは68.4% vs 95.9%、コーディングでは76.2% vs 97.6%と大きく離されています。判定が食い違った箇所のブラインド裁定でも、57対1で GPT-6 の判定が妥当と判断されました。多段階の論理をステップごとに検証するような問題では、思考プロセスを持たない判断専用モデルの限界が現れます。
2つ目は、回答の見栄えや丁寧さに惑わされる「スタイル攻撃(RM-Bench)」への脆弱性です。間違った回答の方が詳細な Markdown で綺麗に装飾されている敵対的なテスト(hard条件)では、JEV の正解率は74.8%まで急落しました(通常条件の84.0%から-9.2ポイント)。一方の GPT-6 は94.6%を維持しており、見栄えの良さに騙されず内容の正しさを冷静に見抜いています。
3つ目は、外部参照(証拠ドキュメント)のない自然文の事実性チェックです。参照証拠を与えずに一般知識の応答を評価させたところ、JEV(52.5%)、GPT-4.1 mini(53.8%)、GPT-5.4(55.0%)のすべてのモデルがコイントス同等の当て推量レベルに沈みました。しかも恐ろしいことに、モデルの平均確信度は90%以上を示しており、どの判定も自信満々に間違える状態に陥っていました。根拠ドキュメントのない自由記述の自動評価は、現在のLLM判定全般にとって未解決の難所です。
確信度カスケードの実力
JEV には得意不得意があるからこそ、確信度カスケードが真価を発揮します。
JEV の最大確率 \(q\) の区間ごとに正解率を調べると、次のように極めて綺麗に単調増加しています。
- \(q < 0.6\): 正解率 47.7%
- \(0.7 \le q < 0.8\): 正解率 76.5%
- \(0.95 \le q < 0.99\): 正解率 93.9%
- \(q = 1.0\): 正解率 99.1%
注目すべきは、同一サンプルにおける GPT-6 の正解率は78.5%〜99.1%の範囲でしか動かないという点です。つまり、GPT-6 が JEV に対して圧倒的な優位性を持つ問題は、「JEV 自身が低い確信度を出して迷っている問題」に集中しています。
あらかじめ閾値決定ルールを凍結した上で、未知の拡張データ(510ペア)に対してカスケードを走らせた結果が次の通りです。
閾値を \(\tau = 0.90\) に設定することで、全体の53.7%を安価な JEV 側で即決し、残り46.3%のみを GPT-6 にエスカレートしました。これにより、GPT-6 単独の正解率93.1%に対して92.5%(差はわずか0.6ポイント、精度維持率99.3%)を達成しながら、費用を56.8%まで削減できています。
安価なモデルで半数以上をさばき、迷ったときだけ高級モデルに頼る設計が、理論だけでなく実測の数字としても成立することが証明された形です。
| ポリシー | 閾値 τ | JEVの受理率 | カスケード正解率 | GPT-6単独正解率 | 精度差 | 費用比(実測) |
|---|---|---|---|---|---|---|
| JEV + GPT-6 Astra | 0.90 | 53.7% | 92.5% | 93.1% | −0.6pt | 56.8% |
どう使い分けるべきか?
実験結果を踏まえて、実務の評価パイプラインをどう設計すべきかを整理しました。
ワークロード別の使い分け方針
| 判定の対象 | 具体的なタスク例 | 推奨する方針 | 理由 |
|---|---|---|---|
| 通常の選好判定 | チャットボットの応答比較、一般的なA/Bテスト | JEV を単独採用 | GPT-6 との精度差がわずか1.3pt。コストを1/200以下に削れる |
| 根拠付き事実性 | RAGの検索ドキュメントと生成文の照合 | JEV を単独採用 | 参照証拠があれば JEV で高精度に判定可能 |
| 最終回答の照合 | 多肢選択の正誤判定、抽出結果の正誤確認 | JEV を単独採用 | 定型的な照合なら差がつかない |
| 難しい論理推論 | 数学・物理の導出過程、ソースコードの正当性検証 | 確信度カスケード(または上位モデル) | JEV 単独では推論力に限界がある |
| スタイル攻撃の懸念 | 誤答が見栄えの良い長文やMarkdownで書かれている | 確信度カスケード(高めの閾値) | 装飾に引きずられて誤判定しやすいため |
| 外部参照のない自然文 | 証拠文書を与えない一般的な事実性チェック | 自動評価を使わない(人手で確認) | 全判定が当て推量レベルに沈む |
現場で導入する際の3つの注意点
1. 閾値は自前のタスクデータで小さく検証して決める
予測確率を後処理で補正する「温度スケーリング」を試したところ、タスクごとに最適な温度がバラバラで、別のタスクに適用するとかえって精度が悪化する現象が確認されました。単一の万能パラメータは存在しないため、エスカレーション閾値 \(\tau\) は自社タスクから数百件のサンプルを抜き出して検証し、独立したテストデータで確認するのが確実です。
2. ペアワイズ評価では順序反転と平均化を必ず入れる
2つの回答を比較させる場合、プロンプトの提示順序によるバイアスはどうしても混入します。\((A, B)\) と \((B, A)\) の両方を評価して確率を平均化する処理をパイプラインに組み込むことで、判定のブレを大幅に減らせます。
3. エラーやパース失敗を「誤り」として監視する
判定評価では、正解率だけでなく「正常に判定を返せた割合」も重要です。JSONのスキーマ違反やレート制限エラーを「除外」して正解率を計算すると、本番での可用性リスクを見落とします。無効出力はすべて誤りとしてカウントし、安定して動いているかを監視する必要があります。
おわりに
これまでの LLM-as-a-Judge は、「精度のために高いAPI費用を甘受して推論モデルを使う」か、「安価な小型モデルで妥協して判定ミスに目をつぶる」かの二者択一になりがちでした。
今回紹介した「判断専用モデル JEV」と「確信度カスケード」の組み合わせは、その二者択一から抜け出す現実的な解です。平易な判定や定型的な事実確認は、推論理由を省いた軽量な判断専用モデルに任せて高速かつ激安で片付ける。そして、モデル自身が「迷った」と判定した難問だけを、ピンポイントで最高峰の推論モデルにエスカレートする。
このハイブリッドなアーキテクチャを導入するだけで、評価の質をほぼ落とさずにAPI費用を4割以上削減できます。自社の評価パイプラインのコストや速度に悩んでいるなら、まずはRAGの根拠チェックやチャットボットの日常評価から、このカスケード構成を試してみる価値は十分にあります。
More Information
- arXiv:2609.26550, Yubo Li, Yidi Miao, Ramayya Krishnan, Rema Padman, 「JEV-as-a-Judge: Accept When Confident, Escalate When Unsure」, https://arxiv.org/abs/2609.26550
関連記事
大規模言語モデルは知性か?現代AIの能力と限界
近年、大規模言語モデル(LLM)が示す驚異的なテキスト生成能力は、我々に「これは真の知性なのか?」という根源的な問いを投げかけています。その流暢さの裏で、LLMが膨大なテキストの統計的パターンを模倣しているだけの「確率的 […]

LiteASR: 低ランク近似による効率的な自動音声認識の実現
近年、OpenAIのWhisperに代表される大規模な自動音声認識(ASR)モデルが目覚ましい発展を遂げていますが、その計算コストの高さが実用上の課題となっています。特に、リアルタイム処理やリソース制約のある環境での利用 […]
BERT-as-a-Judge: LLM評価の精度と効率を両立する新手法
LLMを活用したシステム開発において、モデルの生成した回答が正しいかを正確に評価するプロセスは、システムの信頼性を担保する上で非常に重要です。従来、回答の判定には正規表現(Regex)などを利用した字面の一致に頼る手法が […]