Deep-to-Shallow: Deep Neural Networks の効率的な高速化手法
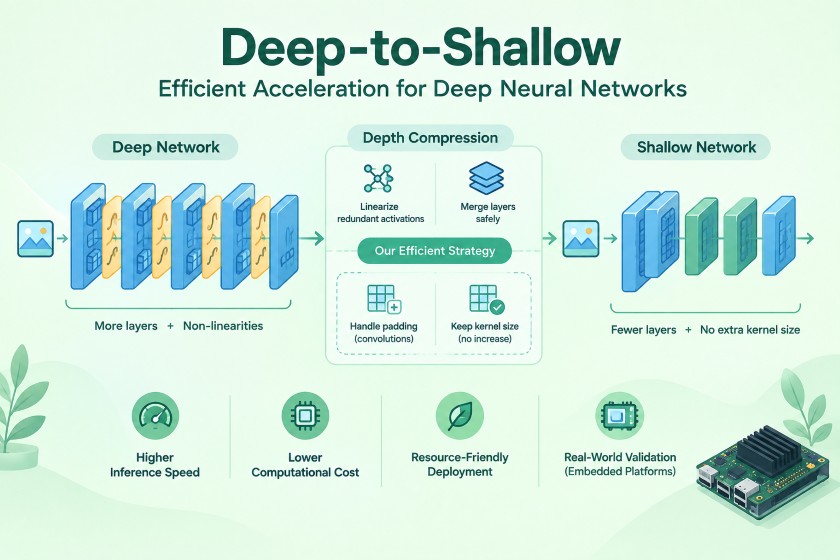
Deep Neural Networks(DNN: 深層ニューラルネットワーク)は、画像認識や自然言語処理をはじめとする様々な分野で中核的な技術となっています。しかし、その高い表現力はモデルの深さと大きさに支えられており、推論に必要な計算量やメモリ、電力消費も比例して増大します。スマートフォンや組み込み機器、Raspberry Piのようなエッジデバイスでモデルを動かそうとするたびに、この計算コストの高さが導入の壁になっている現場は少なくありません。
こうした背景から、モデルの層数そのものを減らして推論を高速化する「Depth Compression」という手法群が研究されてきました。これは、冗長な非線形の活性化関数を恒等写像に置き換え、前後の線形層を1つに統合するというアイデアです。ところが既存手法には2つの実務的な壁が存在します。1つは、パディング付きの畳み込み層をマージする解析的な計算方法が存在しない場合があることです。もう1つは、解析的にマージできたとしてもカーネルサイズが膨らんでしまい、速度向上が相殺されてしまうことです。
こうした制約を回避するアプローチとして、損失関数ベースのレイヤー統合戦略が提案されています。この戦略では、ResNet や MobileNet、Swin Transformer といった複数のアーキテクチャや実機ハードウェアを用いた検証が行われています。
この記事では、既存のレイヤー統合手法が抱える課題の整理から始め、提案されている手法の仕組み(学習可能な層に置き換えるアプローチと3つの損失関数の組み合わせ)について解説します。さらに、複数のアーキテクチャ・データセット・ハードウェアにまたがる実験結果、カーネルサイズ選択や学習効率に関する実装上のヒント、そして限界やトレードオフまでを順に解説します。
1. DNN高速化におけるレイヤー統合の壁
モデル圧縮の手法と Depth Compression の特徴
モデル圧縮の手法には、様々な方向性があります。
- 量子化(Quantization)
- Pruning(枝刈り)
- 低ランク近似
- Depthwise Convolution(深さ方向畳み込み)のような効率的なアーキテクチャブロックの採用
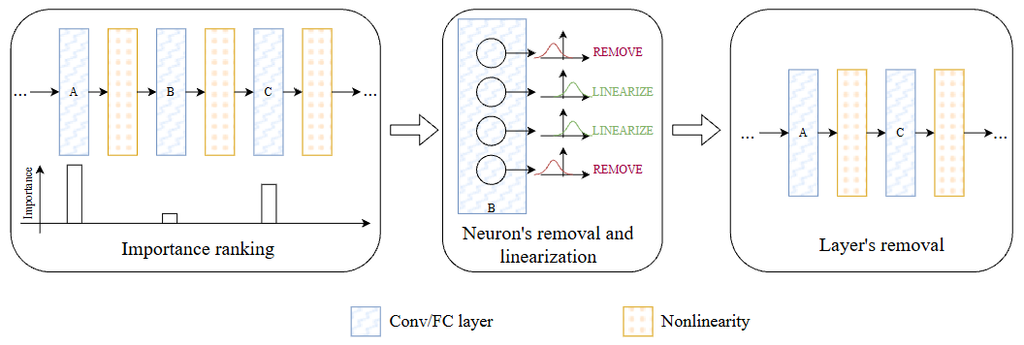
その中で Depth Compression は、パラメータ数ではなく層の数そのものを減らすことを狙う点が特徴です。具体的には、活性化関数のうち出力への寄与が小さいものを恒等写像とみなして線形化し、前後の線形演算(全結合層や畳み込み層)を1つの層に統合します。
活性化線形化の既存手法とその限界
どの活性化を線形化できるかを判定する手法としては、以下のようなアプローチが提案されてきました。
- LayerFolding / DepthShrinker: 学習可能なパラメータやマスクを導入する手法
- EASIER: エントロピーに基づいて情報量の少ない活性化を検出する手法
- TLC: バッチ正規化(Batch Normalization)の統計量を手がかりにする手法
しかし、これらの手法は「どの活性化を線形化するか」を決める段階までしか扱っていません。線形化した後に実際どう層を統合して速度向上につなげるかは別問題として残っています。
畳み込み層統合における2つの実務的な壁
層の統合そのものにも制約が存在します。
- 全結合層の統合: 2つの全結合層は、重みとバイアスの単純な合成によって厳密にマージできます。
- 畳み込み層の統合: 統合後の等価な畳み込みが求まる条件が限られています。特に2つ目の畳み込みがゼロでないパディングを使っている場合には、入力に依存しない解析的な計算方法が存在しません。
加えて、解析的に統合できる場合でも、統合後のカーネルサイズは元の2つのカーネルサイズの和からおおよそ1を引いた大きさまで膨らみます。そのため、計算コストが増加して期待した速度向上が減殺されたり、場合によっては完全に相殺されたりすることが指摘されています。
実際、線形化する活性化の数を増やすだけでは推論時間は改善せず、対応するブロックを効果的に統合できて初めて速度向上につながるという実験的な観察が示されています。「線形化できること」と「実際に速くなること」は別物であるという課題設定が、本手法の出発点となっています。
2. Reference / Shrunkモデルと3つの損失関数
学習によるレイヤー統合とモデル構成
本手法は、解析的な計算式に頼る代わりに、統合後の層の重みそのものを学習によって求めるというアプローチを取ります。
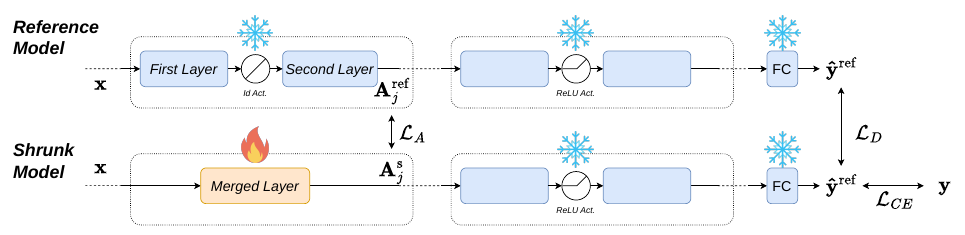
具体的には、以下の2つのモデルを用意します。
- Referenceモデル: 活性化がすでに線形化された元のモデルであり、重みは固定されます。
- Shrunkモデル: 統合対象のブロックだけを1つの新しい学習可能な層に置き換えたモデルです。
統合対象以外の層は、Referenceモデル・Shrunkモデルの両方で完全に凍結します。また、バッチ正規化層も評価モード(統計を固定し、パラメータを更新しない状態)で動作させます。
統合レイヤーの設計とカーネルサイズの自由度
Shrunkモデル側の新しい層は、元のブロックの入力チャンネル数および出力チャンネル数を引き継ぎます。
一方で、カーネルサイズについては以下のいずれかに自由に設定できます。
- 元のブロックと同じ大きさ
- 2つのカーネルサイズのうち大きい方
解析的な計算方法が要求する「2つのカーネルサイズの和から1を引いた大きさ」より小さいカーネルを選択可能です。この点が、パディングの制約とカーネル肥大化という2つの壁を同時に解消する鍵となっています。
3つの目的損失関数
学習の目的関数は、以下の3つの損失で構成されます。
- Cross-Entropy(交差エントロピー)損失(\(\mathcal{L}_{CE}\))
正解ラベルとの分類誤差を測る損失です。一般的な学習手法として広く使われています。 - Knowledge Distillation(知識蒸留)損失(\(\mathcal{L}_D\))
ReferenceモデルとShrunkモデルの出力ロジットを、温度パラメータ\(\tau\)付きのSoftmax関数で近づける損失です。こちらも一般的な学習手法として広く使われています。 - 活性化アライメント損失(\(\mathcal{L}_A\))
本手法の核となる損失であり、次のように定義されています。
$$\mathcal{L}_A = \frac{1}{N_{blocks}} \sum_{j=1}^{N_{blocks}} \frac{1}{N} \sum_{n=1}^{N} | A_j^{ref}(n) – A_j^{s}(n) |_2^2$$
ここで使用される各記号の定義は以下の通りです。
- \(N_{blocks}\): 統合対象のブロック数
- \(N\): ミニバッチのサンプル数
- \(A_j^{ref}(n)\): Referenceモデルにおけるブロック\(j\)のサンプル\(n\)に対する活性化マップ
- \(A_j^{s}(n)\): Shrunkモデルにおけるブロック\(j\)のサンプル\(n\)に対する活性化マップ
つまり、統合後の層がReferenceモデルの対応する出力とどれだけ近い特徴量を出しているかを、L2距離で測る項となっています。
合成損失と重み設定
これら3つの損失は重み付き和として1つの合成損失にまとめられます。
$$\mathcal{L}_{Comb} = w_{CE}\mathcal{L}_{CE} + w_D\mathcal{L}_D + w_A\mathcal{L}_A$$
実験では、以下の重みが使われています。
- \(w_D = 1.97\)
- \(w_A = 0.14\)
- \(w_{CE} = 0.225\)(精度が低いモデルでは \(w_{CE} = 0.5\))
活性化アライメント損失だけに頼ると、ローカルな出力の一致は狙えてもモデル全体としての予測性能までは保証できません。そのため、分類損失と蒸留損失を組み合わせてグローバルな整合性も同時に考慮するアプローチが取られています。
学習手順と推論時の影響
学習は以下の手順で進められます。
- 統合対象の新しい層だけを含むShrunkモデルを構築し、それ以外の層を凍結します。
- 各ミニバッチについて、ReferenceモデルとShrunkモデルの両方で順伝搬計算を行います。
- 上記の合成損失を計算したうえで、逆伝播により統合レイヤーのみを更新します。
ReferenceモデルとShrunkモデルの2つを並列に順伝搬する分だけ、学習時の計算コストは増えます。しかし、この処理は学習フェーズに限定されており、学習が終わったShrunkモデル単体を推論に使う際の速度には一切影響しません。
3. 実験結果
実験設定
実験では、多様なアーキテクチャ、データセット、ハードウェアが用いられています。
- アーキテクチャ(4種類): ResNet18、ResNet50、MobileNetV2、Swin-T Transformer
- 活性化線形化手法: 基本的にEASIER手法を採用
- データセット(2種類): CIFAR-10、ImageNet-1k
- ハードウェア(3種類):
- NVIDIA GeForce RTX 2080 Ti: 3452基のCUDAコア、11GBのGDDR6メモリを搭載
- NVIDIA Jetson Orin: 1024基のCUDAコア、8GBメモリを搭載
- Raspberry Pi 5: 16GBメモリを持つCPUのみのデバイス
線形化活性化数と速度・精度の関係
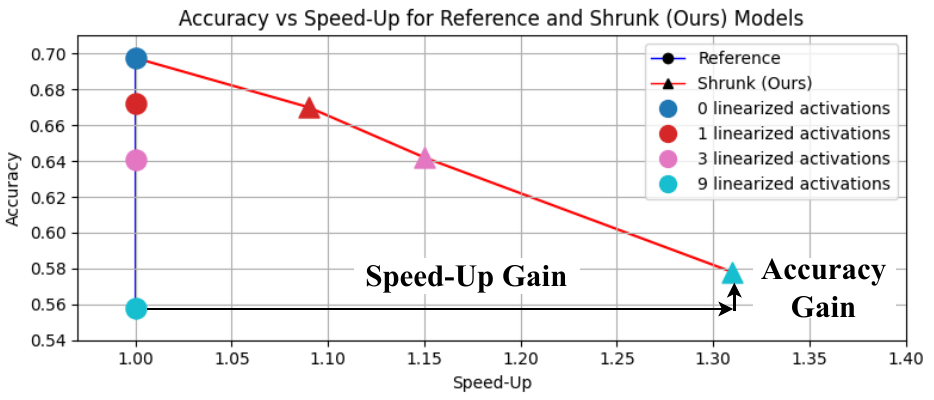
ResNet18において線形化する活性化の数を0個から9個まで増やしていったときの挙動を見ると、両モデルで明確な違いが表れます。
- Referenceモデル: 速度がほとんど変化しないまま、精度だけがおよそ0.70から0.56程度まで低下します。
- Shrunkモデル: 同じ数の活性化を線形化しながら、速度向上を1.00倍からおよそ1.31倍まで積み増しつつ、精度の低下幅を大幅に抑えられます。
線形化した活性化の数を増やすほど、Referenceモデルはただ精度を犠牲にするだけです。それに対し、Shrunkモデルはそれを実際の速度向上に変換できており、本手法の狙いがよく表れています。
解析解との比較
解析的な計算方法が使えるゼロパディング構成のResNet18・CIFAR-10を用いた予備実験では、以下の結果が報告されています。
- 解析解(カーネルサイズ5×5): 精度 91.61%
- 活性化アライメント損失のみ(カーネルサイズ5×5): 精度 91.07%
- 活性化アライメント損失のみ(カーネルサイズ3×3): 精度 90.61% まで悪化
- 合成損失(カーネルサイズ3×3): 精度 91.28% まで回復
3つの損失を組み合わせた合成損失を使うことで、カーネルサイズ3×3のままでも精度が回復し、解析解にかなり近い水準を達成できます。
主要アーキテクチャにおける性能検証
主要な実験結果として、4つのアーキテクチャそれぞれにおける精度と推論時間の削減幅(\(T_{ref}-T_{shrunk}\))は以下の通りです。
| アーキテクチャ | 統合ブロック数 | Reference精度 | Shrunk精度 | Raspberry Pi 5 | Jetson Orin | RTX 2080Ti |
|---|---|---|---|---|---|---|
| ResNet18 | 3 | 63.10% | 64.20% | 17.0ms短縮 | 1.8ms短縮 | 0.5ms短縮 |
| MobileNetV2 | 3 | 70.44% | 70.47% | 2.0ms短縮 | 1.9ms短縮 | 0.6ms短縮 |
| ResNet50 | 2 | 74.93% | 75.08% | 30.0ms短縮 | 2.3ms短縮 | 0.8ms短縮 |
| Swin-T | 2 | 77.54% | 77.51% | 28.0ms短縮 | 1.2ms短縮 | 0.3ms短縮 |
いずれのアーキテクチャでも、ShrunkモデルはReference精度と同等か、わずかに上回る精度を維持しながら推論時間を削減できています。特に、CPUのみのRaspberry Pi 5のようなリソース制約の強いエッジデバイスにおいて、削減幅が大きくなる傾向が見て取れます。
Shrunkモデルの精度がわずかに向上するケースについては、蒸留損失と活性化アライメント損失が線形化済みのReferenceモデルの挙動を保ちつつ、分類損失が一部の予測誤りを補正する副次的な効果によるものと考えられています。
多様な線形化手法に対する汎用性
ResNet18を以下の4種類の異なる線形化手法で線形化した後に、同じ層マージ戦略を適用する比較実験も行われています。
- Smallest Weights
- Smallest Gradients
- TLC
- EASIER
その結果、いずれの手法を用いてもShrunk精度がReference精度と同等以上になること(例えばTLCでは92.63%から92.67%)が確認されています。これにより、本手法が特定の線形化アルゴリズムに依存しない汎用的な後処理として機能することが示されています。
4. 実装・運用のヒント
カーネルサイズの選択とハードウェア特性の比較
実運用でこの手法を使う際に特に重要となるのが、統合後の層のカーネルサイズをどう選ぶかという判断です。
ResNet18・CIFAR-10で7個の活性化を線形化し、4つのブロックを統合する設定において、以下の3つの構成を比較した結果は次の通りです。
- 5×5: 解析解に相当
- 3×3: 元の大きさを維持
- DS3: Depthwise Separable Convolution(深さ方向分離畳み込み、3×3)に置き換え
| カーネル構成 | Shrunk精度 | Raspberry Pi 5 | Jetson Orin | RTX 2080Ti |
|---|---|---|---|---|
| 5×5(解析解相当) | 92.69% | 3.2ms増加(低速化) | 1.5ms増加(低速化) | 0.1ms増加(低速化) |
| 3×3 | 92.32% | 10.4ms短縮 | 0.4ms短縮 | 0.9ms短縮 |
| DS3(Depthwise Separable, 3×3) | 91.79% | 16.3ms短縮 | 2.5ms短縮 | 0.9ms短縮 |
解析解と同じ5×5カーネルは精度こそ最も高いものの、Raspberry Pi 5やJetson OrinのようなCPU寄りのデバイスでは、むしろReferenceモデルより遅くなるケースすらあります。
この要因としては、カーネルサイズを小さくするほど演算量そのものが減るという単純な理由に加え、ハードウェア特性の違いが挙げられます。
- compute-bound(演算量そのものが律速する)なデバイス:
Raspberry Pi 5やJetson Nanoなどでは、3×3カーネルが1.12〜1.15倍の安定した速度向上を生む一方、5×5カーネルはほとんど効果がないか、むしろ低速化します。 - launch-bound(カーネル起動のオーバーヘッドが律速する)なデバイス:
Jetson Orinなどでは、両者の速度差が小さくなります。
こうした特性を踏まえ、MobileNetV2を除くアーキテクチャでは、3×3カーネルがデフォルトの構成として採用されています。
ImageNetスケールでの検証
同様の傾向はImageNetスケールでも確認されています。事前学習済みのモデル内部にある近似的な恒等ブロックをマージした場合、以下の結果となっています。
- ResNet18(3ブロック統合): Shrunkモデルは精度68.05%を維持(Reference精度は69.76%)
- ResNet34(6ブロック統合): Shrunkモデルは精度67.99%を維持(Reference精度は73.30%)
解析解による手法では追加学習なしに精度を回復できませんが、Shrunkモデルは高い精度を維持できることが示されています。
学習効率の実務的メリット
学習効率の面でも実務上のメリットが示されています。同じ目標アーキテクチャに対して、以下の手法を比較した結果が報告されています。
- Cross-Entropy損失のみによるフル再学習: 43分
- 標準的なKnowledge Distillation: 41分
- 活性化アライメント損失を加えたKnowledge Distillation
- 提案手法(マージ層以外を凍結し合成損失で学習): わずか14分で最高精度92.79%に到達
提案手法が短時間で収束するのは、マージ対象以外の層を凍結することで学習対象のパラメータ数が絞られ、収束が速くなるためです。
損失関数の組み合わせに関するAblation実験
損失の組み合わせに関するablation実験からは、以下の知見が得られています。
- 活性化アライメント損失のみを使用した場合: 4ブロックを統合したCIFAR-10のShrunkモデルの精度は10.00%、つまりランダムな推測と同水準まで崩壊します。
- 蒸留損失またはCross-Entropy損失を組み合わせた場合: どちらか一方を組み合わせるだけで、精度はReference精度(92.68%)に対して0.4ポイント差の92.32%程度まで回復します。
- Referenceモデルの精度に応じた挙動の違い:
- Referenceモデルの精度が高い場合: 蒸留損失が支配的に機能します。
- Referenceモデルの精度が低い場合(Tiny ImageNetで40.92%): Cross-Entropy損失がReferenceモデルの誤った予測を補正する役割を果たします。
これらの結果は、ローカルな出力の一致だけでは不十分であり、モデル全体のグローバルな予測性能まで考慮した学習が必要であるという本手法の中心的な主張を裏付けています。
5. 限界とトレードオフ
本手法を導入する前に押さえておきたい限界やトレードオフとしては、以下の点が挙げられます。
- 損失重みのチューニング範囲が限定的:
実験で使われた損失の重み(\(w_D=1.97\)、\(w_A=0.14\)、\(w_{CE}=0.225\))はCIFAR-10の実験でのみ一度だけ最適化されたものであり、より丁寧なハイパーパラメータ探索によってさらなる精度改善の余地があるとされています。 - カーネルサイズ選択は自動化されていない:
5×5・3×3・DS3のどれを選ぶかによって精度と速度のトレードオフが大きく変わるため、デプロイ先のハードウェア特性を踏まえてユーザー側が判断する必要があります。 - 精度向上は主目的ではなく副次的な効果:
ShrunkモデルがReferenceモデルよりわずかに高い精度を示すケースが観測されていますが、これは追加学習の副産物であり、精度向上そのものを狙って設計された仕組みではありません。 - 検証範囲が画像分類系アーキテクチャに限られる:
ResNet系、MobileNetV2、Swin-T Transformerという画像分類向けのモデルで検証されており、大規模言語モデルなど他分野・他モダリティへの適用可能性については直接的な検証は行われていません。 - 学習時の計算コストは増加する:
ReferenceモデルとShrunkモデルを並列に順伝搬する必要があるため、推論速度には影響しないものの、学習時の計算資源やメモリ要件は増える可能性があります。
おわりに
パディングのある畳み込み層のように解析的な計算方法が存在しない構成に対しても、損失関数を使って層の統合そのものを学習するというアプローチによって、Depth Compressionの恩恵を実際の推論速度向上として引き出せるようになります。ResNet18・ResNet50・MobileNetV2・Swin-T Transformerという4つのアーキテクチャと、GPUからCPUのみのエッジデバイスまで特性の異なる3つのハードウェアで一貫した効果が確認されている点は、実運用を見据えた検証として説得力があります。
実務での導入を考える際には、Raspberry Pi 5のようなCPU寄りのエッジデバイスほど恩恵が大きいこと、そしてカーネルサイズの選択はデプロイ先が compute-bound か launch-bound かによって最適解が変わることを踏まえて判断するのが適切です。また、活性化アライメント損失だけでは精度が崩壊しうるため、分類損失や蒸留損失と組み合わせた学習設計が欠かせない点も、実装時に押さえておきたいポイントです。今後は、損失重みの自動チューニングや、画像分類以外のタスク・アーキテクチャへの適用範囲の拡張が発展の方向性として考えられます。
More Information
- arXiv:2609.04881, Petro Shulzhenko, Gabriele Spadaro, Enzo Tartaglione, 「From Deep to Shallow: Unconstrained and Efficient Layer Merging Strategy」, https://arxiv.org/abs/2609.04881
関連記事
Physics Is All You Need?~ AIエージェントは「答え」を最適化するが、「真理」は探究できない~
AI技術が飛躍的に進歩する中、「AIは科学研究のパートナーになれるのか?」と考える方も多いのではないでしょうか。しかし、科学的ソフトウェアの開発においては、単に「テストを通過する」ことではなく、「物理法則と一致しているか […]

Group-Evolving Agents: 経験共有によるAIの自己進化
LLMエージェントの開発において、人間の介入なしにシステムが自らの構造を改善し続ける「自己進化(Open-Ended Self-Improvement)」のアプローチが注目を集めています。しかし、従来の自己進化は「個体単 […]

Skillware: 振る舞いがソフトウェアになる時代
Claude Code、GitHub Copilot、Codexといった主要なAgent Host上で、SKILL.md という1枚のファイルにタスクの手順を記述することでエージェントの振る舞いを拡張する「Agent S […]