Thinking Inertia: なぜLLMは「考えるな」と言われても思考を止められないのか?
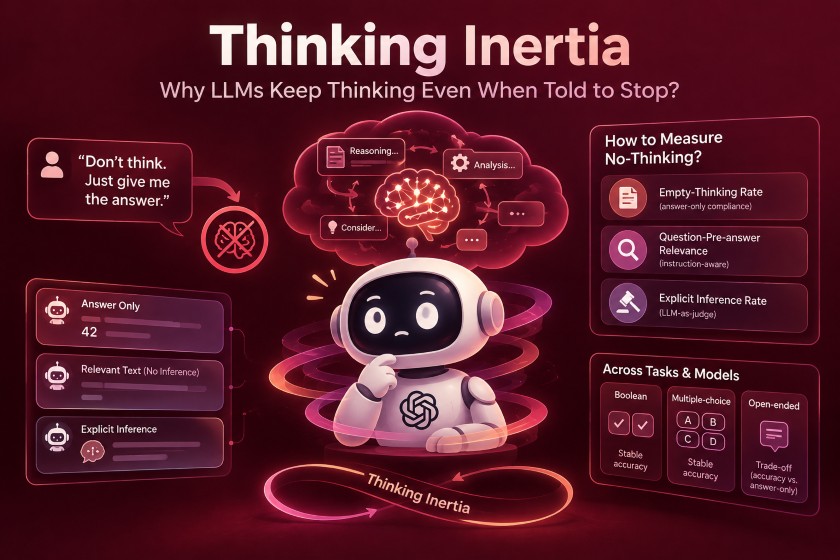
最近のLLMには、推論の過程を長く書き出す「思考モード」が標準で備わるようになりました。推論によって精度は向上しますが、トークン消費とレイテンシも増加します。そのため、「推論は不要なので答えだけを返してほしい」という場面で、思考モードをOFFに設定したり、「理由は書かずに答えだけ出力して」とプロンプトで指示したりした経験のある方は多いのではないでしょうか。しかし、そうした制御によって実際に答えだけが返ってくるのかについては、これまであまり検証されてきませんでした。
この「考えさせない」制御がどこまで有効なのかについて、詳細な検証(Dianqiao Lei et al. 2026)が行われています。そこでは、思考モードの無効化、<think>タグの有無、出力の短さといった従来の判定基準はどれも当てにならないと指摘されています。そのうえで、応答の中身を3段階で測定する評価フレームワークが提案され、6種類の主要なLLMを用いて実験が行われました。その結果として得られた主な知見は、明示的な no-think 指示をどれほど重ねても、可視の推論は簡単には消えないという事実です。この現象は Thinking Inertia(思考の慣性) と呼ばれています。
この記事では、「考えない」状態をどのように定義して測定するのか、実験の設計と検証結果、実務における具体的な示唆、そして検証において前提とされている限界について順に解説します。
1. 「考えない」を測る難しさ
従来の表層的な判定基準とその限界
LLMにおける no-thinking(思考を行わない状態)は、従来は主に以下の3つの表層的な基準で判定されることが一般的でした。
| 判定基準 | 内容 | 失敗例 |
|---|---|---|
| プロンプト側の制御 | no-think設定にする、step by stepを促さない | 思考モードOFFでも「両辺から1を引いて3x=9、よってx=3」と説明が出る |
| 形式上の制御 | <think>ブロックがない、推論の別出力がない | タグはなくても、通常の回答欄に推論がそのまま書かれる |
| 長さによる制御 | 出力が短ければ推論が少ないとみなす | 「3x=9, so x=3」のように短くても推論の1ステップが含まれる |
これらの基準自体が本質的に誤っているわけではありません。問題は、いずれの基準も「応答の中身」を精査していない点にあります。
- 定型表現の誤判定: 「Let me think about this. The answer is …」のような定型の前置きは推論ではないにもかかわらず、長さや形式の基準では推論と区別がつきません。
- 短い推論の見落とし: わずか1行の短い数式であっても、そこには明確な推論のステップが含まれて露出することがあります。

応答の分解定義:pre-answer text と最終回答
そこで、モデル \(\pi\) が介入 \(S(\cdot)\) を施された質問 \(Q\) に対して返す応答を、次のように2つの要素へと分解して評価します。
$$\pi\big(S(Q)\big) = (T, A)$$
各要素の定義および注意点は次のとおりです。
- \(A\)(最終回答): 応答の末尾から抽出・解析された最終的な回答です。
- \(T\)(pre-answer text): 最終回答 \(A\) よりも前に現れる、閲覧可能なすべてのテキストです。推論専用の欄に含まれているか、通常の回答欄の冒頭に書かれているかを問いません。
- 対象範囲の限定: この定義はあくまで表面上に現れる「可視の出力テキスト」のみを対象としています。モデル内部で行われている潜在的な計算処理については何も主張しない、という点が明記されています。
2. 3段階の評価指標
応答パターンの比較例
pre-answer text(\(T\))の評価には、基準の厳しさに応じた3段階の指標が用いられます。質問が「42 + 79 = ?」で最終回答がすべて「121」となる6つの応答例を比較すると、各指標の違いが明確になります。
| 応答例の \(T\) | 長さ | ETR | 質問との関連 | 推論 |
|---|---|---|---|---|
| 空(回答のみ) | なし | 1 | なし | なし |
| 「一の位 2+9=11、繰り上げ1…」 | 短い | 0 | 高い | あり |
| 「答えは121です」 | 短い | 0 | 低い | なし |
| 「計算が必要です。一の位…」 | 長い | 0 | 高い | あり |
| 「面白い算数の問題です。数学は…」 | 長い | 0 | 低い | なし |
| 「足し算は和を求める演算です。この組の和は121です」 | 長い | 0 | 中程度 | なし |
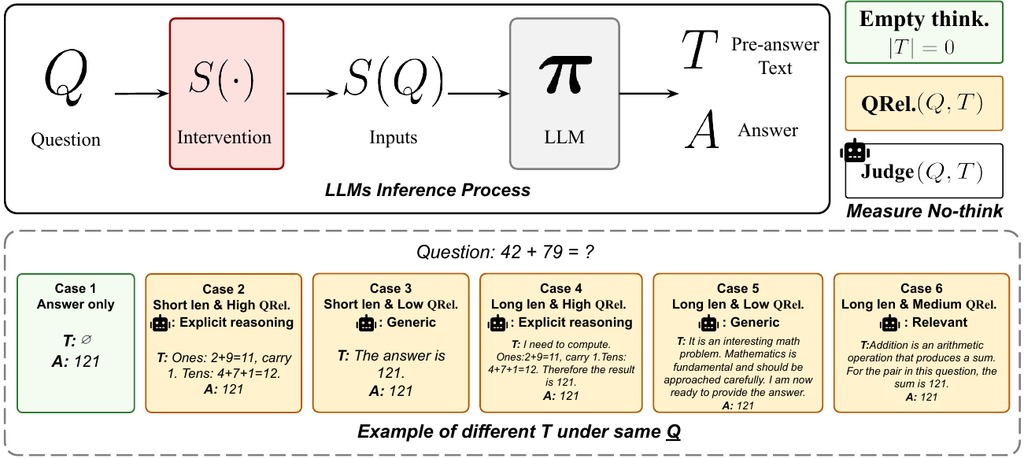
Level 1: Empty-Thinking Rate(ETR)
1つ目は、回答がどこまで厳密に「答えのみ」であるかを見る指標です。\(N\) 個の出力のうち、\(T_i\) が空である割合を求めます。
$$e_i = \mathbb{1}\{|T_i| = 0\},\quad \mathrm{ETR} = 100 \times \frac{1}{N}\sum_{i=1}^{N} e_i$$
判定条件および指標の特徴は以下のとおりです。
- 合格の条件(\(e_i = 1\)): 最終回答が解析可能であり、かつ許された回答の枠外に実質的なテキストが一切存在しない場合のみ合格となります。
- 不合格の条件: 回答のあとに説明が続いた場合も不合格と判定されます。
- 指標の特徴: ETRは最も明快な判定基準ですが、\(T\) が空でなくなった段階で、定型句・言い換え・推論の区別がつかないという側面があります。
Level 2: Question–Pre-answer Relevance(QRel.)
2つ目は、\(T\) が質問とどれだけ意味的に近いかを連続値で測定する指標です。
- 指示付きの埋め込みモデルである「Qwen3-Embedding-4B」を使用します。
- 質問を「回答に関係する推論を含む前置きテキストを検索するクエリ」として埋め込みます。
- \(T\) を検索対象の文章として埋め込みます。
- それぞれの埋め込みベクトルを \(\ell_2\) 正規化し、コサイン類似度を算出します。
$$\mathrm{QRel.}(Q_i, T_i) = \begin{cases} 0 & |T_i| = 0 \\ \cos\big(\phi(Q_i), \phi(T_i)\big) & |T_i| > 0 \end{cases}$$
空の \(T\) には0を割り当て、その0も含めて平均を計算します。ただし、質問の言い換えや回答の主張だけでも高いスコアが出るため、QRel.はあくまで「関連性の目安」として位置づけられており、推論が存在した証拠としては用いられません。
Level 3: Explicit Inference Rate(EIR)
3つ目は、推論の有無を直接判定する指標です。
判定にあたっては、モデル名、介入の種類、最終回答、正誤、QRel.の値を伏せ、質問と \(T\) だけをGPT-5.5に渡して分類させます。付与されるラベルは以下の5つで、互いに排他的です。
| ラベル | 基準 |
|---|---|
| Generic/off-topic | 定型の前置きや形式的な文、無関係な内容。質問固有の推論なし |
| Paraphrase-only | 質問や与えられた事実を言い換えただけで、推論でつないでいない |
| Relevant non-inferential | 関連する事実や定義、回答の主張はあるが、推論ステップがない |
| Explicit reasoning | 演繹、計算、比較、消去、規則の適用、因果などがある |
| Unclear | 見えているテキストからは判定できない |
判定ルールおよび計算式は以下のとおりです。
- 判定ルール: Explicit reasoningと判定された場合のみを「1」とします。短くても、浅くても、あるいは最終的に間違っていたとしても、推論ステップが1つでも含まれていれば該当します。また、空の \(T\) はジャッジに送らず自動的に「0」とします。
$$\mathrm{EIR} = 100 \times \frac{1}{N}\sum_{i=1}^{N} \mathrm{Judge}(Q_i, T_i)$$
評価指標の人手評価による妥当性検証
これらの指標が人間の感覚と合致しているかについても検証されています。600件の出力を5人のアノテーターが評価した結果は以下のとおりです。
- ETRの一致率: 手作業で確認した「Tが空かどうか」と565/600件(94.2%)で一致しました。残りの差は、回答形式の要件を満たさなかったことによるものです。
- QRel.の相関: 5人の関連度評価との平均Spearman相関は \(\rho = 0.829\) でした(比較対象とした all-MiniLM-L6-v2 の相関は 0.809)。
- EIRの一致率: 人手の推論ラベルとGPT-5.5判定の平均一致率は98.8%に達し、別系統のClaude Opus 4.8による判定とも96.7%の一致を示しました。
3. 実験の設計
6つの介入モード
実験では、no-think の強さを1本の軸に並べた6つの介入モードが用意されました。
PREFIXは指示文を追加するのではなく、生成の出だしを固定することで指示の処理経路を迂回する手法です。そのため、STRICTの強化版ではなく別系統のアプローチとして扱われています。
| モード | 内容 | 強度 |
|---|---|---|
| THINK-ON | 公式の思考モードを有効化 | 思考を促す側(基準) |
| THINK-OFF | 思考モードを無効化。追加の指示なし | 0(自然な基準) |
| COT | 思考モードは無効のまま「Think step by step」を追加 | 思考を促す側(基準) |
| SOFT | 「短い前置きは可、説明は不可」と指示 | + |
| STRICT | 「推論なしで最終回答を直接出力せよ」と指示 | ++ |
| PREFIX | 回答テンプレート「The answer is \boxed{」を生成の冒頭に埋め込む | +++ |
評価対象のLLMモデル
評価対象として、以下の6モデルが選定されています。
- Qwen3: 4B、32B、235B-A22B の3サイズ
- DeepSeek-V4-Flash: 284B
- GPT-5.4
- Gemini-3-Flash
これらのモデルはすべて思考モードの切り替え機能を提供しているため、出力の長さや形式から推測することなく、介入による変化を直接検証できます。
回答空間に応じた3系統のベンチマーク
ベンチマークは、回答空間(答えの候補がどれだけ開かれているか)の広さに応じて3系統に分類されています。
| 回答空間 | 内容 | ベンチマーク |
|---|---|---|
| Boolean | yes/noの判定 | BoolQ、StrategyQA |
| 選択式(MCQ) | 選択肢からラベルを返す | MMLU、MMLU-Pro |
| 自由記述(Open-ended) | 候補なしで答えを生成する | GSM8K、MATH |
4. 思考モードOFFの限界と回答空間の階段
思考モードON/OFFによる推論抑制の効果
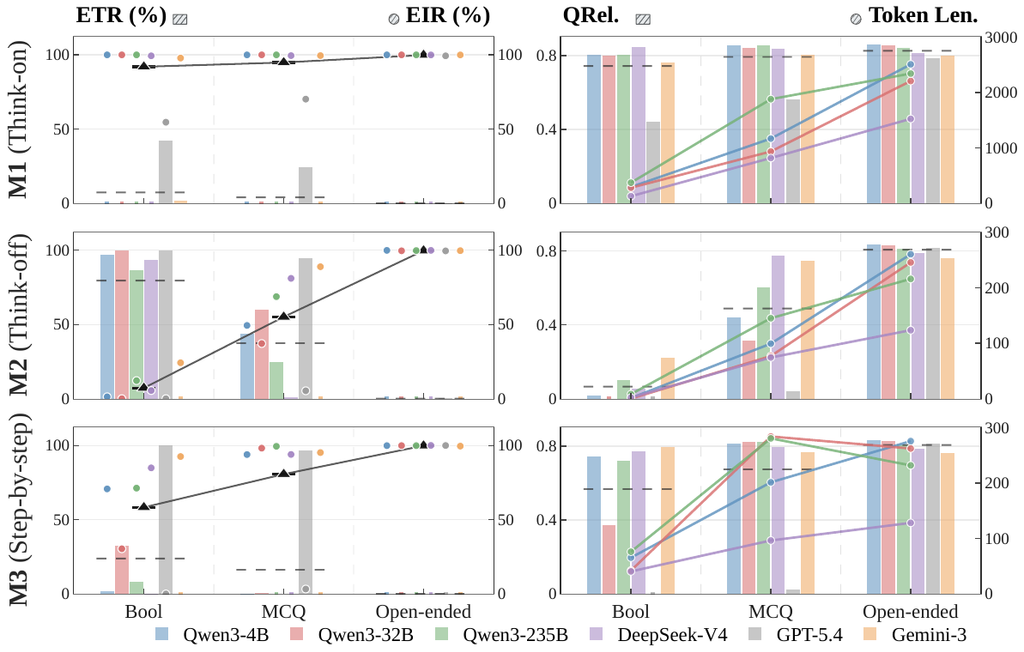
思考モードのON/OFFが可視の推論をどこまで抑制できるかについて調べた結果、回答空間によって挙動が大きく異なることが判明しました。
- THINK-ON: ほとんどのモデルおよびタスクでETRがほぼ0%となり、QRel.とEIRは高水準を示します。
- THINK-OFF(Boolean課題): ほとんどのモデルでETRが約80〜100%に上昇し、QRel.とEIRは大きく低下します。
- THINK-OFF(選択式課題): モデルによってETRが0%近傍から95%まで大きくばらつきます。
- THINK-OFF(自由記述課題): ほぼすべてのモデルでETRが0%近くに落ち込み、EIRは高いまま維持されます。
具体的な例として、DeepSeek-V4-Flash では思考モードを無効化しても、自由記述タスクにおける応答の99.9%に明示的な推論が残存していました。
Thinking Inertia(思考の慣性)の発現と考察
この現象は Thinking Inertia(思考の慣性) と呼ばれています。
可視の推論の有無は、思考モードのスイッチ状態よりも課題の回答空間によって決まり、Boolean → 選択式 → 自由記述 の順に残りやすくなります。その理由として、あらかじめ候補が存在しない空間で答えをゼロから組み立てる場合、途中の計算ステップをより多く必要とするためではないかと考察されています。
思考モードOFF時におけるCOT指示の影響
逆方向の操作についても確認されています。思考モードをOFFにした状態であっても、プロンプトに「Think step by step」などのCOT指示を追加すると、QRel.とEIRはTHINK-ONと同等の水準へと戻ります。Boolean課題においても多くのモデルで同様の傾向が見られました。
それでもなお、モデル平均のEIRは「Boolean < 選択式 < 自由記述」という順序関係を維持しました。例外としてGPT-5.4は、Booleanおよび選択式(MCQ)において高い answer-only 遵守率を維持しています。
出力長および言い換えとの関係性検証
QRel.が出力の長さを単に反映した代理指標ではないことも確認されています。THINK-ON条件では4モデルすべてにおいて、Booleanから自由記述にかけて出力トークン長が大幅に伸長したものの、QRel.の変化は小さくとどまっていました。
また、QRel.の高さが質問文の単なる言い換えによるものではないことも、全572,688件の出力を監査することで確かめられています。
- 逐語的な繰り返し: ほぼ逐語的な繰り返しと判定されたのは301件(0.053%)でした。
- 言い換えのみ: paraphrase-only のラベルが付与されたのは355件(0.06%)にとどまりました。
5. 指示を強めた場合のトレードオフ
STRICT指示による抑制と no-thinking–performance trade-off
THINK-OFFをベースとして、指示をSOFT、STRICTへと強めた際の変化を回答空間別にまとめると、以下のようになります。
| 回答空間 | EIRの変化 | 精度 |
|---|---|---|
| Boolean | 5.15% → 0.12% | 約85%でほぼ横ばい |
| 選択式 | 45.57% → 25.39% | 大きな低下はなし |
| 自由記述 | 99.69% → 62.00% | 平均で約15ポイント低下 |
自由記述タスクにおいて思考モードを無効化できる5モデルでは、平均ETRがほぼ0%から約40%へと上昇する一方で、精度は約15ポイント低下します。厳しい指示を与えることで「答えのみ」の応答は増加するものの、自由記述タスクでは精度を犠牲にしてしまうことになります。
さらに、指示を厳格化してもEIRは依然として62.00%残存しており、推論プロセスを完全に抑え込むことはできません。この現象は no-thinking–performance trade-off(思考抑制と性能のトレードオフ) と呼ばれています。
回答テンプレート固定(PREFIX)の限界
もう1つの重要な発見は、回答テンプレートを冒頭に挿入するPREFIX手法が、STRICTよりも強い抑制効果を発揮しなかったという点です。
- ETRの低下: 選択式および自由記述タスクにおいて、平均ETRはSTRICT条件よりも低下しました。
- 推論指数の再上昇: QRel.およびEIRは、すべての回答空間において再び上昇に転じました。
回答の書き出し部分を固定したとしても、モデルはその直後のテキストで推論や説明を書き始めてしまう場合があります。つまり、出力の表面的な形式を強制的に縛ったとしても、可視の推論を排除することはできないと考えられます。
6. 分野の違いと回答空間の書き換え
MMLU分野別の差異:STEM分野の特異性
回答形式を4択に固定した状態で、MMLUの各専門分野を比較した結果も報告されています。
STEM分野では、評価対象となった4モデルすべてで精度が最も高かった一方で、ETRは0.3〜36.4%と最も低い数値を記録しました。逆に、QRel.(0.509〜0.784)とEIR(59.7〜85.5%)は最も高い水準を示しています。
この結果は、「正答率が高い問題ほど答えだけで簡潔に済ませやすい」という単純な関係性が成り立たないことを示しています。推論の現れやすさには、回答空間の広さだけでは説明しきれない専門分野固有の差異も存在することが分かります。
同一問題における回答形式の書き換え実験
最も厳密に統制された比較として、同一の数値問題に対してタスクの形式のみを書き換える実験が行われました。Qwen3-32B(think-off条件)を用い、MMLU系の数値問題を「元の4択選択式」「Boolean(提示された解の正誤判定)」「自由記述」の3形式に書き換えて比較しています。
| 回答形式 | 精度 | ETR | QRel. | EIR |
|---|---|---|---|---|
| 選択式(元の形式) | 77.8% | 10.5% | 0.709 | 86.95% |
| Boolean(提案された答えの正誤を判定) | 78.9% | 62.5% | 0.314 | 36.90% |
| 自由記述 | 52.6% | 0% | 0.810 | 90.14% |
この実験結果から、以下の点が明らかになりました。
- Boolean化による効果: 精度をほぼ維持したまま(77.8% → 78.9%)、ETRは10.5%から62.5%へと大幅に向上し、EIRも36.90%へと大きく低下しました。
- 自由記述化による影響: ETRは0%へと落ち込み、精度も52.6%まで大きく低下し、EIRは90.14%と極めて高い水準に達しました。
質問の中身自体が同一であっても、「答えの候補が提示されているかどうか」によって、モデルが推論を挟まずに直接回答できるかが大きく左右されます。この結果から、ベンチマークごとの難易度差や回答テキストの長さの違いだけでは、本パターンの挙動を説明できないことが示されています。
7. 実務への示唆
一連の検証結果と考察から、LLMをシステムに組み込む実務において以下の重要な示唆が得られます。
- 指示のみによる思考抑制の限界を認識する
- 思考モードのOFF設定やプロンプトによる「推論するな」という指示だけでは、出力を「答えのみ」に制御できるとは限りません。
- 特に自由記述タスクにおいては、どれほど厳格に抑制を試みても、ほぼ確実に推論プロセスが出力されてしまいます。
- タスク設計による回答空間の制限を活用する
- 入力形式を変更できるタスクであれば、プロンプトにあらかじめ選択肢や検証対象の候補を提示するだけで、推論を挟まないダイレクトな回答が出力されやすくなります。
- プロンプトエンジニアリングやインターフェース設計の段階で回答空間を絞り込む工夫が極めて有効です。
- 回答空間に応じたタスクルーティングの実装
- 回答空間が十分に限定されており直接回答が可能なタスクでは、思考を抑制してレイテンシとトークンを削減します。
- 一方で、思考を抑制すると精度が大きく低下してしまう複雑なタスクでは、明示的な推論ステップを許容します。
- このように、タスクの性質に応じてモデルや指示を切り替えるルーティング機構の導入が有効です。
- 適切な評価指標を用いたモニタリング
- 推論抑制の制御効果を測定する際は、単に出力トークンの長さだけで判断してはいけません。
- 出力が完全に答えのみであるかを見る「ETR」や、推論プロセスの有無を直接判定する指標を併用し、多角的に評価・監視することが不可欠です。
8. 限界と適用条件
本検証における知見や主張は、適用範囲が前提条件によって限定されている点に留意する必要があります。
- 可視テキストのみを対象とした評価
- 分析対象はあくまでユーザーから確認できる「表面上の可視テキスト」に限定されています。
- モデル内部の潜在的な計算処理が実際に停止しているかどうかは検証されておらず、表面的なテキスト量が減少したからといって、内部の計算コストや推論負荷が低減しているとは限らない点に注意が必要です。
- 検証環境とタスクの限定性
- 実験は6種類のモデルおよび6種類のベンチマークを対象としており、可能な限り決定論的なデコード設定を前提としています。
- 多言語処理、ソースコード生成、ツール利用(Function Calling等)、マルチターン対話、確率的サンプリングでの生成、ならびに頻繁にアップデートされる商用APIへの適用については未検証の領域です。
- 評価指標の制約とジャッジモデルへの依存
- QRel.はあくまで質問とpre-answer textとの意味的な関連性の目安を示す値にとどまります。
- EIRの判定精度は、設定した評価ルーブリックおよびジャッジを担当するLLMの較正状態に依存します。別系統のジャッジモデル(Claude Opus 4.8等)を用いた再現性検証によって補強されているものの、判定モデルへの依存性そのものは排除できません。
おわりに
重要な結論として、LLMにおける no-thinking(思考を行わない状態)の成否は、スイッチのON/OFFや出力テキストの短さといった外見ではなく、生成された応答の中身そのもので評価すべきだという点が浮き彫りになりました。応答を pre-answer text と最終回答に分離し、ETR、QRel.、EIRという多層的な指標で測定することで、思考モードをOFFにしたり厳格な指示を与えたりしても可視の推論が根強く残存すること、そして推論の残りやすさが回答空間の広さに強く依存すること、さらに自由記述タスクでは思考の抑制が精度の著しい低下を招くことが明らかになりました。
LLMを実務で運用する際は、プロンプトに「考えるな」と書き加える前に、まずはタスクの形式そのものを見直すアプローチが効果的です。Boolean判定や選択式として設計できる処理には直接回答させ、複雑な数値の導出などが求められる処理には明示的な推論を許容する、といった適切な切り分けが求められます。コスト削減を目的とする場合も、表面上の出力が減ったか否かだけで判断するのではなく、実際のトークン消費量と精度のバランスを測定しながら検証を進める必要があります。
今後の技術的な展望としては、思考を一律に禁止・抑制するのではなく、状況に応じて必要なタイミングで適切に思考を停止できるよう、モデル自体を較正・学習させていく方向性が示されています。
More Information
- arXiv:2610.11765, Dianqiao Lei, Kevin Qinghong Lin, Pan Lu, Philip Torr, James Zou, 「Thinking Inertia: LLMs Keep Thinking When Told Not To」, https://arxiv.org/abs/2610.11765
関連記事

2024年、LLM研究の最前線:必読論文総まとめ
大規模言語モデル(LLM)は、もはや一部の研究者や開発者にとどまらず、私たちの生活に身近な存在となっています。文章生成、翻訳、情報検索など、その応用の場は多岐にわたります。 しかし、LLMの進化はそれだけにとどまりません […]

YOLOv12: アテンション機構による高速物体検出
近年、深層学習を用いたコンピュータービジョンは目覚ましい進化を遂げ、私たちの生活やビジネスに大きな変革をもたらしています。特に物体検出技術は、自動運転、監視システム、医療画像解析など、幅広い分野で不可欠な技術となっていま […]
Prompt Repetition: プロンプト反復によるLLMの改善
LLMの精度向上のために、日々プロンプトの試行錯誤を繰り返しているエンジニアは多いはずです。Google Researchの研究チームは、そのような課題に対し、非常にシンプルかつ強力な解決策である「Prompt Repe […]