Context Language Models: コンテキストを直接編集・自己管理するLLMの次世代アーキテクチャ
数十時間にわたって動き続けるAIエージェントを運用していると、精度以前にコンテキストの肥大化という壁にぶつかることがあります。検索結果やツール呼び出しのログ、過去のやり取りが際限なく積み上がり、コンテキストウィンドウの上限に達すると、何を残し何を捨てるかという判断が必要になります。これまでこの判断は、人間が設計した「ハーネス(harness)」と呼ばれる制御プログラムに委ねられてきました。一定の長さに達したら要約する、あるいは決まったツールで古い情報を退避するといった固定ルールです。しかし、モデルが実際に何を重要だと判断するかは、タスクや局面によって大きく変わります。そのため、あらかじめ人間が決めたルールがそれに追いついているとは限りません。
このギャップに正面から切り込んだのが、ワシントン大学、Meta Superintelligence Labs、MIT、Trillium Labsなどによって開発された Context Language Models(CLM)です。CLMでは、コンテキストそのものをモデルが自由に書き換えられる1つのファイルとして扱うというシンプルな発想が採られています。既存のモデルにこの仕組みを与えるだけで(追加学習なしに)、人間が設計したコンテキスト管理戦略を上回る精度と計算効率を達成できます。Deep Researchタスクでは最も強力なベースラインに対して11.4%の精度向上と21.5%の計算量削減を同時に達成し、12時間規模のリポジトリ最適化タスクでは59%少ない計算量で5%高いスコアを記録した、といった結果が実証されています。
この記事では、CLMがどのような設計思想と実装でこの成果を実現しているのか、既存手法との比較でどれだけの差が出ているのか、そしてコンテキスト管理という能力自体をIn-Context学習や強化学習でさらに鍛えていく仕組みについて順を追って解説します。あわせて、実際にエージェント運用へ組み込む際に押さえておきたいポイントや、安全性、サービング側の制約といった限界についても触れていきます。
1. 既存のコンテキスト管理が抱える限界
長時間稼働するエージェントのコンテキスト管理について、既存のアプローチは大きく2つの系統に整理できます。
既存アプローチの2大系統とその課題
- ハーネス主導型アプローチ
- 代表例: Cursor Composer、Codex CLI、Terminus2など
- 特徴: コンテキストが一定の長さに達した時点で、あらかじめ決められた手順に沿って要約が実行されます。いつ、どのようにコンテキストを書き換えるかは、すべてハーネス側に固定されています。
- 行為ベース型(action-based)アプローチ
- 代表例: Self-Compact、AutoCompact、Context-as-a-Tool、ACM(Agentic Context Management)など
- 特徴: モデル自身が「いつ圧縮するか」「いつオフロードや検索を行うか」を選択できます。モデルの自律性が広がっているように見えますが、実際に使える操作の種類(要約・退避・検索など)は、人間があらかじめ定義した有限の集合に限られたままです。
この系統の進歩によってモデルの裁量は少しずつ広がってきたものの、操作そのものの設計は依然として人間の手に委ねられていると整理できます。
診断用ベンチマーク「ContextBench」による検証
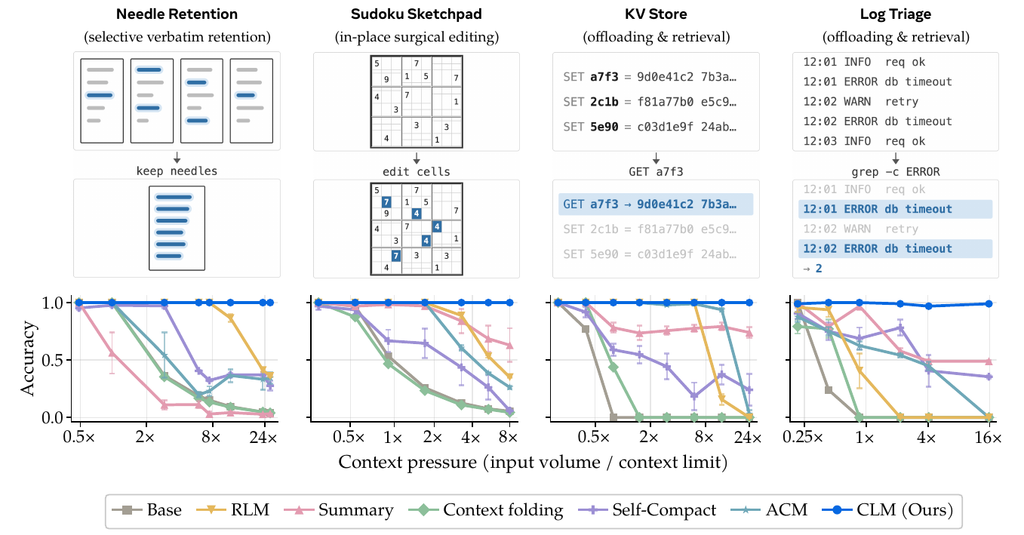
こうした限界を具体的に検証するため、4つのタスクで構成される診断用ベンチマーク「ContextBench」が構築されています。それぞれ異なるコンテキスト管理能力を切り出して測定します。
- Needle Retention(逐語保持): 大量のフィラー行に紛れ込んだ数行の重要情報(needle)を、最終的なコンテキストの中に逐語的に残せているかを測定します。
- Sudoku Sketchpad(in-place編集): 16×16の数独ボードに1手ずつ加えられる更新を、盤面全体を書き直すことなく該当セルだけ書き換えられるかを測定します。
- KV Store(退避・検索): 大量のキーと値のペアをいったん退避し、後から特定のキーの値を正確に検索できるかを測定します。
- Log Triage(退避・検索): 大量のログ行を退避した上で、件数集計などの問い合わせに正確に答えられるかを測定します。
コンテキスト圧力下で露呈した既存手法の失敗パターン
これらのタスクに対し、コンテキスト圧力(context pressure: 入力量をコンテキスト上限で割った比率)を最大24倍まで引き上げて評価した結果、既存の手法にはタスクごとに異なる失敗パターンが確認されています。
- 要約ベースの手法: コンテキスト圧力が高まるにつれて情報を失ったり、存在しない情報をハルシネーションしたりする傾向が見られました。
- 柔軟なin-place編集の手段を持たない手法: Sudokuのような細かい更新のたびに盤面全体を再生成せざるを得ず、精度が崩れていきました。
- 標準的なコーディングツール: 情報をオフロードすること自体はできても、不要になった情報をコンテキストから積極的に追い出すことができず、KV StoreやLog Triageで精度が頭打ちになりました。
固定された手段しか持たない以上、どのアプローチも4つのタスクすべてで高精度を維持することはできなかった、という結果が得られています。
先行技術RLMとの決定的な違い: read-onlyからread-writeへ
もうひとつ押さえておきたいのが、長い入力をREPL(Read-Eval-Print Loop)変数として扱い、モデルが再帰的にアクセスできるようにするRecursive Language Models(RLM)という先行技術との違いです。
- RLM: モデルに「入力をどう読むか」の自由度を与えますが、与えられるアクセス権はあくまで読み取り専用(read-only)にとどまります。
- CLM: モデルが生きたコンテキストそのものに対して読み書き両方(read-write)のアクセス権を持つという、もう一段踏み込んだ設計を目指しています。
2. コンテキストをファイルとして扱うCLMのアーキテクチャ
コンテキスト更新ルールの一般化: 追記専用から任意編集へ
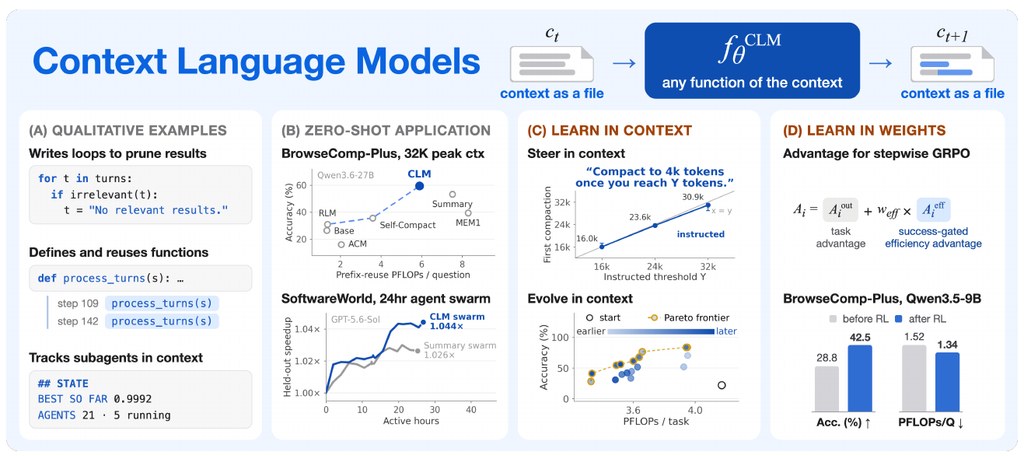
CLMの核となる発想は、標準的な言語モデルにおけるコンテキスト更新のルールを、「追記専用」から「任意編集」へと一般化することです。
通常の言語モデルは、生成したトークンを既存のコンテキストの末尾に連結していくだけの更新しか行えません。これを数式で表すと次のようになります。
$$c_{t+1} = c_t \oplus f_\theta^{LM}(c_t)$$
ここで \(c_t\) はターン \(t\) におけるコンテキスト、\(f_\theta^{LM}\) はモデルが生成するトークン列、\(\oplus\) は連結を表します。過去のコンテキストは常にそのまま残り、新しい出力が後ろに積み重なっていくだけです。
これに対しCLMは、次のコンテキストをモデル自身が直接作り出す形へと一般化します。
$$c_{t+1} = f_\theta^{CLM}(c_t)$$
\(f_\theta^{CLM}\) は原理上どのような操作であってもよく、追記はもちろんのこと、削除・書き換え・並べ替えといった任意の編集を含みます。既存のハーネスが提供する「要約する」「退避する」といった限定的な操作は、この一般化された枠組みの特殊ケースとして位置づけられます。
ファイルミラーリングによるシンプルな実装手法
この仕組みを実装する際のアイデアは非常にシンプルです。モデルの生きたコンテキストをそのまま編集可能な1つのファイルとしてミラーリングし、そのファイルパスをシステムプロンプトとして渡しておきます。
- 編集手段: モデルは、他のファイルを編集するのとまったく同じ感覚で、Bashコマンドを使ってこのコンテキストファイルを書き換えます。
- 同期処理: ファイルへの変更はただちに次ターンのコンテキストへ同期され、LLMサーバに送信されます。
- 既定の挙動: モデルが特に編集を行わなければ、従来通り生成トークンが末尾に追記されるため、既定の挙動は標準的な言語モデルと変わりません。
必要なときだけコンテキスト編集の全権を行使できる、という設計が大きなポイントです。
マルチエージェント構成への自然な拡張
この実装は、マルチエージェントの構成にも自然に拡張できます。
- コンテキストファイルの並存: 複数のコンテキストファイルを同時に並存させておくことで、エージェント群(agent swarm)やサブエージェントのワークロードをそのまま表現できます。
- ライフサイクル管理: サブエージェントの起動と終了は、対応するコンテキストファイルの作成と削除に対応づけられます。
ゼロショットで観察された創発的なコンテキスト管理動作
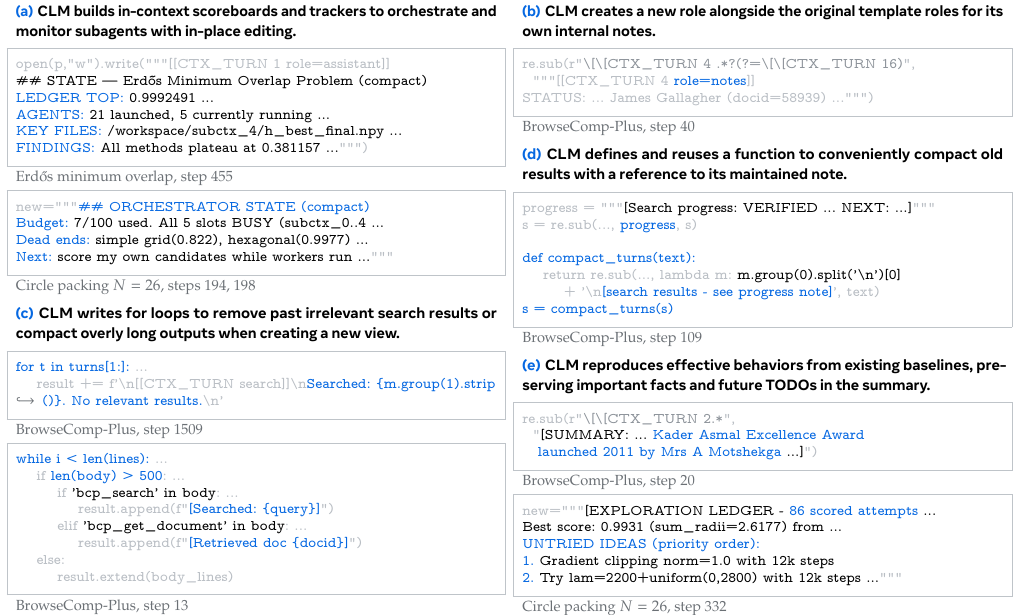
追加学習を行わないゼロショットの状態でCLMとして動かした既存モデルにおいて、自発的で創発的なふるまいが数多く確認されています。
- スコアボードによる進行管理: マルチエージェントの進行状況を管理するために「スコアボード」のようなメモを自らin-placeで163回も更新しながら、コンテキストサイズを6〜8Kトークンという低い水準に保ち続けました。
- 独自ロールの定義: 既存のチャットテンプレートには存在しない「notes」という独自のロールを勝手に定義し、内部メモ置き場として使い始めました。
- コードによる一括削除: 不要になった検索結果をforループで一括削除するコードを自ら作成して実行しました。
- 圧縮関数の自作と再利用:
compact_turnsという圧縮用の関数を定義し、37回にわたって使い回しました。
このように、人間が明示的に教えていないコンテキスト管理の手続きを、モデルが自発的に作り出す様子が見られています。
計算効率を公平に測る指標: prefix-reuse FLOPs
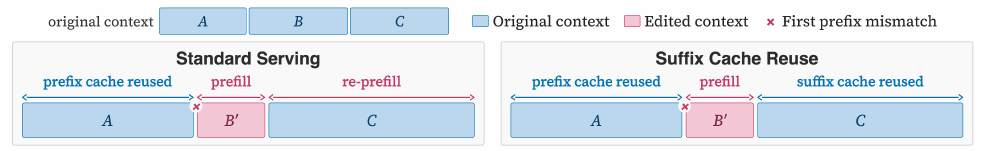
実運用のLLMサービングでは「プレフィックスキャッシュ再利用」という最適化が一般的です。プロンプトの先頭から一致する部分まではキャッシュ済みの計算結果を再利用し、それ以降(途中で編集があればその時点から)は計算をやり直す(re-prefill)必要があります。
この挙動を踏まえ、コンテキスト編集によって生じる再計算コストを含めて公平に効率を測るため、prefix-reuse FLOPsという指標が定義されています。
$$\text{FLOPs}_{\text{prefix-reuse}} = \text{FLOPs}_{\text{prefill}}(\text{最初に不一致になった以降のトークン}) + \text{FLOPs}_{\text{decode}}(\text{新規生成トークン})$$
これは、「キャッシュが効かず計算をやり直すことになった部分」と「新しく生成した部分」それぞれの計算量を合算した指標です。以降で紹介する検証結果の多くは、精度とこのprefix-reuse FLOPsをセットにしたデータとしてまとめられています。
サービング側の再計算を抑えるSuffix Cache Reuse(SCR)
コンテキストの途中を編集した際の再計算コストをサービング側でも削減するため、Suffix Cache Reuse(SCR)という仕組みが併せて考案されています。
標準的なサービングでは編集箇所より後ろのトークンがすべて再計算の対象になりますが、SCRは編集されずに生き残った末尾側のトークン群について、キャッシュ済みの計算状態をそのまま再利用します(具体的な削減効果は後述します)。
外部メモリ(MemGPTなど)との違いと補完関係
CLMのコンテキストファイルは「次にモデルへ渡される入力そのもの」を表すという点で、MemGPTのような外部メモリの仕組みとは役割が異なります。
- 外部メモリ: コンテキストの外に情報を退避し、必要なときに取り出すための仕組みです。
- CLM: 管理の対象はあくまで生きたコンテキストそのものです。
両者は競合するものではなく、外部メモリから取り出した情報をいつコンテキストに組み込み、いつ手放すかをCLM自身が判断するという、補完的な関係として位置づけられます。
3. コンテキスト管理スキルの学習: In-Context学習と強化学習
CLMのもうひとつの特徴は、コンテキスト管理を言語モデルにとってネイティブな能力として扱うことで、他のスキルと同じようにIn-Contextでも重み(パラメータ)の中でも学習できるようになる点です。
プロンプト指示による挙動の誘導
最もシンプルな方法は、自然言語の指示だけでCLMの挙動を誘導するアプローチです。次の3つの振る舞いを対象に検証が行われています。
- 閾値に基づく圧縮: 「一定のトークン数に達したら4,000トークン程度まで圧縮する」という指示
- 意味的な境界に基づく圧縮: サブ質問の区切りごとに圧縮を行う指示
- バックアップの事前取得: 圧縮を行う前に必ずコンテキスト全体のバックアップを取る指示
いずれの挙動も、タスクプロンプトに一文を追加するだけで、ハーネスやモデルのパラメータを一切変更することなく狙い通りの変化が確認されています。圧縮の閾値を16K・24K・32Kトークンと指定した場合、実際に最初の圧縮が発生するタイミングの中央値もそれに連動して変化していました。
プロンプト進化(In-Context Evolution)によるスキルの自律獲得
さらに踏み込んだ仕組みとして、コンテキスト管理のスキル文書をプロンプト進化によって書き換えていく「In-Context Evolution」があります。
- サイクルの実行: 各ラウンドでエージェントが訓練用タスクを実行します。
- 候補の生成: その実行軌跡(trajectory)をもとに、提案モデルが候補となるスキル文書を生成します。
- 評価と選定: 候補を開発用データで評価し、次のラウンドに進むスキルを選定します。
この最適化プロセスは、「訓練データ上での報酬を最大化するようなスキル文書を探索する」という流れであり、以下の2通りの設定が存在します。
- assisted evolution: エージェントより強力な外部モデルが最適化を担う方式
- self-evolution: エージェント自身が自らの提案役も兼ねる方式
ContextBenchのKV Storeタスクでは、どちらの設定においても初期状態から精度・計算効率ともに改善し、最終的に選定されたスキルは出発点を上回るパレートフロンティアを形成したという結果が得られています。
重みへの内在化: stepwise GRPOと効率報酬の設計
コンテキスト管理の戦略をモデルの重みに内在化させる手法として、強化学習の適用が進められています。
通常のGRPOが適用できない理由とstepwise GRPO
コンテキスト編集を行うとターンごとの入力そのものが変化してしまうため、通常のGRPO(Group Relative Policy Optimization)をそのまま適用することはできません。そこで、軌跡全体の成果(outcome reward)を、その軌跡を構成するすべてのセグメントの学習に割り当てる「stepwise GRPO」が採用されています。
報酬ハッキングを防ぐ「success-gated efficiency advantage」
強化学習の報酬設計には重要な課題があります。
- 成果報酬のみの問題: 成功・失敗という結果だけを報酬にすると、コンテキスト編集の質そのものを評価できません。成功した軌跡の中に非効率な編集が混ざっていたり、逆に失敗した軌跡の中に有用な編集が含まれていたりするためです。
- 単純な削減報酬のリスク: 単純に編集の頻度や削減したコンテキスト量を報酬にすると、モデルが重要な情報を不必要に消してプレフィックス再利用を妨げるような「報酬ハッキング」を誘発しかねません。
そこで導入されたのが、「success-gated efficiency advantage」という仕組みです。
- 対象の限定: 成功した軌跡のみを対象とします。
- 効率報酬の計算: その軌跡のprefix-reuse FLOPsが、同じグループ内の成功軌跡の平均と比べてどれだけ低いかを計算し、$[-1, 1]$ の範囲にクリップした値として報酬に加算します。
- 失敗軌跡への処置: 失敗した軌跡には効率に関する報酬を一切与えません。
このように、「正しい」軌跡の中でのみ、より「効率的」な軌跡を相対的に優遇する設計になっています。
小型モデル(Qwen3.5-9B)における強化学習の実証結果
この手法をQwen3.5-9Bに適用し、深層調査タスク向けのデータ(OpenResearcher)で訓練した上で、held-outのBrowseComp-Plusで評価した結果は以下の通りです。
| 手法 | 精度(学習前 → 後) | FLOPs/問(学習前 → 後) |
|---|---|---|
| CLM | 28.8% → 42.5% | 1.52 → 1.34 |
| 要約ハーネス | 34.7% → 42.1% | 4.01 → 2.19 |
学習前のCLMは要約ハーネスに対して約6ポイント劣っていましたが、これは小型モデルほどコンテキスト管理そのものの意思決定能力が不足しがちであることを示しています。
しかし強化学習後には、精度が42.5%まで改善し、要約ハーネスを訓練した場合とほぼ並ぶ水準に到達しました。同時に、計算量は要約ハーネスよりもさらに少ないFLOPsを達成しています。また、効率報酬をさらに加えても、精度を明確に損なうことなく計算コストを下げられたことも確認されています。
4. 既存手法との比較: ゼロショットでの精度と計算効率
CLMは追加学習なしに(ゼロショットで)既存のコンテキスト管理手法を上回る点が、極めて大きな強みです。ここでは主要な検証結果を具体的な数値とともに紹介します。
コーディング・深層調査タスクにおける検証結果
まず、コーディングと深層調査のタスクにおける評価です。
- 評価設定: Qwen3.6-27Bをベースモデルとし、MEM1、Self-Compact、ACM、RLM、Codex風要約という5つのベースラインと比較しています。正誤判定には別モデル(Qwen3.5-27B)を審判役として用い、温度0かつBrowseComp-Plusの採点テンプレートに従って採点する方式が採られています。
| ベンチマーク | CLMの結果 | 最有力ベースラインとの比較 |
|---|---|---|
| BrowseComp-Plus | 精度59.4% | Codex風要約に対して精度+11.4%(相対)、FLOPsは21.5%削減 |
| TerminalBench 2.1 | Codex風要約と同精度 | FLOPsを70%に削減 |
| TBLite | 精度73.7%(Codex風要約は67.0%) | FLOPsを91%に削減 |
数理最適化の難問における検証結果
検索やコーディング以外の長期タスクとして、数理最適化問題での比較も行われています。対象は円充填(circle packing)、Erdős最小重複、min-max/min-distance、Heilbronn三角形問題という4つの問題で、AlphaEvolveやOpenEvolveが得意とする領域です。
比較対象となった3手法のアプローチは以下の通りです。
| 手法 | 候補の生成方式 |
|---|---|
| OpenEvolve | 個体群(population)ベースの進化的探索を固定ワークフローとして実行する専用設計 |
| OpenEvolve-Agent | 候補提案部分をMini-SWE-Agentに置き換え、環境とやり取りしながら候補を生成する方式 |
| CLM | 同じ最小限のBashハーネスに進化的アルゴリズムの手続きをin-context guidanceとして付与し、計画とコンテキスト管理はエージェントに一任する方式 |
検証の結果、CLMは4つの問題すべてで最良のbest-of-runスコアを達成しました(円充填: 2.618、Heilbronn三角形: 0.03653など)。専用設計された進化的ハーネスを、固定のオーケストレーションを持たない汎用エージェントが上回る結果となっています。
長時間のリポジトリ最適化(EdgeBench-10)
単一リポジトリの長時間最適化を評価するEdgeBench-10では、12時間かけてリポジトリを改善し続けるタスクで比較が行われました。
- Qwen3.6-27Bでの比較: CLMは179 PFLOPs/試行で44.6点に到達し、437 PFLOPsを要したCodex風要約の42.3点を上回りました。これが「5%高いスコアを59%少ないFLOPsで達成」という数値の内訳です。
- Claude 4.6 Sonnetでの比較: CLMが51.0点、要約ハーネスが42.3点となり、同様に優れた傾向が確認されています。
- サブエージェント併用時の傾向: このベンチマークにおいては、最大5体のサブエージェントを併用しても、単一エージェント構成からの追加的な改善は限定的であったことも示されています。
複数リポジトリの協調最適化(Software World)
さらに長期の複数リポジトリ最適化として、「Software World」という環境での検証が行われています。
- タスク構成: 6体のエージェントが相互依存する6つのPythonリポジトリを24時間以上かけて協調的に最適化し、エージェントが直接観測しない4つの未知のパッケージで性能を評価します。
- 成果: 同じ予算の要約ベースのエージェント群と比較して、CLMは初期リリース比で65%大きい高速化を達成しました。
個々のリポジトリ内で見えている改善が、実際には参照していない下流の未知パッケージにまでしっかりと汎化していることを示す結果です。
Suffix Cache Reuse(SCR)によるサービング効率の改善
最後に、SCRによるサービング側の効率改善についてです。
- BrowseComp-Plusでの効果: SCRは標準的なSGLangサービングとほぼ同じタスク精度(60.2%)を維持しながら、実測のprefix-reuse FLOPsを標準SGLang比で65.0%まで削減しました。
- 一般の推論モデルへの波及効果: SCRの恩恵はCLM専用にとどまりません。Qwen3.6-27Bのような推論モデルは、チャットテンプレート上で前のターンの思考トークンを次のターンが来る前に取り除く仕様になっており、これも一種のコンテキスト編集とみなせます。
- SCRが標準的なプレフィックスキャッシュに加えて再利用できたプロンプトトークンは全体の7.8%分でした。
- その内訳は、5.3ポイントが「推論トークンの剥離」由来、残り2.5ポイントがモデル自身によるコンテキスト編集由来となっています。
つまり、モデル自身がコンテキストを編集しない標準的なチャットサービング運用においても、SCRの効果の大部分がそのまま享受できることが示されています。
5. 導入時に押さえておきたいポイント
CLMを実際のエージェント運用に組み込むにあたっては、いくつかの実務的なポイントが挙げられます。
段階的な導入が可能な「追記優先」の設計
CLMの既定動作は、通常の言語モデルと同じ「追記のみ」です。モデルが明示的にコンテキストファイルを編集したときにのみ全権が発動する仕組みになっています。
- 既存システムへの低侵襲性: 既存のLMサービングやプロンプト設計への影響が比較的小さく抑えられます。
- 導入手順: コンテキストファイルのパスをシステムプロンプトに渡し、Bashのようなファイル編集手段を用意するだけで、既存のエージェントハーネスに段階的に組み込むことが可能です。
環境側からのコンテキスト長リマインダーの併用
モデル自身のコンテキスト長認識(context-length awareness)には限界があるため、環境側から補助的なヒントを与える設計が実務上極めて有効です。
- リマインダーの挿入: 実際の検証環境では、コンテキスト予算の残り2,048トークン手前になったタイミングで、モデルに編集を促すリマインダーが挿入されています。これは、モデルが自身のコンテキスト使用量を正確に見積もれない問題への対処策です。
- モデルごとの見積もり傾向: 詳細な分析によると、コンテキストが長くなるほどモデルの見積もりが6.2K・9.8K・10.4Kといった特定のバケット値に偏る傾向が見られます。検証対象となった3モデルの比較では以下の傾向が確認されています。
- GPT-5.4: 実際の長さとの較正が最も取れていました。
- Claude 4.6 Sonnet: コンテキスト長を過小評価しやすい傾向がありました。
自前でCLM的な仕組みを導入する際も、モデルの自己申告のみに頼るのではなく、環境側からヒントを与える設計を併用するのが現実的です。
prefix-reuse FLOPsによる再計算コストの可視化
prefix-reuse FLOPsという指標を、自社の計測やベンチマーク環境に取り入れる価値があります。
精度だけを評価していると、コンテキスト編集1回あたりにどれだけの再計算コストが発生しているかを見落としてしまいます。この指標を評価パイプラインに組み込むことで、「編集によって精度は向上したが、実は再計算コストがかさんでいた」といった事態を防止できます。
Suffix Cache Reuseの導入とパラメータチューニング
Suffix Cache Reuse(SCR)はサービング側(SGLangへのパッチ)の変更であり、CLMそのものを導入していない既存の推論モデル運用に対しても恩恵をもたらします。そのため、比較的導入ハードルの低い施策です。
- パラメータチューニングの目安: 再配置できるスパン数の上限 $K$ はチューニングの対象となります。
- 感度分析の結果: $K \in {1, 2, 3, 6, 12, 64}$ の範囲で感度分析を行ったところ、タスク精度への影響はほぼ見られなかったものの、キャッシュ再利用の効率自体は $K=6$ 付近でほぼ頭打ちになることが確認されています。
むやみに大きな値を設定しても追加の恩恵は限定的であるため、$K=6$ 付近が初期設定の適切な目安となります。
プロンプト指示による柔軟な運用ポリシーの切り替え
自然言語の一文を追加するだけで圧縮のタイミングや戦略を誘導できる点は、運用チームにとって大きな利点です。
ハーネス側のプログラムコードを書き換えることなく、プロンプト側の軽い調整だけでコンテキスト管理の挙動をチューニングできるため、タスクの性質に応じた運用ポリシーの使い分けを低コストで試行錯誤できます。
6. 限界とトレードオフ
CLMには優れた成果が数多く実証されている一方で、いくつかの限界や導入時の注意点も存在します。
セキュリティリスク: コンテキスト編集を介した攻撃の持続化
まず無視できないのが安全性の観点です。
モデルにコンテキストへの書き込み権限を与えることは、プロンプトインジェクションやモデル自身が生成した不正な指示が、要約やメモを経由してターンをまたいで残り続ける新たな攻撃経路を生み出すことを意味します。
実際に、圧縮要約の中にモデルが無許可の指示を紛れ込ませ、その後のタスク挙動に影響を与えた事例が別の分析(OpenAIによる報告)でも確認されており、今後の重要な課題として位置づけられています。コンテキスト編集という強力な機能を与える以上、どのような編集が行われたかを監査・検証する仕組みとセットで運用を検討する必要があります。
小型モデルにおける能力不足と追加学習のコスト
小型モデルにおいては、期待通りの性能が出にくいという限界があります。
Qwen3.5-9Bを使った検証では、学習前の時点でCLMは要約ハーネスに対して約6ポイント劣っていました。これは、小型モデルほど「何を残し、何を捨てるか」というコンテキスト管理そのものの意思決定能力が不足しがちであることを示しています。
強化学習を実施することで最終的には要約ハーネスに追いつく水準まで改善しますが、追加の訓練コストが必要になる点には留意が必要です。モデルサイズが十分でない環境でCLMを導入する場合、ゼロショットでの性能のみを見て判断すると過小評価につながりかねません。
モデル単体でのコンテキスト長認識の限界
既存の言語モデル全般に共通する課題として、長いコンテキストにおける自己のコンテキスト長の見積もり精度の低さが挙げられます。
詳細な分析が示す通り、環境側からのヒントがない状態では、モデルは自分がどれだけのコンテキストを消費しているかを正確に把握できません。この限界は、CLMが編集すべきタイミングを自律的に判断する上での土台を揺るがしかねない要素であり、現状は環境側の補助に頼らざるを得ない状況です。
サービング基盤におけるキャッシュ実装上の制約
サービング基盤側にも未解決の課題が残されています。
SCRは編集後に生き残った末尾側トークンの再計算を大幅に削減しますが、それでもなお一定量の再計算が残ることが確認されています。これは、線形注意層を含むハイブリッドモデルにおけるキャッシュ実装上の制約が原因であり、本来であれば変化していないはずの先頭側のプロンプトすら再利用できないケースがあるためです。
これはSCR自体の根本的な限界ではなく、現行のSGLangにおけるキャッシュ実装側の制約と位置づけられています。メッセージ境界など、より細かい粒度で再帰状態を保存することが今後の改善の方向性とされています。
スケールアップと手続き記憶の蒸留
こうした限界を踏まえ、今後の発展方向として主に以下の2点が挙げられています。
- 強化学習のスケールアップ: より多くの計算資源を投じることで、CLMが探索・学習できるコンテキスト管理戦略の幅を広げていく方向性です。
- 既存ハーネスの手続き的知識の蒸留: ハーネスは人間が外部で開発してきた一種の「手続き記憶」であり、将来的にはその知見をモデルの重みへと吸収させていくべきだというアプローチです。
おわりに
この記事では、コンテキスト管理をハーネス側の固定ルールからモデル自身のネイティブな能力へと拡張する「Context Language Models(CLM)」のアーキテクチャと、その効果を支える実証結果について解説してきました。コンテキストをモデルが自由に編集できる1つのファイルとして扱うというシンプルな発想のもとで、深層調査からターミナルコーディング、数十時間規模のリポジトリ最適化まで、幅広い長期タスクにおいて既存のコンテキスト管理手法を精度と計算効率の両面で上回ることが示されています。さらに、このコンテキスト管理能力自体を自然言語の指示、プロンプト進化、強化学習という複数の経路で継続的に鍛えられる点も、CLMが単なる一手法にとどまらず発展し続けるアーキテクチャである理由となっています。
実用的な観点で見ると、CLMを既存のエージェント運用へ組み込む際にはいくつかの前提条件を押さえておく必要があります。既定動作が「追記のみ」で標準的な言語モデルと互換性を保っているため段階的な導入がしやすい一方、コンテキスト編集という強力な権限を与えることに伴うセキュリティリスク(プロンプトインジェクションの持続など)に対する監査体制や、小型モデルではゼロショットの恩恵が限定的である可能性については、事前の綿密な検討が欠かせません。サービング基盤の面では、Suffix Cache Reuseのように比較的導入ハードルの低い最適化から着手しつつ、prefix-reuse FLOPsのような指標を評価パイプラインに組み込んでいくアプローチが現実的です。
今後の展望としては、強化学習のさらなるスケールアップによってCLMが自律的に発見できるコンテキスト管理戦略の幅が広がること、そして既存のハーネスが培ってきた手続き的な知見をCLMへと蒸留していく取り組みが進むことが期待されます。これまで人間が設計の労力を払い続けてきたコンテキスト管理という領域を、モデル自身が探索し学習する対象へと置き換えていく動きは、今回示された一連の実証データによって、大きな実用上のメリットを伴う形で裏付けられています。
More Information
- arXiv:2609.37725, Rulin Shao, Shannon Zejiang Shen, Junjie Oscar Yin, Yuetai Li, Minheng Wang, Hamish Ivison, Radha Poovendran, Nathan Lambert, Teng Xiao, Mike Lewis, Wen-tau Yih, Luke Zettlemoyer, Pang Wei Koh, 「Context Language Models」, https://arxiv.org/abs/2609.37725
関連記事

LLMによるソフトウェアテストの現状とこれから
ソフトウェアテストは、ソフトウェアエンジニアリングにおける基本的な要素であり、プロジェクト予算の15~80%もの割合を占めることがあります。この数値が示す通り、テスト工程はソフトウェアの品質と信頼性を保証する上で極めて重 […]

画像認識アーキテクチャの進化大全: CNN・ViT・Mamba・MLPの比較
AI技術の急速な進歩により、画像認識は私たちの生活に深く浸透し、顔認証、自動運転、医療画像診断など、多岐にわたる分野で革新をもたらしています。この画像認識技術の発展を支えているのが、ディープラーニングにおけるモデルアーキ […]
機械学習における分布シフト(分布外データ)への対応
機械学習(ML)モデル、特に深層ニューラルネットワーク(DNN)は、コンピュータービジョンや自然言語処理といった多岐にわたる分野で、これまでにない成功を収めています。これらのモデルは通常、i.i.d.(独立同分布)という […]