Agent Skills の改訂がタスク成果とコストに与える影響
Claude Code などのコーディングエージェントでは、プロジェクトの作法を SKILL.md にまとめる使い方が広がっています。Agent Skills(エージェントスキル)と呼ばれるこの仕組みは、コマンドの追加や […]
Context Language Models: コンテキストを直接編集・自己管理するLLMの次世代アーキテクチャ
数十時間にわたって動き続けるAIエージェントを運用していると、精度以前にコンテキストの肥大化という壁にぶつかることがあります。検索結果やツール呼び出しのログ、過去のやり取りが際限なく積み上がり、コンテキストウィンドウの上 […]
AstroGenesis: 天体物理学研究を加速させるマルチエージェントAIフレームワーク
天体物理学の観測環境は、この十数年で劇的に変化しました。LSST、Gaia、Euclid、DESIといった大規模サーベイに加え、重力波やニュートリノを含むマルチメッセンジャー観測網が整備されたことで、電波からγ線までの電 […]
JEV-as-a-Judge: 低コスト・高精度なLLM評価の最適戦略
LLMの出力をLLM自身に採点させる「LLM-as-a-Judge」は、プロンプト改善、RAGの検索・生成パイプラインのチューニング、社内ファインチューニング用のデータ選別など、開発サイクルにかなり定着しています。 とこ […]
Tokenizer解体新書: BPEとUnigramの比較から迫るLLM性能の真実
LLMを開発していると、モデルの構造や学習データには注意を払っても、入口にあるトークナイザは「とりあえずBPE」で済ませてしまうことが少なくありません。BPE(Byte-Pair Encoding: バイト対符号化)とU […]
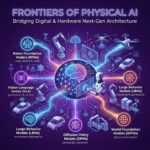
Physical AI の最前線: デジタルとハードを繋ぐ次世代アーキテクチャ
工場の溶接ロボットは、部品の位置が数センチずれただけで止まってしまいます。if-then のルールで動く従来型のロボットは、想定外の状況に弱いことが長く課題とされてきました。一方で、LLM(Large Language […]

Deep-to-Shallow: Deep Neural Networks の効率的な高速化手法
Deep Neural Networks(DNN: 深層ニューラルネットワーク)は、画像認識や自然言語処理をはじめとする様々な分野で中核的な技術となっています。しかし、その高い表現力はモデルの深さと大きさに支えられており […]
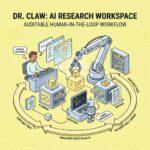
Dr. Claw: Vibe Research のためのAI研究ワークスペース
Claude Code や Gemini CLI といったコマンドラインで動作するコーディングエージェントは、ファイルの読み書きや長時間にわたるセッションの維持をこなせるまでに実用段階に入ってきました。しかし、研究という […]

Random Attention: KVキャッシュ削除により推論を加速させる
DeepSeek-R1 や Qwen3、Phi-4-reasoning といった推論特化型の大規模言語モデルは、難しい問題を解くために数万トークンにおよぶ思考連鎖(Chain of Thought: 思考の途中経過をテキ […]

AREX-Skill: GitHubリポジトリからAI研究を加速させる専門知識を蒸留する方法
自律的にコードを書き、実験を回し、結果を比較する「エージェント」が、機械学習研究の現場に入り込み始めています。もっとも、こうしたエージェントを実際に使ってみると、有名なライブラリの使い方を一つ間違えるだけで実験全体が無駄 […]