SHAPの「その先」へ:shapiq で Shapley 相互作用を試す
機械学習モデルの予測理由を説明する手法として、SHAP(Shapley 値)はすでに定番の道具になっています。表データを扱う現場で、ウォーターフォール図を一度も見たことがない人のほうが少ないかもしれません。
ただし Shapley 値が返すのは「特徴ごとの寄与」だけです。緯度と経度のように、2つの特徴が組み合わさって初めて意味を持つ効果があっても、その効果は2つの特徴に按分されて見えなくなります。
実際、住宅価格モデルで1軒の家を説明させると、Shapley 値では経度の寄与は -0.059 で、ほとんど効いていないように見えます。ところが同じ家を Shapley 相互作用で分解し直すと、経度は単独では +0.118 と予測を押し上げていて、それを「緯度 × 経度」のペア(-0.208)が打ち消しています。
この「組み合わせの効果」を取り出せる Python ライブラリが shapiq(Muschalik et al. 2024)です。この記事では、XAI(説明可能なAI)研究の現状の中で Shapley 相互作用がどこに位置するのかを整理します。その上で、shapiq のサンプルコードを実際に動かし、Shapley 値では見えない特徴の組み合わせの効果を取り出せることを確認します。
XAI 研究の現在地と Shapley 相互作用
研究の重心は LLM の内部へ
2023年以降の XAI 研究は、明らかに LLM 中心に動いています。arXiv で目立つのは、モデル内部で何が計算されているかを調べる機械論的解釈可能性(Mechanistic Interpretability)の研究です。具体的には、次のような研究がこれにあたります。
- スパースオートエンコーダ(SAE)で内部表現を分解する研究
- Circuit Tracing(Ameisen et al. 2025)のように、特徴どうしの配線をグラフとして描く研究
その流れも一直線ではありません。2025年には AxBench(Wu et al. 2025)や MIB(Mueller et al. 2025)といったベンチマークで「SAE は単純なベースラインに勝てない」という結果が出て、分野全体が一度立ち止まりました。
それでも特徴量帰属は現役
一方で、実務で毎日使われている XAI は、いまも LIME や SHAP(Lundberg & Lee 2017)のような特徴量帰属です。与信、需要予測、医療など、表データと決定木系モデルを扱う現場は大量にあります。「なぜこの予測になったのか」を説明する道具としては、Shapley 値がまだ第一候補です。
古典的な手法も止まっているわけではありません。LLM 時代に合わせた更新が次のように進んでいます。
- AttnLRP(Achtibat et al. 2024):Transformer 向けに LRP を作り直した手法
- ContextCite(Cohen-Wang et al. 2024):RAG の回答がどの文書に基づくかを特定する手法
- Shapley 相互作用(Shapley Interactions):Shapley 値の系統における更新の1つとなる拡張(shapiq はその代表的な実装)
Shapley 相互作用とは
Shapley 値の限界
Shapley 値は、予測値と平均的な予測値(ベースライン)の差を、各特徴に公平に配分する方法です。
$$\text{予測値} = \text{ベースライン} + \Phi (\text{特徴1}) + \Phi (\text{特徴2}) + \cdots + \Phi (\text{特徴n})$$
この足し算できる形が Shapley 値の良さです。ただし、2つの特徴が組み合わさって初めて生まれる効果は、2つの特徴に半分ずつ割り振られてしまいます。住宅価格なら、緯度と経度はセットで「立地」を表すので、片方だけを見ても意味がありません。
Shapley 相互作用は、この組み合わせの効果を独立した項として取り出します。
$$\text{予測値} = \text{ベースライン} + \sum \Phi (\text{単独の特徴}) + \sum \Phi (\text{特徴ペア}) + \cdots$$
shapiq が実装する相互作用指標
相互作用の定義にはいくつか流儀があり、shapiq は主要なものをまとめて実装しています。
| 指標 | 概要 | 出典 |
|---|---|---|
| SV | 通常の Shapley 値 | SHAP(Lundberg & Lee 2017) |
| SII | 相互作用を定義した古典的な指標 | Shapley Interaction Index(Grabisch & Roubens 1999) |
| k-SII | k 次までの相互作用で予測値をちょうど分解するように SII を調整したもの | k-SII(Bordt & von Luxburg 2022) |
| STII | 最高次の項に相互作用を集める | Shapley Taylor Interaction Index(Dhamdhere et al. 2019) |
| FSII | 元のモデルに最もよく当てはまる相互作用を求める | Faith-Shap(Tsai et al. 2022) |
最初に試すなら k-SII がおすすめです。足し合わせると予測値に戻る性質があるので、通常の Shapley 値と並べて比べやすいためです。
Python による実装例
ここからはサンプルコードを動かしていきます。コード一式は次の構成で、uv で作った Python プロジェクトです。
shapiq-demo/
├── pyproject.toml
└── src/shapiq_demo/
    ├── common.py              # データ準備とヘルパー
    ├── shapley_values.py      # サンプル1: 通常の Shapley 値
    ├── interactions.py        # サンプル2: Shapley 相互作用(k-SII)
    └── budget_convergence.py  # サンプル3: 近似の budget と精度
① セットアップ
uv init shapiq-demo --app
cd shapiq-demo
uv add shapiq scikit-learn matplotlib
この記事の時点では Python 3.13、shapiq 1.7.0 で動かしています。pyproject.toml にはサンプルごとのコマンドを登録してあるので、uv run だけで実行できます。
[project.scripts]
shapiq-demo = "shapiq_demo:main"
shapley-values = "shapiq_demo.shapley_values:main"
interactions = "shapiq_demo.interactions:main"
budget-convergence = "shapiq_demo.budget_convergence:main"
Windows の Git Bash では日本語の出力が文字化けすることがあります。その場合は PYTHONUTF8=1 uv run interactions のように実行してください。
② モデルと背景データの準備
題材は scikit-learn に入っている California Housing(カリフォルニアの住宅価格)データです。特徴は所得(MedInc)、築年数(HouseAge)、部屋数(AveRooms)、緯度(Latitude)・経度(Longitude)など8個で、これを RandomForest で学習します。
common.py の load_model_and_data() がその部分です。
def load_model_and_data():
    dataset = fetch_california_housing()
    X_train, X_test, y_train, y_test = train_test_split(
        dataset.data, dataset.target, test_size=0.2, random_state=RANDOM_STATE
    )
    model = RandomForestRegressor(
        n_estimators=50, max_depth=8, random_state=RANDOM_STATE, n_jobs=-1
    )
    model.fit(X_train, y_train)
    print(f"テストデータの R^2: {model.score(X_test, y_test):.3f}")

    rng = np.random.default_rng(RANDOM_STATE)
    background = X_train[rng.choice(len(X_train), BACKGROUND_SIZE, replace=False)]
    return model, background, X_test, list(dataset.feature_names)
データとモデルの設定は以下の通りです。
- テストデータでの R²: 0.739
background(背景データ): ある特徴を「使わない」場合をシミュレートするときに、その特徴を埋めるための背景データ(学習データから100件)- 説明の対象: テストデータの先頭の1件
③ 通常の Shapley 値を求める
コードの実装
shapiq の入口は TabularExplainer です。index="SV"、max_order=1 を指定すると、SHAP と同じ Shapley 値になります。shapley_values.py の中心部分は次の通りです。
model, background, X_test, feature_names = load_model_and_data()
x = X_test[SAMPLE_INDEX]

# index="SV", max_order=1 が通常の Shapley 値
explainer = shapiq.TabularExplainer(
    model=model, data=background, index="SV", max_order=1, random_state=RANDOM_STATE
)
# 特徴が8個なので、2^8 = 256 の budget で全ての特徴の組み合わせを評価できる
iv = explainer.explain(x, budget=2 ** len(feature_names))

# 効率性: ベースライン + 寄与の合計 = モデルの予測値
total = iv.baseline_value + sum(value for _, value in contributions)

iv.plot_waterfall(feature_names=feature_names, show=False)
budget は「特徴の組み合わせを何通り評価するか」を表します。特徴が8個なら組み合わせは 2⁸ = 256 通りなので、budget=256 なら全通りを評価でき、近似のない値が得られます。
実行結果とウォーターフォール図
所得が低いことが、予測を一番押し下げています。ベースラインと寄与の合計が予測値にぴったり一致するのも確認できました。ここまでは SHAP を使ったことがある人には見慣れた結果です。
実行例:
$ uv run shapley-values
=== Shapley 値(寄与の大きい順)===
  MedInc       -0.9383
  Latitude     -0.3050
  AveOccup     -0.2580
  Longitude    -0.0590
  HouseAge     +0.0129
  AveRooms     +0.0127
  AveBedrms    -0.0050
  Population   +0.0011

ベースライン(背景データの平均予測): 2.2069
ベースライン + 寄与の合計          : 0.6683
モデルの予測値                     : 0.6683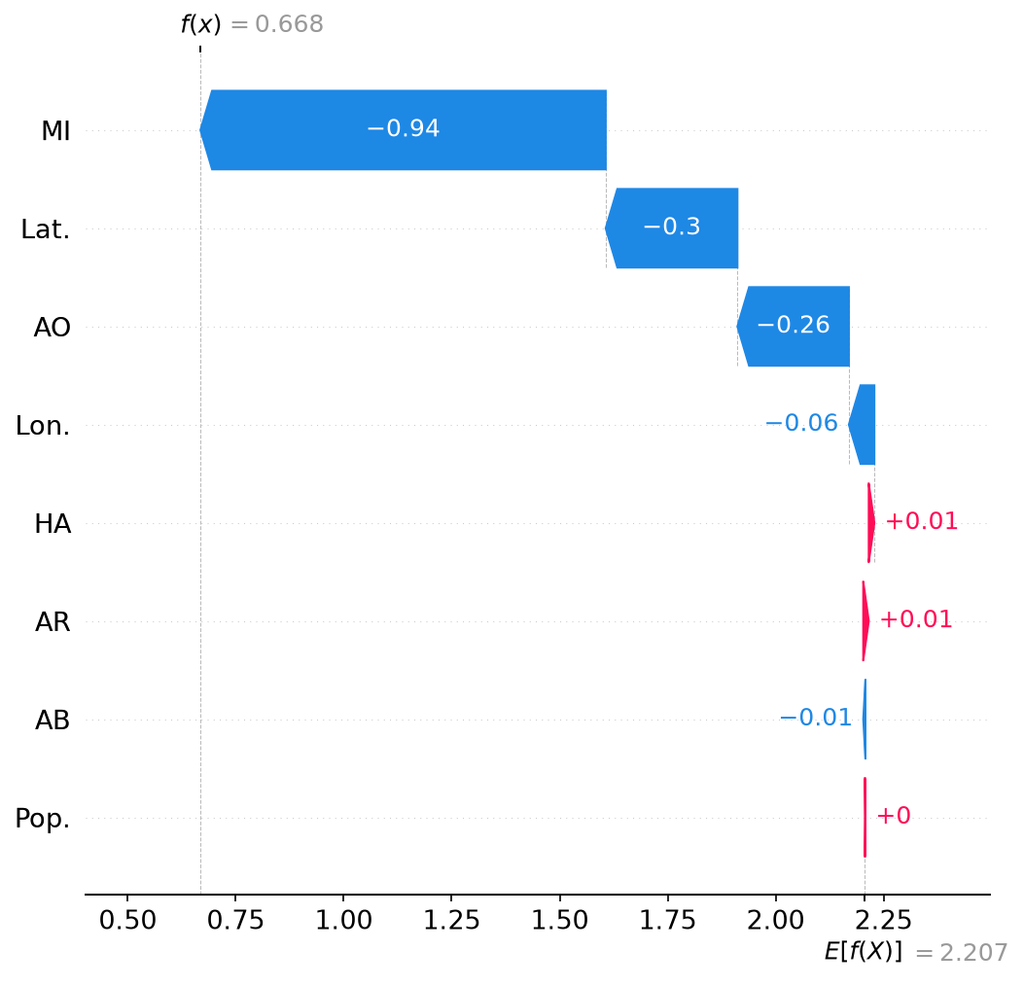
④ k-SII で相互作用まで分解する
コードの実装
同じ家を index="k-SII"、max_order=2 で説明し直します。変えたのは2つの引数だけです。interactions.py では、SV と k-SII の両方を求めて並べています。
sv = shapiq.TabularExplainer(
    model=model, data=background, index="SV", max_order=1, random_state=RANDOM_STATE
).explain(x, budget=budget)
# max_order=2 で、単独の特徴に加えて特徴ペアの相互作用も求める
ksii = shapiq.TabularExplainer(
    model=model, data=background, index="k-SII", max_order=2, random_state=RANDOM_STATE
).explain(x, budget=budget)

pairs = top_interactions(ksii, order=2, k=len(ksii.dict_values))

for key, value in top_interactions(sv, order=1, k=len(feature_names)):
    (i,) = key
    # SV は「自分の1次の値 + 自分を含むペアの相互作用の半分ずつ」に一致する
    recovered = ksii[key] + sum(v for pair, v in pairs if i in pair) / 2
結果は InteractionValues というオブジェクトで返ってきます。次のように特徴のインデックスのタプルで値を取り出せます。
ksii[(0,)](MedInc):単独の値ksii[(6, 7)](Latitude × Longitude):ペアの値
また、top_interactions() は、指定した次数の値を絶対値の大きい順に並べるだけの小さなヘルパーです。
実行結果の考察
実行例:
$ uv run interactions
=== 単独の特徴: Shapley 値 と k-SII(1次)の比較 ===
  特徴                 SV    k-SII    k-SII+ペア/2
  MedInc        -0.9383  -0.8391       -0.9383
  Latitude      -0.3050  -0.1083       -0.3050
  AveOccup      -0.2580  -0.3279       -0.2580
  Longitude     -0.0590  +0.1179       -0.0590
  ...

=== 特徴ペアの相互作用(k-SII 2次、絶対値の大きい順)===
  MedInc × Latitude        -0.2839
  Latitude × Longitude     -0.2078
  MedInc × AveOccup        +0.1852
  AveOccup × Latitude      +0.0768
  AveOccup × Longitude     -0.0743

ベースライン + k-SII の1次と2次の合計: 0.6683
モデルの予測値                       : 0.6683
この結果から、次の3つのことが分かります。
- 経度における単独の効果とペアの効果
冒頭で触れた経度の話は、この結果を見ると分かります。経度は単独では +0.118 とプラスなのに、緯度とのペア(-0.208)の半分を背負わされた結果、Shapley 値ではマイナスに見えていました。 - Shapley 値と k-SII の関係(検算)
右端の列は、検算のために足したものです。「k-SII の1次の値 + 自分を含むペアの値の半分」を計算すると、Shapley 値と小数4桁まで一致しました。Shapley 値はペアの効果を半分ずつ配分している、という関係がそのまま数字で確かめられます。k-SII の1次と2次をすべて足すと予測値 0.6683 に戻る点も、Shapley 値と同じです。 - 「所得 × 緯度」の相互作用
もう1つ意外だったのは、一番大きなペアが「緯度 × 経度」ではなく「所得 × 緯度」だったことです。同じ所得でも、北カリフォルニアか南カリフォルニアかで価格への効き方が変わる、とモデルは学習しているようです。Shapley 値だけを見ていたら、この構造には気づけませんでした。
ネットワーク図による可視化
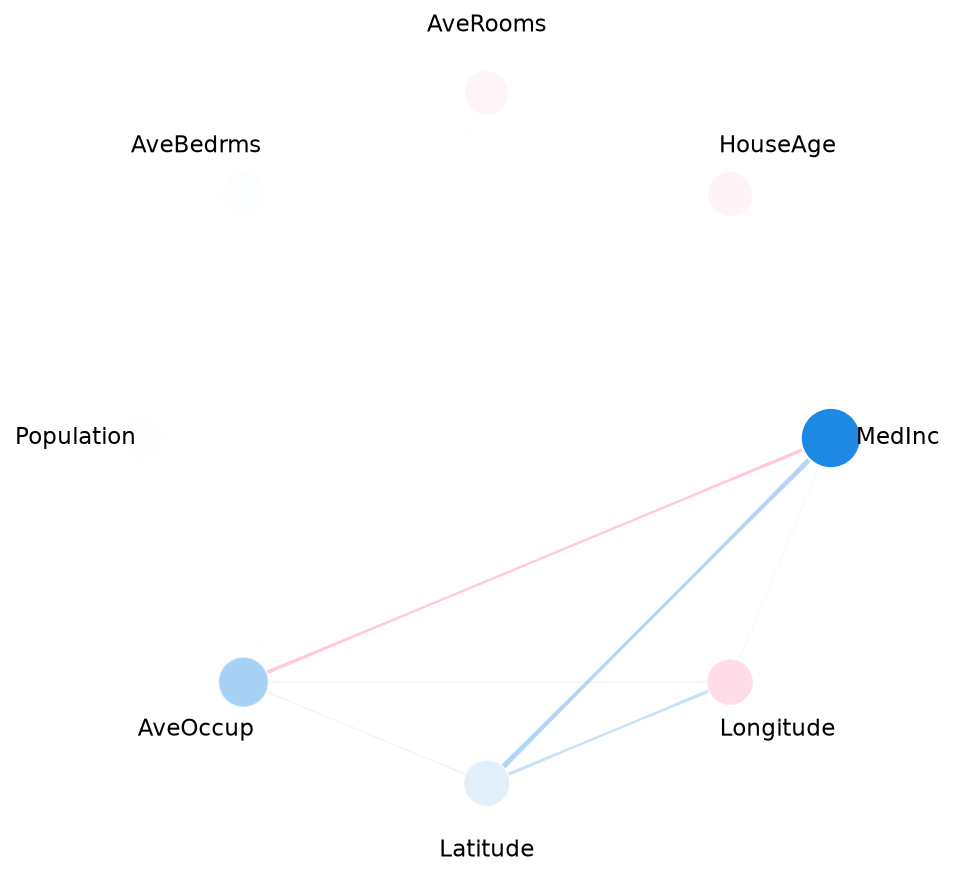
相互作用は plot_network でネットワーク図にできます。
- MedInc と Latitude を結ぶ太い青線:「所得 × 緯度」の効果
- Latitude と Longitude の線:「立地」の効果
- 経度のノード:赤(プラス)になっていて、Shapley 値のウォーターフォール図とは逆向きなのが分かります
ksii.plot_network(feature_names=feature_names, show=False)
⑤ budget を削ったときの近似精度
コードの実装
特徴が8個なら全組み合わせを評価できますが、特徴が30個になると 2³⁰ ≈ 10億通りなので現実的ではありません。そこで shapiq は、一部の組み合わせだけをサンプリングして近似します。
budget_convergence.py では、全組み合わせで求めた値を正解として、budget を減らしたときの誤差(乱数を変えて3回ずつ実行した平均)を測っています。
BUDGETS = [16, 32, 64, 128, 256]
N_REPEATS = 3  # サンプリングの乱数を変えて繰り返し、誤差を平均する

def explain(model, background, x, budget: int, seed: int) -> tuple[np.ndarray, float]:
    explainer = shapiq.TabularExplainer(
        model=model, data=background, index="k-SII", max_order=2, random_state=seed
    )
    start = time.perf_counter()
    iv = explainer.explain(x, budget=budget)
    elapsed = time.perf_counter() - start
    keys = sorted(key for key in iv.dict_values if len(key) >= 1)
    return np.array([iv[key] for key in keys]), elapsed
実行結果と budget の目安
budget=16 のときだけ誤差が桁違いに大きくなっています。2次までの k-SII で求める値は、合計37個です。
- ベースライン:1個
- 単独の特徴:8個
- ペア:28個
それより少ない評価回数では、未知数より式が少ない連立方程式を解くのと同じ状態になります。実際、budget=16 と 32 の誤差は実行のたびに大きく揺れ、手元では budget=16 の MSE が 0.1 台から 4 程度まで変わりました。
目安として、求めたい値の個数を budget が十分に上回っていることが必要そうです。次数を上げると求める値の数が急に増えるので、max_order=3 を試すときは budget も増やしてください。
実行例:
$ uv run budget-convergence
=== budget ごとの誤差(全組み合わせで求めた値との MSE)===
  budget          MSE    時間[s]
      16     2.22e+00     2.30
      32     1.65e-02     2.29
      64     8.63e-04     2.25
     128     1.09e-04     1.97
     256     1.59e-18     1.86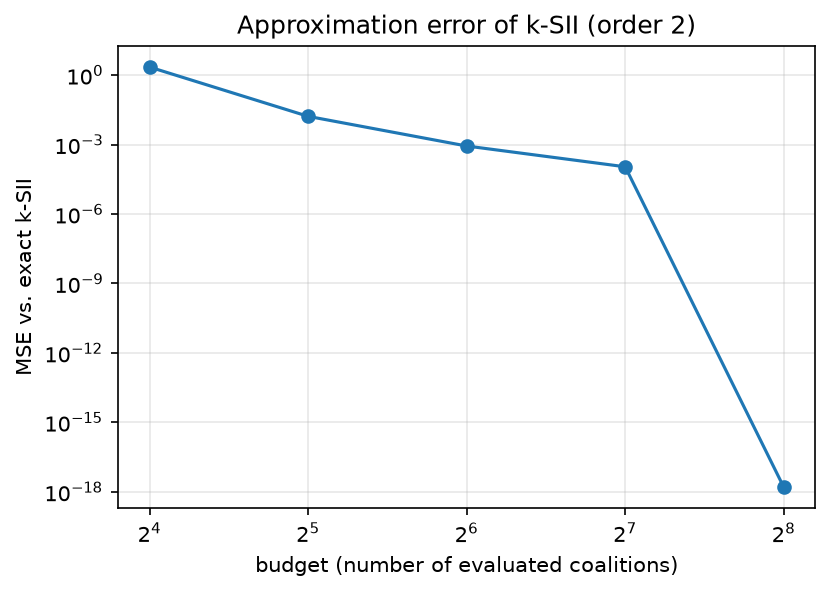
過信してはいけないポイント
「欠けた特徴」の埋め方で結果が変わる
TabularExplainer は、ある特徴を「使わない」場合をシミュレートするとき、その特徴を背景データの値で置き換えます(既定は marginal という方式)。緯度と経度のように強く相関する特徴では、「サンフランシスコの緯度 × ロサンゼルスの経度」のような実在しない家をモデルに入力することになります。
shapiq には imputer="conditional" という条件付きの補完方式もあるので、相関の強いデータでは比べてみる価値があります。
モデルの説明であって、世界の説明ではない
「所得 × 緯度」の相互作用は、このモデルがそう学習したというだけです。現実の住宅市場の因果関係を示しているわけではありません。
1件の説明だけで結論を出さない
Sanity Checks for Saliency Maps(Adebayo et al. 2018)以来、「もっともらしく見える説明」と「モデルの計算に忠実な説明」は別物だと繰り返し指摘されてきました。
Shapley 相互作用は定義のはっきりした手法ですが、背景データや補完方式の選び方ひとつで数字は動きます。複数のサンプルや設定で確かめるのが安全です。
さらに試すなら
発展的なアプローチ
サンプルコードを改造するなら、次のあたりが面白そうです。
indexを"STII"や"FSII"に変えて、同じ家の説明がどう変わるか比べるshapiq.TreeExplainerで、木モデル向けの高速な厳密計算を試すshapiq.TabPFNExplainerで、表形式の基盤モデル TabPFN(Hollmann et al. 2025)を説明する
TabPFN との組み合わせ
最後の TabPFN は特に気になっています。TabPFN は in-context learning で予測するので、特徴を抜いた状態の予測を、再学習ではなく推論1回で得られます(Interpretable Machine Learning for TabPFN、Rundel et al. 2024)。
これには次のようなメリットと注意点があります。
- メリット:欠けた特徴を背景データで埋める必要がなく、さきほどの「実在しない家」問題を避けられます。
- 注意点:ただ、TabPFN の新しい版はモデルの重みを取得するときにライセンスへの同意を求められることがあり、今回はまだ試せていません。
おわりに
shapiq は、SHAP と同じ使い勝手のまま、Shapley 値を特徴の組み合わせの効果まで拡張してくれるライブラリでした。index と max_order の2つを変えるだけで、Shapley 値の裏に隠れていたペアの効果を取り出せます。
一番の収穫は、見慣れた Shapley 値の数字が「単独の効果」と「ペアの効果の半分」の合計だと、手元の数字で確かめられたことでした。経度のように、Shapley 値では効いていないように見える特徴が、実は逆向きの効果を打ち消し合っていただけ、ということは普通に起こります。
一方で、相互作用の値も背景データや補完方式で動くこと、そしてあくまでモデルの説明にすぎないことは、Shapley 値と変わりません。LLM の内部を覗く研究が華やかな今だからこそ、表データの説明についても「その説明は本当に忠実か」を、複数のサンプルや設定で確かめながら使っていく必要がありそうです。
More Information
- arXiv:2410.01649, Muschalik et al., 「shapiq: Shapley Interactions for Machine Learning」
- GitHub: mmschlk/shapiq
- arXiv:1705.07874, Lundberg & Lee, 「A Unified Approach to Interpreting Model Predictions」
- Grabisch & Roubens, 「An axiomatic approach to the concept of interaction among players in cooperative games」
- arXiv:2209.04012, Bordt & von Luxburg, 「From Shapley Values to Generalized Additive Models and back」
- arXiv:1902.05622, Dhamdhere et al., 「The Shapley Taylor Interaction Index」
- arXiv:2203.00870, Tsai et al., 「Faith-Shap: The Faithful Shapley Interaction Index」
- arXiv:1810.03292, Adebayo et al., 「Sanity Checks for Saliency Maps」
- arXiv:2501.17148, Wu et al., 「AxBench: Steering LLMs? Even Simple Baselines Outperform Sparse Autoencoders」
- arXiv:2504.13151, Mueller et al., 「MIB: A Mechanistic Interpretability Benchmark」
- Ameisen et al., 「Circuit Tracing: Revealing Computational Graphs in Language Models」
- arXiv:2402.05602, Achtibat et al., 「AttnLRP: Attention-Aware Layer-Wise Relevance Propagation for Transformers」
- arXiv:2409.00729, Cohen-Wang et al., 「ContextCite: Attributing Model Generation to Context」
- Hollmann et al., 「Accurate predictions on small data with a tabular foundation model」(Nature, 2025)
- arXiv:2403.10923, Rundel et al., 「Interpretable Machine Learning for TabPFN」
関連記事
GluonTS入門: Pythonによる確率的時系列モデリング
時系列予測とは、過去の観測データに見られるパターンが将来も継続するという前提に基づき、未来の値を予測する技術です。これは、電力網における需給バランスの維持や、レストランや小売業における在庫の最適化など、ビジネスの様々な場 […]

LitServe: 機械学習モデルの効率的なデプロイ
機械学習モデルは、FlaskやFlastAPIなどのWebフレームワークを使用して、WebAPIとしてデプロイされることが一般的です。これらのフレームワークは、WebAPIを構築するための便利な機能が豊富に含まれています […]
Qwen3-TTS: 思い通りの声を創り出すAI音声合成
Qwenチーム(Alibaba Cloud)は、最新の多言語対応音声合成(TTS)モデルシリーズ「Qwen3-TTS」を公開しました。本モデルは500万時間以上という圧倒的な規模の音声データで学習され、日本語を含む10言 […]