因果探索で DAG は推定できるのか? PC・GES・DirectLiNGAM を比較して DoWhy で ATE まで求める
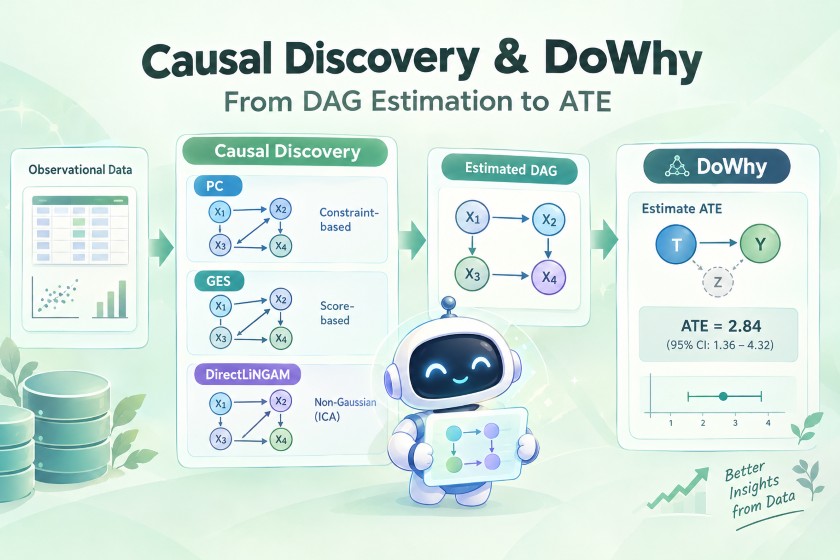
因果推論で介入の効果を求めるとき、出発点になるのが因果グラフ(DAG: Directed Acyclic Graph)です。どの変数がどの変数の原因になっているかが分かれば、バックドア基準で調整すべき変数が決まり、回帰分析や逆確率重み付け法(IPW)で平均処置効果(ATE)を推定できます。
以前の記事では、DoWhy を使って DAG の定義から ATE の推定までを一通り動かしました。ただ、そこでは DAG を「分析者が最初から知っているもの」として扱っています。実際に業務データへ適用しようとすると、まずここで手が止まります。変数が 10 個もあれば、すべての矢印の向きを自信を持って引ける人はそういません。
そこで選択肢に上がるのが、観測データから因果グラフを推定する因果探索(Causal Discovery)です。とはいえ、「相関関係から因果関係は分からない」と散々言われてきたはずなのに、データだけで本当に矢印の向きまで決められるのか、という疑問が湧きます。
この記事では、正解の DAG が分かっている合成データを使って、制約ベースの PC、スコアベースの GES、非ガウス性を利用する DirectLiNGAM の 3 手法を比較します。その上で、推定したグラフをそのまま DoWhy に渡して ATE を求め、グラフの推定誤差が最終的な効果推定にどう響くのかまでを確かめます。
因果探索の基礎:データから分かること、分からないこと
コードを動かす前に、観測データから矢印の向きを決めるとはどういうことなのか、前提を整理しておきます。
Markov 同値類と v 構造
まず、3 つの変数 \(X, Y, Z\) からなる次の 3 つの DAG を考えます。
(a) X → Y → Z (b) X ← Y ← Z (c) X ← Y → Z(a) と (b) は直列の連鎖、(c) は \(Y\) を共通原因とする分岐です。向きは違いますが、この 3 つはどれも「\(X\) と \(Z\) は相関しているが、\(Y\) で条件付けると独立になる」という、まったく同じ条件付き独立性のパターンを生みます。そのため、変数間の独立性だけを見る限り、この 3 つをデータから区別することはできません。
このように同じ独立性のパターンを持つ DAG の集まりを Markov 同値類(Markov Equivalence Class)と呼びます。また、同値類に含まれる DAG で共通して向きが決まる辺だけを有向辺 →、決まらない辺を無向辺 — で表したグラフを CPDAG(Completed Partially Directed Acyclic Graph)と呼びます。
ところが、もう 1 つの形だけは事情が違います。
(d) X → Y ← Z (v 構造、合流点)\(X\) と \(Z\) の間に辺がなく、両方から \(Y\) に矢印が入る形です。この場合、\(X\) と \(Z\) はもともと独立ですが、合流点である \(Y\) で条件付けると逆に相関が生まれます(合流点バイアス)。独立性のパターンが (a)〜(c) と明確に異なるため、この v 構造(v-structure)だけは条件付き独立性から矢印の向きを特定できます。
非ガウス性を手がかりにする LiNGAM
条件付き独立性だけを使う手法が CPDAG で止まるのに対して、データの分布の形まで踏み込むと、1 つの DAG に絞り込める場合があります。その代表例が LiNGAM(Linear Non-Gaussian Acyclic Model)です。
2 変数の線形モデル \(Y = bX + e\) を考えます。もし外生ノイズ \(e\) と原因 \(X\) が非ガウス分布に従うなら、正しい向き(\(X\) で \(Y\) を回帰)のときだけ残差と説明変数が独立になり、逆向き(\(Y\) で \(X\) を回帰)にすると残差と説明変数が独立にならなくなります。この非対称性を使えば、Markov 同値類の中から真の因果順序を 1 つに特定できます。
裏を返せば、ノイズが正規分布(ガウス分布)に従う場合は、どちらの向きに回帰しても残差と説明変数が無相関(したがって独立)になってしまい、この手がかりは消えます。
今回比較する 3 つの手法
今回取り上げる PC、GES、DirectLiNGAM の位置づけをまとめると、次のようになります。
| 手法 | アプローチ | ライブラリ | 向きを決める手がかり | 主な仮定 | 出力グラフ |
|---|---|---|---|---|---|
| PC | 制約ベース | causal-learn | 条件付き独立性検定と v 構造 | 因果的十分性・忠実性(Fisher-z 検定時は線形・ガウス) | CPDAG(無向辺を含む) |
| GES | スコアベース | causal-learn | BIC スコアの貪欲探索 | 因果的十分性・線形・ガウスノイズ | CPDAG(無向辺を含む) |
| DirectLiNGAM | 関数モデルベース | lingam | 残差と説明変数の独立性(非ガウス性) | 因果的十分性・線形・非ガウスノイズ | DAG(すべて有向辺) |
どの手法も「何らかの仮定のもとで」向きを決めています。仮定が満たされるデータと、仮定から外れるデータの両方をぶつけて、それぞれの振る舞いを見ていきます。
環境構築
ここからは Python で実験環境を作っていきます。
プロジェクトは uv で作成します。--package を付けて src レイアウトにし、pyproject.toml の [project.scripts] にエントリポイントを登録しておくと、uv run <コマンド名> で各実験を実行できます。
$ uv init --package --python 3.12 causal-discovery
$ cd causal-discovery
$ uv add causal-learn lingam networkx matplotlib numpy pandas scikit-learn dowhy
[project.scripts] causal-discovery = "causal_discovery:main" causal-discovery-toy = "causal_discovery:main_toy" causal-discovery-ate = "causal_discovery:main_ate"
ディレクトリ構成を次のようにします。
causal-discovery/
├── pyproject.toml
├── src/causal_discovery/
│   ├── __init__.py   # エントリポイント(main / main_toy / main_ate)
│   ├── data.py       # 合成データ(ランダム DAG + 構造方程式)
│   ├── methods.py    # PC / GES / DirectLiNGAM のラッパー
│   ├── metrics.py    # SHD などの評価指標
│   ├── effect.py     # DAG の列挙と DoWhy による ATE 推定
│   └── plot.py       # グラフと評価結果の可視化
└── results/
評価用のデータとアルゴリズムの実装
真の DAG が既知の合成データ
因果探索の評価で困るのは、実データには「正解の DAG」が付属していないことです。そこで、あらかじめプログラムで DAG を生成し、その構造方程式に従ってデータをサンプリングします。
データは構造方程式
$$x_j = \sum_{i \in \mathrm{pa}(j)} w_{ij} f_{ij}(x_i) + e_j$$
に従って、因果順序の上流から順に生成します。係数 \(w_{ij}\) は \(\pm[0.5, 2.0]\) から一様に選び、ノイズ \(e_j\) はどの分布でも分散が 1 になるように揃えます。data.py の実装は次のとおりです。
"""真の DAG が既知の合成データを生成する。

隣接行列は A[i, j] = 1 が i → j を表す(行が原因、列が結果)。
"""

from dataclasses import dataclass

import numpy as np

NOISE_TYPES = ("gaussian", "uniform", "laplace")

# 非線形シナリオで使う関数。どれも平均がほぼ 0 になるよう中心化してある。
# 二乗は対称な入力に対して相関が 0 になるので、線形の手法では辺を検出できない
NONLINEAR_FUNCS = (
    lambda x: np.sin(2 * x),
    lambda x: x**2 - 1,
    lambda x: np.tanh(2 * x),
)


@dataclass(frozen=True)
class SyntheticData:
    X: np.ndarray  # (n_samples, n_nodes)
    adjacency: np.ndarray  # (n_nodes, n_nodes), 0/1
    weights: np.ndarray  # (n_nodes, n_nodes)
    names: list[str]


def random_dag(n_nodes: int, expected_degree: float, rng: np.random.Generator) -> np.ndarray:
    """Erdős–Rényi 型のランダム DAG。因果順序はランダムに並べ替える。"""
    p = expected_degree / (n_nodes - 1)
    upper = np.triu(rng.random((n_nodes, n_nodes)) < p, k=1).astype(int)
    perm = rng.permutation(n_nodes)
    return upper[np.ix_(perm, perm)]


def _noise(kind: str, size: int, rng: np.random.Generator) -> np.ndarray:
    # どの分布も分散 1 にそろえる
    if kind == "gaussian":
        return rng.normal(0.0, 1.0, size)
    if kind == "uniform":
        return rng.uniform(-np.sqrt(3), np.sqrt(3), size)
    if kind == "laplace":
        return rng.laplace(0.0, 1 / np.sqrt(2), size)
    raise ValueError(f"unknown noise type: {kind}")


def sample_sem(
    adjacency: np.ndarray,
    n_samples: int,
    noise: str,
    nonlinear: bool,
    rng: np.random.Generator,
) -> tuple[np.ndarray, np.ndarray]:
    """構造方程式 x_j = Σ_i w_ij f_ij(x_i) + e_j に従ってサンプリングする。

    nonlinear=False なら f は恒等写像(線形 SEM)。True なら辺ごとに
    NONLINEAR_FUNCS からランダムに選ぶ。親は標準化してから f に通す
    (下流ほど値が大きくなり、f の効き方が変わるのを防ぐ)。
    """
    n_nodes = adjacency.shape[0]
    signs = rng.choice([-1.0, 1.0], size=adjacency.shape)
    weights = adjacency * signs * rng.uniform(0.5, 2.0, size=adjacency.shape)
    funcs = rng.integers(len(NONLINEAR_FUNCS), size=adjacency.shape)

    X = np.zeros((n_samples, n_nodes))
    for j in _topological_order(adjacency):
        x = _noise(noise, n_samples, rng)
        for i in np.flatnonzero(adjacency[:, j]):
            parent = X[:, i]
            if nonlinear:
                parent = NONLINEAR_FUNCS[funcs[i, j]]((parent - parent.mean()) / parent.std())
            x += weights[i, j] * parent
        X[:, j] = x
    return X, weights


def _topological_order(adjacency: np.ndarray) -> list[int]:
    indegree = adjacency.sum(axis=0).tolist()
    order: list[int] = []
    ready = [j for j, d in enumerate(indegree) if d == 0]
    while ready:
        i = ready.pop()
        order.append(i)
        for j in np.flatnonzero(adjacency[i]):
            indegree[j] -= 1
            if indegree[j] == 0:
                ready.append(int(j))
    return order


def make_synthetic(
    n_nodes: int = 8,
    expected_degree: float = 2.0,
    n_samples: int = 1000,
    noise: str = "uniform",
    nonlinear: bool = False,
    seed: int = 0,
) -> SyntheticData:
    rng = np.random.default_rng(seed)
    adjacency = random_dag(n_nodes, expected_degree, rng)
    X, weights = sample_sem(adjacency, n_samples, noise, nonlinear, rng)
    return SyntheticData(X, adjacency, weights, [f"X{i}" for i in range(n_nodes)])
ベンチマークでは、関数 \(f\) とノイズ分布の組み合わせを変えて次の 3 シナリオを用意します。
ノード数は 8、期待次数は 2(1 ノードあたり平均 2 本の辺)とし、サンプル数 \(n \in {200, 1000, 5000}\) のそれぞれで 10 シードずつ生成します。
| シナリオ | ノイズ分布 | 関数 \(f\) | 仮定を満たす手法 |
|---|---|---|---|
| 線形・ガウス | 正規分布 | 恒等写像 | PC / GES |
| 線形・非ガウス | 一様分布 | 恒等写像 | DirectLiNGAM(PC / GES も CPDAG までなら可) |
| 非線形・非ガウス | 一様分布 | \(\sin(2x)\) / \(x^2 – 1\) / \(\tanh(2x)\) を辺ごとに選択 | なし |
また、ランダムな DAG だけでは結果のグラフを目で追いにくいため、意味のある変数名を付けた 5 変数の DAG も make_toy() として用意しました。
季節 → 気温 → アイス売上
季節 → 広告費 → アイス売上
気温 → 来店者数 → アイス売上
季節が気温と広告費の両方に影響するため、「広告費 → アイス売上」の因果効果を知りたいときには季節が交絡因子になります。
def make_toy(n_samples: int = 2000, noise: str = "uniform", seed: int = 0) -> SyntheticData:
    """記事の図解用の小さな DAG(変数名つき)。"""
    names = ["季節", "気温", "広告費", "来店者数", "アイス売上"]
    edges = [(0, 1), (0, 2), (1, 3), (1, 4), (2, 4), (3, 4)]
    adjacency = np.zeros((len(names), len(names)), dtype=int)
    for i, j in edges:
        adjacency[i, j] = 1
    rng = np.random.default_rng(seed)
    X, weights = sample_sem(adjacency, n_samples, noise, nonlinear=False, rng=rng)
    return SyntheticData(X, adjacency, weights, names)
評価指標
推定されたグラフと正解グラフの比較には、次の指標を使います。
| 指標 | 内容 |
|---|---|
| SHD(Structural Hamming Distance) | ノード対ごとに、辺の欠落・余分・逆向き・向き未決定のいずれかがあれば 1 を加算する距離(0 なら完全一致) |
| skeleton F1 | 矢印の向きを無視して、辺の有無(スケルトン)だけを評価した F1 スコア |
| arrow F1 | 向きまで含めて正しく検出できた有向辺の F1 スコア(無向辺は「向きを予測しなかった」扱い) |
PC と GES を評価するときには、比較対象のグラフに注意が要ります。両者は原理的に CPDAG までしか特定できないため、真の DAG と直接比較すると、データからはそもそも決定できない無向辺までエラーとしてカウントされてしまいます。そこで、真の DAG と比べた shd に加えて、causal-learn の dag2cpdag で求めた真の CPDAG と比較した shd_cpdag も記録します。
"""推定グラフ E と真の DAG A の比較指標。E の形式は methods.py を参照。"""

import numpy as np
from causallearn.graph.Dag import Dag
from causallearn.graph.GraphNode import GraphNode
from causallearn.utils.DAG2CPDAG import dag2cpdag

from .methods import from_causallearn


def true_cpdag(A: np.ndarray) -> np.ndarray:
    """真の DAG の Markov 同値類(CPDAG)。PC / GES が原理的に到達できる上限。"""
    nodes = [GraphNode(f"X{i}") for i in range(A.shape[0])]
    dag = Dag(nodes)
    for i, j in zip(*np.nonzero(A)):
        dag.add_directed_edge(nodes[i], nodes[j])
    return from_causallearn(dag2cpdag(dag).graph)


def _skeleton(M: np.ndarray) -> np.ndarray:
    return np.triu((M + M.T) > 0, k=1)


def _directed(M: np.ndarray) -> np.ndarray:
    return (M == 1) & (M.T == 0)


def shd(E: np.ndarray, A: np.ndarray) -> int:
    """Structural Hamming Distance。

    ノード対ごとに「辺の有無・向き」が真の DAG と食い違えば 1 と数える
    (欠落・余分・逆向き・向き未決定のいずれも 1)。
    """
    n = A.shape[0]
    count = 0
    for i in range(n):
        for j in range(i + 1, n):
            if (E[i, j], E[j, i]) != (A[i, j], A[j, i]):
                count += 1
    return count


def _prf(tp: int, n_pred: int, n_true: int) -> tuple[float, float, float]:
    precision = tp / n_pred if n_pred else float("nan")
    recall = tp / n_true if n_true else float("nan")
    f1 = 2 * tp / (n_pred + n_true) if (n_pred + n_true) else float("nan")
    return precision, recall, f1


def evaluate(E: np.ndarray, A: np.ndarray) -> dict[str, float]:
    skel_e, skel_a = _skeleton(E), _skeleton(A)
    dir_e, dir_a = _directed(E), _directed(A)

    skel_p, skel_r, skel_f1 = _prf(int((skel_e & skel_a).sum()), int(skel_e.sum()), int(skel_a.sum()))
    # 向きの指標: 向きを決めた辺のうち正しい割合(precision)と、真の辺のうち正しい向きで当てた割合(recall)
    dir_p, dir_r, dir_f1 = _prf(int((dir_e & dir_a).sum()), int(dir_e.sum()), int(dir_a.sum()))

    return {
        "shd": shd(E, A),
        # 真の CPDAG との SHD。PC / GES は DAG ではなくこちらで評価するのが公平
        "shd_cpdag": shd(E, true_cpdag(A)),
        "skeleton_precision": skel_p,
        "skeleton_recall": skel_r,
        "skeleton_f1": skel_f1,
        "arrow_precision": dir_p,
        "arrow_recall": dir_r,
        "arrow_f1": dir_f1,
        "n_true_edges": int(skel_a.sum()),
        "n_est_edges": int(skel_e.sum()),
        "n_undirected": int((skel_e & ~(_skeleton(dir_e.astype(int)))).sum()),
    }
3 つの手法のラッパー
causal-learn と lingam では、出力されるグラフ行列の表現方法が異なります。causal-learn は graph[i, j] = -1 かつ graph[j, i] = 1 で \(i \to j\) を表し、両方 -1 なら無向辺になります。一方、lingam の adjacency_matrix_[i, j] は \(j \to i\) の回帰係数を格納しており、行と列の向きが逆です。
そのまま扱うと添字の取り違えが起きやすいので、E[i, j] = 1 かつ E[j, i] = 0 なら \(i \to j\)、両方 1 なら無向辺 \(i – j\) という共通形式に揃えるラッパーを methods.py に用意しました。
PC の独立性検定には偏相関係数に基づく Fisher-z 検定(fisherz)、GES のスコア関数には BIC(local_score_BIC)を指定しています。どちらも線形・ガウスを前提とした標準的な設定です。
"""因果探索アルゴリズムの薄いラッパー。

どの手法も同じ形式の行列 E を返す:
    E[i, j] = 1, E[j, i] = 0 … i → j(向きが決まった辺)
    E[i, j] = E[j, i] = 1    … i — j(向きが決まらない辺)

PC / GES は Markov 同値類(CPDAG)までしか識別できないため無向辺が残りうる。
DirectLiNGAM は非ガウス性を使って DAG を一意に決めるので、常に有向辺のみになる。
"""

from collections.abc import Callable

import lingam
import numpy as np
from causallearn.search.ConstraintBased.PC import pc
from causallearn.search.ScoreBased.GES import ges


def from_causallearn(graph: np.ndarray) -> np.ndarray:
    # causal-learn: graph[i, j] = -1 かつ graph[j, i] = 1 が i → j。
    # 両方 -1 は無向辺、両方 1 は双方向辺(ここでは無向として扱う)。
    n = graph.shape[0]
    E = np.zeros((n, n), dtype=int)
    for i in range(n):
        for j in range(n):
            if i == j or graph[i, j] == 0:
                continue
            if graph[i, j] == -1 and graph[j, i] == 1:
                E[i, j] = 1
            elif graph[i, j] == graph[j, i]:
                E[i, j] = E[j, i] = 1
    return E


def run_pc(X: np.ndarray, alpha: float = 0.01) -> np.ndarray:
    cg = pc(X, alpha=alpha, indep_test="fisherz", show_progress=False)
    return from_causallearn(cg.G.graph)


def run_ges(X: np.ndarray) -> np.ndarray:
    record = ges(X, score_func="local_score_BIC")
    return from_causallearn(record["G"].graph)


def run_direct_lingam(X: np.ndarray, threshold: float = 0.05) -> np.ndarray:
    model = lingam.DirectLiNGAM()
    model.fit(X)
    # lingam: adjacency_matrix_[i, j] は j → i の係数
    return (np.abs(model.adjacency_matrix_.T) > threshold).astype(int)


METHODS: dict[str, Callable[[np.ndarray], np.ndarray]] = {
    "PC": run_pc,
    "GES": run_ges,
    "DirectLiNGAM": run_direct_lingam,
}
実験1:5 変数の図解用 DAG で試す
まずは 5 変数の「アイス売上」データ(\(n = 2000\))に対して 3 手法を実行し、どのようなグラフが出力されるかを見てみます。データは各変数を標準化してから渡しています。
$ uv run causal-discovery-toyノイズが一様分布(非ガウス)の場合
ノイズを一様分布にしたときの推定結果が図1です。青い実線が向きまで正解した辺、オレンジが逆向きの辺、黒い実線が無向辺(向き未決定)、赤い破線が余分な辺、灰色の点線が欠落した辺を表します。
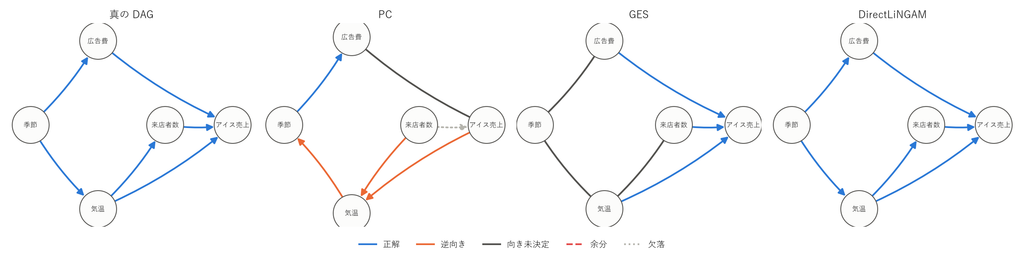
各手法の評価指標は次のようになりました。
| 手法 | SHD | arrow F1 | 無向辺 |
|---|---|---|---|
| PC | 5 | 0.20 | 1 |
| GES | 3 | 0.67 | 3 |
| DirectLiNGAM | 0 | 1.00 | 0 |
DirectLiNGAM は 6 本の辺すべてを正しい向きで復元しました。線形かつ非ガウスというモデルの仮定がデータ生成過程と一致しているケースです。
GES は SHD が 3 ですが、実はこの出力は真の CPDAG と完全に一致しています。「アイス売上」に入る 3 本の矢印は、アイス売上が v 構造の合流点(たとえば「広告費 → アイス売上 ← 気温」)になっているため向きが確定します。一方で、「季節 — 気温」「季節 — 広告費」「気温 — 来店者数」の 3 本には v 構造が絡まないため、条件付き独立性だけでは向きを決められません。SHD の 3 は、この原理的に向きが決まらない 3 本が無向辺として残ったことによるものです。
PC は「来店者数 → アイス売上」の辺を取りこぼしたうえで、3 本の辺を逆向きに推定しています。PC は独立性検定の結果から v 構造を見つけ、そこから連鎖的に他の辺の向きを決めていくアルゴリズムなので、検定の誤りが 1 箇所でもあると周囲の向きまで玉突きで反転しやすいという脆さがあります。
ノイズが正規分布(ガウス)の場合
続いて、同じ DAG・同じ係数で、ノイズだけを正規分布に変えたときの結果が図2です。
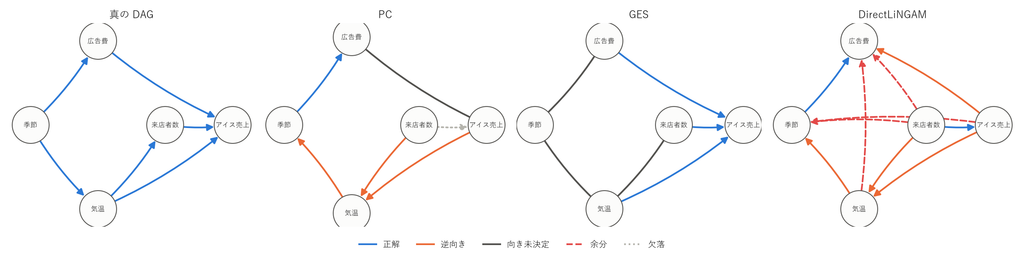
PC と GES の推定結果は一様ノイズのときと変わりません。対照的に、DirectLiNGAM は SHD が 8 まで悪化し、余分な辺や逆向きの辺が多数現れました。ノイズがガウス分布になると、DirectLiNGAM が頼りにしている「残差と説明変数の独立性」という手がかりが失われるためです。
ここで厄介なのは、手がかりが消えていても DirectLiNGAM はエラーや「向き不明」を返すわけではなく、もっともらしい有向グラフをそのまま出力してくる点です。
実験2:ランダム DAG によるベンチマーク
1 つの DAG だけでは偶然の当たり外れもあるため、8 ノードのランダム DAG を使って、3 シナリオ × 3 サンプル数 × 10 シードの計 90 条件で評価します。
$ uv run causal-discovery真の DAG との SHD
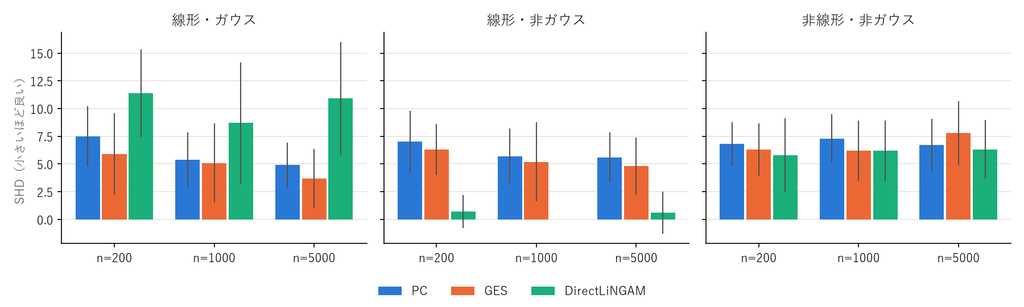
まず、真の DAG との SHD をシナリオ・サンプル数ごとに比較した結果が図3と次の表です(10 シードの平均値、真の DAG の辺数は平均 8 本前後)。
| シナリオ | \(n\) | PC | GES | DirectLiNGAM |
|---|---|---|---|---|
| 線形・ガウス | 200 | 7.5 | 5.9 | 11.4 |
| 1,000 | 5.4 | 5.1 | 8.7 | |
| 5,000 | 4.9 | 3.7 | 10.9 | |
| 線形・非ガウス | 200 | 7.0 | 6.3 | 0.7 |
| 1,000 | 5.7 | 5.2 | 0.0 | |
| 5,000 | 5.6 | 4.8 | 0.6 | |
| 非線形・非ガウス | 200 | 6.8 | 6.3 | 5.8 |
| 1,000 | 7.3 | 6.2 | 6.2 | |
| 5,000 | 6.7 | 7.8 | 6.3 |
最も極端な動きを見せたのは DirectLiNGAM です。線形・非ガウスでは SHD が 0.0〜0.7 とほぼ完璧に DAG を当てているのに対し、線形・ガウスでは 8.7〜11.4 と 3 手法で最悪になりました。しかも、サンプル数を 200 から 5,000 に増やしてもまったく改善しません。データ中に存在しない非ガウス性は、サンプル数をいくら増やしても現れないからです。
非線形・非ガウスのシナリオでは、3 手法とも SHD が 6〜8 前後で頭打ちになりました。\(x^2 – 1\) のように一次相関が消える関係が含まれると、偏相関や線形回帰に基づく手法では辺の存在自体を検出できなくなります。
真の CPDAG との SHD
次に、同じ推定結果を「真の CPDAG」との SHD で評価し直したものが図4です。
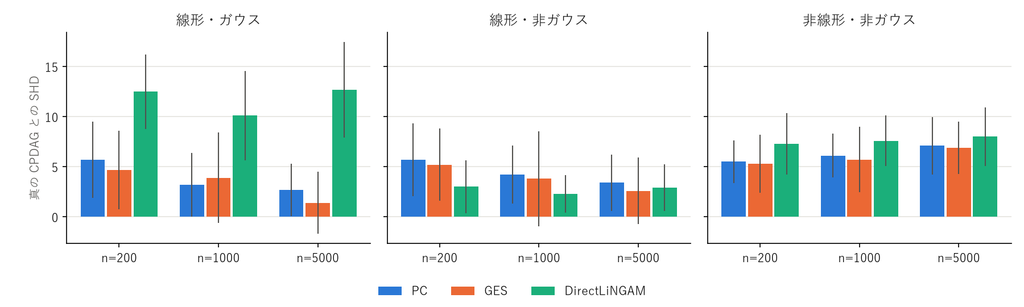
| シナリオ | \(n\) | PC | GES |
|---|---|---|---|
| 線形・ガウス | 200 | 5.7 | 4.7 |
| 1,000 | 3.2 | 3.9 | |
| 5,000 | 2.7 | 1.4 | |
| 線形・非ガウス | 5,000 | 3.4 | 2.6 |
線形・ガウス(\(n = 5000\))での GES の SHD は、真の DAG との比較では 3.7 でしたが、真の CPDAG との比較では 1.4 まで下がります。PC も 4.9 から 2.7 に減少しました。つまり、表の上で見えていた PC や GES の「誤り」の半分以上は、アルゴリズムの失敗ではなく、条件付き独立性からは原理的に決定できない無向辺だったことが分かります。
なお、DirectLiNGAM はすべての辺に必ず向きを付けるため、無向辺を含む CPDAG と比較すると逆に SHD が増えます(図4では参考値として載せています)。
辺の向きの再現精度(arrow F1)
向きまで含めて正しく辺を復元できた割合を arrow F1 で見たものが図5です。
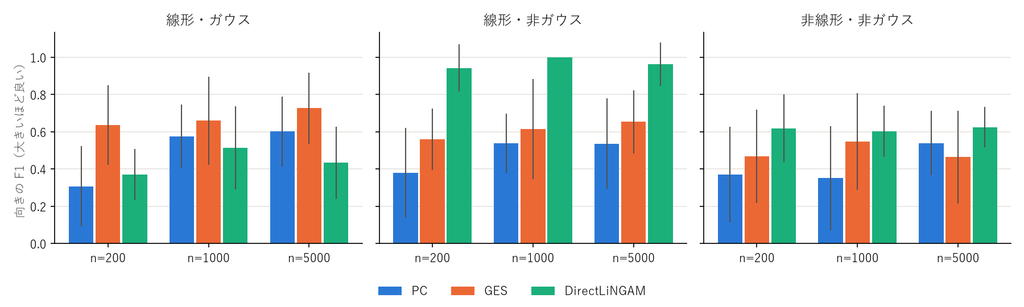
線形・非ガウスにおける DirectLiNGAM は 0.94〜1.00 に達します。一方、PC と GES は無向辺を残す分だけ recall が頭打ちになるため、仮定を満たす線形・ガウスでも 0.6〜0.7 程度にとどまります。
標準化の有無による比較(varsortability)
合成データを使った因果探索のベンチマークでは、varsortability(Reisach et al., 2021)と呼ばれる問題が指摘されています。構造方程式に従って上流から下流へ値を足し上げていくと、下流の変数ほど分散が大きくなりやすく、手法によってはこの「分散の大きさの順序」を手がかりにして見かけ上の高精度を出してしまうという現象です。
今回の実験で影響が出ているかを確かめるため、生データのまま渡した場合と、各変数を標準化(平均 0・分散 1)してから渡した場合の SHD を比較しました。
| 手法 | SHD(生データ) | SHD(標準化) |
|---|---|---|
| PC | 6.32 | 6.32 |
| GES | 5.70 | 5.70 |
| DirectLiNGAM | 5.63 | 5.62 |
(全シナリオ・全サンプル数の平均)
3 手法とも、標準化の有無で結果はほぼ変わりませんでした。PC の Fisher-z 検定や GES のガウス BIC、DirectLiNGAM の独立性指標はいずれも変数のスケールに不変な形で計算されるためです。varsortability が大きく影響するのは、NOTEARS のように二乗誤差をそのまま連続最適化するタイプの手法です。
実験3:推定した DAG を DoWhy に渡して ATE を求める
ここからは後半の検証に入ります。実務で因果探索を使う目的は、グラフを描くこと自体ではなく、そのグラフを使って介入の効果(ATE)を推定することにあるはずです。推定したグラフを DoWhy に渡したとき、ATE の推定値が正解からどのくらいずれるのかを調べます。
真の総合効果の計算
線形の構造方程式 \(X = XW + e\)(\(W_{ij}\) は \(i \to j\) の係数)では、処置変数 \(t\) に 1 単位の介入を行ったときに結果変数 \(y\) に生じる総合効果(直接効果と、中間変数を経由する間接効果の合計)は、幾何級数 \(W + W^2 + W^3 + \cdots\) の和として次の式で計算できます。
$$\text{ATE}_{t \to y} = \left[(I – W)^{-1}\right]_{t, y}$$
これを真の ATE とし、各アプローチの推定値と比較します。
同値類に含まれる DAG の列挙と DoWhy による推定
推定グラフを DoWhy に渡す際、DirectLiNGAM の出力は最初から DAG なのでそのまま渡せますが、PC と GES の出力(CPDAG)には無向辺が含まれます。DoWhy の CausalModel は有向グラフを前提としているため、無向辺が残ったままではバックドア基準の判定ができません。
そこで、無向辺にすべてのパターンの向きを割り当ててみて、次の 2 条件を満たす DAG をすべて列挙します。
- グラフ全体が非巡回(DAG)であること
- 新しい v 構造を作らないこと(新しい v 構造ができると、元の CPDAG とは別の Markov 同値類に移ってしまうため)
こうして得られた同値類内の各 DAG について DoWhy で ATE を推定し、「データと整合する ATE の候補集合」として扱います。これは Maathuis et al.(2009)が提案した IDA(Intervention-calculus when the DAG is Absent)の基本的なアイデアと同じです。今回は 8 ノード規模なので、無向辺の向きを総当たりで列挙しました。effect.py の実装は次のとおりです。
"""推定した因果グラフを DoWhy に渡し、ATE を推定する。

グラフの形式は methods.py と同じ(E[i, j] = 1 かつ E[j, i] = 0 が i → j、両方 1 が無向辺)。
PC / GES の出力(CPDAG)は向きの決まらない辺を含み、そのままでは DoWhy に渡せない。
そこで同値類に含まれる DAG をすべて列挙し、DAG ごとに ATE を推定して「取りうる値の集合」とする
(Maathuis et al., 2009 の IDA と同じ考え方)。
"""

import itertools
import logging
import warnings

import networkx as nx
import numpy as np
import pandas as pd
from dowhy import CausalModel

logging.getLogger("dowhy").setLevel(logging.ERROR)

# 列挙する無向辺の上限(2^k 通りを総当たりするため)
MAX_UNDIRECTED = 12


def true_total_effect(weights: np.ndarray, t: int, y: int) -> float:
    """線形 SEM X = X W + e における t → y の総合効果 = [(I - W)^-1]_{t, y}。"""
    n = weights.shape[0]
    return float(np.linalg.inv(np.eye(n) - weights)[t, y])


def _v_structures(G: nx.DiGraph, skeleton: np.ndarray) -> set[tuple[int, int, int]]:
    """a → c ← b で、a と b がスケルトン上で隣接していないもの。"""
    vs = set()
    for c in G.nodes:
        for a, b in itertools.combinations(sorted(G.predecessors(c)), 2):
            if not skeleton[a, b]:
                vs.add((a, c, b))
    return vs


def dag_extensions(E: np.ndarray) -> list[nx.DiGraph]:
    """E の無向辺に向きを付けた DAG のうち、非巡回かつ新しい v 構造を作らないものを列挙する。

    E に無向辺がなければ、E 自身が DAG ならそれ 1 つを返す(巡回していれば空リスト)。
    """
    n = E.shape[0]
    directed = [(i, j) for i in range(n) for j in range(n) if E[i, j] and not E[j, i]]
    undirected = [(i, j) for i in range(n) for j in range(i + 1, n) if E[i, j] and E[j, i]]
    if len(undirected) > MAX_UNDIRECTED:
        raise ValueError(f"too many undirected edges: {len(undirected)}")

    skeleton = (E + E.T) > 0
    base = nx.DiGraph(directed)
    base.add_nodes_from(range(n))
    base_vs = _v_structures(base, skeleton)

    dags = []
    for flips in itertools.product((False, True), repeat=len(undirected)):
        G = base.copy()
        G.add_edges_from((j, i) if f else (i, j) for (i, j), f in zip(undirected, flips))
        if nx.is_directed_acyclic_graph(G) and _v_structures(G, skeleton) == base_vs:
            dags.append(G)
    return dags


def estimate_ate(df: pd.DataFrame, G: nx.DiGraph, t: str, y: str) -> float:
    """DoWhy でバックドア調整(線形回帰)による ATE を推定する。"""
    if not nx.has_path(G, t, y):
        return 0.0  # グラフ上 t から y への因果パスがなければ効果は 0
    with warnings.catch_warnings():
        warnings.simplefilter("ignore")
        model = CausalModel(data=df, treatment=t, outcome=y, graph=G)
        estimand = model.identify_effect(proceed_when_unidentifiable=True)
        estimate = model.estimate_effect(estimand, method_name="backdoor.linear_regression")
    return float(estimate.value)


def estimate_ate_from_graph(df: pd.DataFrame, E: np.ndarray, t: int, y: int) -> list[float]:
    """推定グラフ E(CPDAG でも DAG でもよい)から、取りうる ATE を DAG ごとに返す。"""
    names = list(df.columns)
    estimates = []
    for G in dag_extensions(E):
        G = nx.relabel_nodes(G, dict(enumerate(names)))
        estimates.append(estimate_ate(df, G, names[t], names[y]))
    return estimates


def ols_coef(df: pd.DataFrame, t: str, y: str, covariates: list[str]) -> float:
    """y ~ t + covariates の線形回帰における t の係数(ベースライン用)。"""
    X = np.column_stack([np.ones(len(df)), df[[t, *covariates]].to_numpy()])
    coef, *_ = np.linalg.lstsq(X, df[y].to_numpy(), rcond=None)
    return float(coef[1])
DoWhy 0.13 では、CausalModel の graph 引数に networkx の DiGraph を直接渡せるため、列挙したグラフを変換なしでそのまま評価できます。なお、グラフ上で \(t\) から \(y\) への有向パスが存在しない場合は、因果効果を 0 として返しています。
また、因果グラフを使わない比較用のベースラインとして、目的変数を処置変数だけで単回帰する「調整なし」と、処置・結果以外のすべての変数を共変量に入れて重回帰する「全変数で調整」の 2 つも計算します。「手元にある変数をとりあえず全部回帰モデルに入れる」というのは実務でよく見かけるやり方ですが、それでどのくらい戦えるのかを確かめます。
5 変数の図解用 DAG:広告費 → アイス売上
まずは一様ノイズで生成した 5 変数の図解用 DAG で、「広告費 → アイス売上」の ATE を推定してみます。真の ATE は 1.971 です。
$ uv run causal-discovery-ate
== 図解用 DAG: 広告費 → アイス売上
        調整なし: 推定 2.779(真値 1.971, DAG 数 1)
      全変数で調整: 推定 1.974(真値 1.971, DAG 数 1)
      真の DAG: 推定 1.990(真値 1.971, DAG 数 1)
          PC: 推定 nan(真値 1.971, DAG 数 0)
         GES: 推定 2.186(真値 1.971, DAG 数 4)
DirectLiNGAM: 推定 1.990(真値 1.971, DAG 数 1)
PC の同値類内の推定値: []
GES の同値類内の推定値: [1.99, 2.779, 1.988, 1.988]
それぞれの結果を見ていきます。
- 調整なし(単回帰)では 2.779 となり、共通原因である「季節」を経由した交絡バイアスによって 4 割ほど過大評価されています。
- 真の DAG と DirectLiNGAM はどちらも 1.990 で、真値(1.971)とほぼ一致しました。DoWhy がバックドア基準に従って「季節」を調整変数に選んでいます。
- GES の出力(CPDAG)からは、条件を満たす DAG が 4 つ列挙されました。そのうち 3 つは約 1.99 を返していますが、残り 1 つだけ 2.779(調整なしと同じ値)になっています。この 1 つは「季節 — 広告費」の無向辺を「広告費 → 季節」と向き付けた DAG で、季節が広告費の結果側になるため調整変数から外れてしまいます。条件付き独立性だけでは、この 4 つのうちどれが真の DAG かを区別できません。
- PC の出力からは、整合する DAG が 1 つも得られませんでした(DAG 数 0)。実験1で見たように PC は 3 本の向きを逆に推定しており、有向辺の時点で「季節 → 広告費 — アイス売上 → 気温 → 季節」という形になっていました。残った無向辺「広告費 — アイス売上」をどちらに向けても、閉路ができるか新しい v 構造が生じてしまいます。PC は検定の誤りが重なると、どの DAG とも整合しないグラフを出力することがあります。
なお、この 5 変数の例では「全変数で調整」も 1.974 と良い値が出ています。これは、処置である「広告費」から結果の「アイス売上」への経路の途中に中間変数がなく、かつアイス売上の下流に合流点もない構造だからです。一般のグラフでも同じようにうまくいくのか、次のベンチマークで確かめます。
ランダムな 20 個の DAG による比較
線形の 2 シナリオ(ガウス / 非ガウス)それぞれについて、8 ノード・\(n = 2000\) のランダム DAG を 20 個ずつ生成し、ATE の推定誤差を比較しました。処置 \(t\) と結果 \(y\) のペアは、「\(t\) が \(y\) の祖先であり、かつ \(t\) と \(y\) に共通の祖先(交絡因子)が存在する組」からランダムに 1 組選んでいます。
def _pick_treatment_outcome(A: np.ndarray, rng: np.random.Generator) -> tuple[int, int] | None:
    """t が y の祖先で、かつ t と y に共通の祖先(交絡)がある組を選ぶ。なければ祖先関係だけで選ぶ。"""
    G = nx.DiGraph(A)
    pairs = [(t, y) for t in G for y in nx.descendants(G, t)]
    confounded = [(t, y) for t, y in pairs if nx.ancestors(G, t) & nx.ancestors(G, y)]
    candidates = confounded or pairs
    return candidates[rng.integers(len(candidates))] if candidates else None
推定値と真値の絶対誤差 \(|\widehat{\text{ATE}} – \text{ATE}|\) の分布が図6、その中央値をまとめたものが次の表です(真の \(|\text{ATE}|\) の中央値は 1.19)。PC と GES については、同値類内の DAG の推定値の平均を代表値とした場合の誤差に加え、同値類内で最も真値に近かった DAG(最良)と最も遠かった DAG(最悪)の誤差も併記しています。
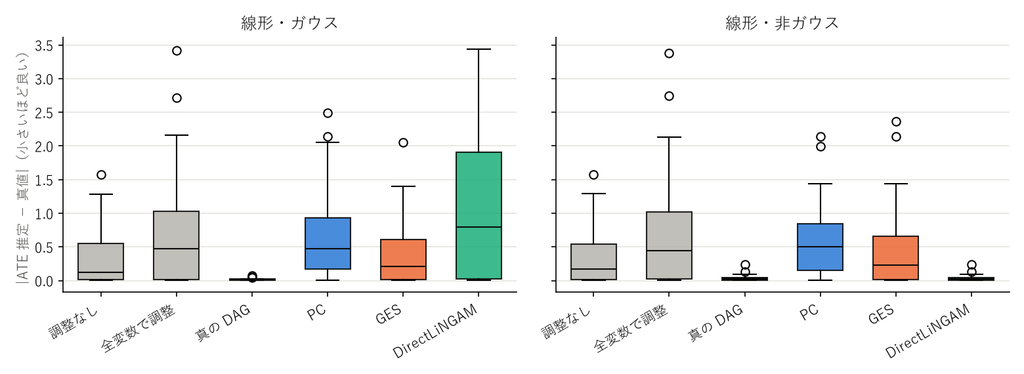
| アプローチ | 線形・ガウス | 線形・非ガウス |
|---|---|---|
| 調整なし | 0.127 | 0.167 |
| 全変数で調整 | 0.471 | 0.442 |
| 真の DAG | 0.012 | 0.020 |
| PC(同値類の平均 / 最良 / 最悪) | 0.474 / 0.025 / 0.992 | 0.507 / 0.057 / 0.987 |
| GES(同値類の平均 / 最良 / 最悪) | 0.207 / 0.016 / 0.563 | 0.225 / 0.016 / 0.543 |
| DirectLiNGAM | 0.791 | 0.020 |
この結果から、いくつか興味深い傾向が読み取れます。
まず、真の DAG を DoWhy に渡したときの誤差の中央値は 0.012〜0.020 とごくわずかです。グラフさえ正しければバックドア調整は期待通りに機能しており、他のアプローチで見られる大きな誤差はすべて「どの変数を調整すべきかの判断ミス(=グラフの誤り)」から生じています。
また、「全変数で調整」は誤差の中央値が 0.442〜0.471 となり、何もしない「調整なし」(0.127〜0.167)よりも大きく悪化しました。8 ノードのランダム DAG では、処置と結果の間にある中間変数や、両者の下流にある合流点が他の変数の中に高確率で混ざります。それらを無差別に共変量へ入れると、間接効果をブロックしてしまったり、合流点バイアスを新たに開いてしまったりするためです。以前の記事で整理した d 分離とバックドア基準がなぜ必要なのかが、数字としてはっきり表れています。
因果探索の 3 手法に目を向けると、実験2のグラフ復元の結果がそのまま ATE の精度に直結していました。DirectLiNGAM は、仮定が合う線形・非ガウスでは誤差 0.020 と真の DAG に並びますが、線形・ガウスでは 0.791 と全アプローチ中で最も大きな誤差を出しています。誤った有向グラフをもとに調整変数を選ぶと、「全変数で調整」以上にバイアスが乗ることが分かります。
一方、GES は同値類の中に「最良の DAG」(誤差 0.016)をほぼ確実に含んでいますが、同値類の中には誤差 0.5 以上になる「最悪の DAG」も混ざっています。データからはそのどれが正解かを選べないため、平均をとると誤差は 0.21〜0.23 程度になります。それでも、無向辺を無理に 1 つの向きへ決め打ちせず、同値類内の最小値〜最大値を「データから言える ATE の範囲」として扱う使い方は、仮定の外れた DirectLiNGAM の値をそのまま信じるよりずっと安全です。
過信してはいけないポイント
どの手法も「仮定が外れている」とは教えてくれない
今回の実験を通して一番強く感じたのは、アルゴリズム自体は前提条件が崩れていても警告を出さず、もっともらしいグラフを返してくるという点です。DirectLiNGAM はガウスノイズに対しても DAG を出力しますし、PC や GES も非線形データに対して何らかのグラフを返します。
実データでは真の DAG と答え合わせができないため、手法の仮定(線形性や残差の非ガウス性など)が成り立っているかは、散布図や残差の分布、あるいは複数の手法の出力を見比べるといった別の手段で確認する必要があります。
未観測の交絡因子は想定していない
今回扱った 3 手法はいずれも、共通原因となる変数がすべてデータに含まれていること(因果的十分性)を前提としています。実務のデータでは、観測できていない交絡因子が存在することのほうが普通です。未観測の交絡を考慮したい場合は、PC を拡張した FCI(Fast Causal Inference)や、潜在共通原因を許容する LiNGAM 系の手法(BottomUpParceLiNGAM など)を検討する必要があります。
非線形モデルでの効果推定は別途設計が要る
後半の ATE 推定では、DoWhy の backdoor.linear_regression を使ったため、線形の 2 シナリオのみを対象としました。非線形な関係を含むデータでは、因果探索の側にカーネル独立性検定(KCI)などを使った手法を採用したうえで、効果推定の側も EconML の Double Machine Learning や Meta-Learners と組み合わせる必要があります。
おわりに
正解の DAG が分かっている合成データを使って、PC・GES・DirectLiNGAM の 3 手法による因果探索を比較し、さらに推定したグラフを DoWhy に渡して ATE の推定誤差まで検証しました。
一番の収穫は、「仮定が合っていれば驚くほど正確に DAG も ATE も復元できるが、仮定が外れるとサンプル数を増やしても改善せず、静かに大きく外す」という挙動を手元のコードと数字で確かめられたことです。特に線形・非ガウスの条件では、DirectLiNGAM が推定した DAG をそのまま DoWhy に渡すだけで、真の DAG を使った場合と変わらない精度(誤差中央値 0.020)で ATE が求まりました。その一方で、ノイズをガウス分布に変えた途端に「全変数で調整」よりも悪い推定値になるという極端さも確認できました。
また、PC や GES の評価では、真の DAG ではなく真の CPDAG と比較することで、見かけ上のエラーの大半が「データからは原理的に向きを決められない辺」であることが分かりました。無向辺が残ったグラフを DoWhy に繋ぐには、同値類に含まれる DAG を列挙して ATE を「取りうる値の範囲」として見るのが現実的な落としどころになりそうです。向きの決まらない辺がどこに残るかが分かれば、「ここだけはドメイン知識や追加調査で向きを決める必要がある」という議論のたたき台にもなります。
因果探索だけで白紙から完璧な DAG を自動生成しようと期待すると火傷しそうですが、人がドメイン知識で描いた DAG の抜け漏れをチェックしたり、調整すべき変数の候補を絞り込んだりする補助線としては十分に実用的だと感じました。次は、未観測の交絡がある場合の FCI や、カーネル法を使った非線形の因果探索も試してみるつもりです。
More Information
- Pythonで始める因果推論入門
- causal-learn Documentation
- LiNGAM: Discovery of non-gaussian linear causal models
- DoWhy Documentation
- Spirtes, P., Glymour, C., & Scheines, R. (2000). Causation, Prediction, and Search (2nd ed.). MIT Press.
- Chickering, D. M. (2002). Optimal Structure Identification With Greedy Search. Journal of Machine Learning Research, 3, 507–554.
- Shimizu, S., et al. (2011). DirectLiNGAM: A Direct Method for Learning a Linear Non-Gaussian Structural Equation Model. Journal of Machine Learning Research, 12, 1225–1248.
- Maathuis, M. H., Kalisch, M., & Bühlmann, P. (2009). Estimating high-dimensional intervention effects from observational data. The Annals of Statistics, 37(6A), 3133–3164.
- Reisach, A. G., Seiler, C., & Weichwald, S. (2021). Beware of the Simulated DAG! Causal Discovery Benchmarks May Be Easy To Game. NeurIPS 2021.
関連記事

scikit-upliftで始めるアップリフトモデリング入門
データ駆動型の意思決定において、機械学習モデルは「どの顧客が商品を購入する可能性が高いか」という相関関係の予測に広く活用されています。しかし、マーケティング施策や介入の予算を真に最適化するためには、「我々の施策(介入)に […]
Harness Handbook: AIエージェント進化のための「振る舞い中心」のコード管理
現代のAIエージェントの能力は、基盤モデル単体の性能だけで決まるわけではありません。プロンプトの構築、状態の管理、そしてツールの呼び出しなどを統制する「ハーネス(Harness)」と呼ばれる実行基盤が重要な役割を担ってい […]

PyOD: Pythonによる異常検知入門
PyODは、異常検知のための非常に包括的なPythonライブラリで、LOF(Local Outlier Factor)やIsolation Forestといった古典的な手法から、最新の深層学習モデルまで、幅広い異常検知ア […]