Physical AI の最前線: デジタルとハードを繋ぐ次世代アーキテクチャ

工場の溶接ロボットは、部品の位置が数センチずれただけで止まってしまいます。if-then のルールで動く従来型のロボットは、想定外の状況に弱いことが長く課題とされてきました。一方で、LLM(Large Language Model: 大規模言語モデル)をはじめとする基盤モデルは、テキストや画像の世界で汎用的な能力を示しています。この能力を物理世界のロボットへ持ち込めないか、という問いが、いま Physical AI の中心的なテーマになっています。
こうした背景のもと、大規模な生成モデルを使ってロボットの行動・軌道・環境の予測を直接生成する枠組みは「Generative Physical AI(GPAI: 生成型フィジカルAI)」として体系化されています。GPAIでは、Robot Foundation Models(RFM)、Vision Language Action Models(VLA)、Large Behavior Models(LBM)、Diffusion Policy Models(DPM)、World Foundation Models(WFM)の5つに分類され、これらが互いにどのように補い合うかが整理されています。
この記事では、従来のロボット制御からの発展、GPAIを構成する要素、5つのモデル体系、産業応用、そして課題までを順に見ていきます。なお、記載している数値や評価は、各研究や実証実験の報告に基づくものです。
1. 従来ロボットからGPAIへ
3つの従来アーキテクチャと限界
従来のロボット制御は、Sense(知覚)・Plan(計画)・Act(行動)の関係性によって主に3種類に分けられます。
| アーキテクチャ | 構造 | 主な弱点 |
|---|---|---|
| Hierarchical(階層型) | Sense → Plan → Act を順に実行 | 応答が遅く、動的な環境に適応しにくい |
| Reactive(反応型) | 計画を省き Sense → Act を直結 | 高速だが推論能力に乏しい |
| Hybrid(ハイブリッド型) | 計画は独立に走らせ、Sense-Act は密結合のまま維持 | 計画部分の表現力に限界がある |
Hybrid型の構造と課題
Hybridは「計画しながら、目の前のタスクには反応的に対処する」構成です。しかし、自動車工場の組立ロボットが部品位置のずれや工具の摩耗に対応できなかった背景には、こうした if-then ベースの設計による表現力の限界があります。
計画をLLMに、知覚をVLMに置き換える
現在のGPAIは、Hybridアーキテクチャの発展形として位置づけられます。基盤モデルを活用することで、以下のように各機能を高度化します。
- 計画部分(LLM): 高度な推論と自然言語理解を提供します。
- 知覚部分(VLM: Vision-Language Model): 抽象的な推論を実世界の観測に結びつけます。
これらの基盤モデルを導入することにより、タスク、ロボットの形態、環境をまたいだ汎化性能の獲得が期待されています。
市場の期待と導入上の課題
市場予測
AIロボットの普及に関して、以下のような市場予測が立てられています。
- 2035年までにAI搭載ロボットが13億台展開される見込みです。
- ヒューマノイド市場は380億ドル規模に達すると予測されています。
- AIロボット市場全体は、2033年に1,780億ドル規模に達すると試算されています。
導入の実例
実例として、Amazonでは75万台超のAI駆動ロボットを導入しており、一部の物流センターで最大25%の効率向上が得られたと報告されています。
導入に向けた残された課題
一方で、実用化に向けては以下の課題が残されています。
- 安全認証の取得
- 規制の枠組みへの対応
- 導入コストの低減
- 現場労働力の適応
なお、市場予測は調査機関の推計であり、実現の確度については個別に評価する必要があります。
2. GPAIを構成する要素
Embodiment: 認知・知覚・行動・フィードバック
GPAIのEmbodiment(身体性を持つシステム)は、4つのサブシステムで構成されます。
- 認知(Cognition): 高レベルの推論と意思決定を担当します。
- 知覚(Perception): マルチモーダルな環境理解を担当します。
- 行動(Actuation): 決定事項を実際のモーター動作へと変換します。
- フィードバックループ: リアルタイムな環境適応を可能にします。
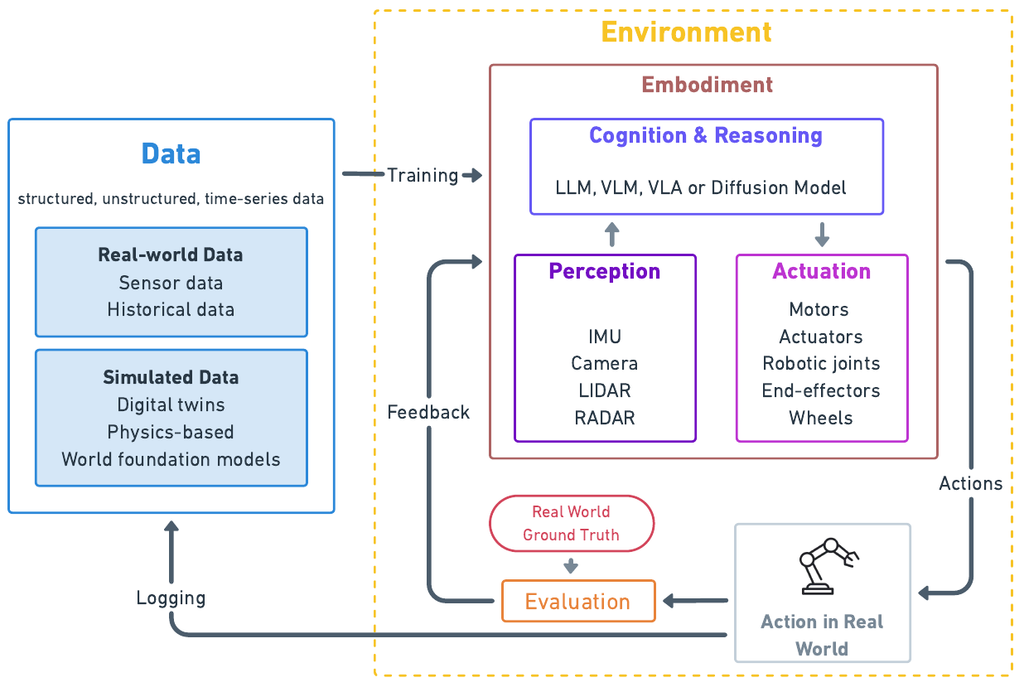
認知から行動への具体例
例えば「テーブル左側の赤いカップを取って」という指示が与えられた場合、次のように処理が進みます。
- 意図抽出とシーン解析: LLMが行動の意図・物体の記述・空間的な参照を抽出し、同時にVLMがシーンを解析して該当する物体を特定します。
- 把持力の決定: 物体の大きさや壊れやすさに応じて適切な把持力を選択します。
- 指令への落とし込み: 最終的なモーター指令まで変換します。
各サブシステム間の連携
- 行動側の制御:
- 計画された軌道は逆運動学ソルバーによって関節角度へと変換されます。
- 低レベルのコントローラーが、位置・速度・トルクの指令として各アクチュエータへ送信します。
- 知覚側からのフィードバック:
- カメラ、LiDAR、RADAR、IMUに加え、関節エンコーダーや指先の触覚センサーから情報が返されます。
- 壊れやすい物を持つ際は触覚センサーで把持力を調整し、視覚センサーで物体の動きや障害物を補正します。
データ基盤と学習パラダイム
2種類の実データと合成データ
学習に用いられるデータ基盤には、実世界データとシミュレーションデータがあります。
- 実世界データ:
- 内容: 人間のデモンストレーションや遠隔操作の軌跡など。
- 特徴: 現実世界のノイズや失敗事例を含みます。
- 課題: 人手、プライバシー、知的財産の制約があり、規模を拡大しにくい側面があります。
- シミュレーションデータ:
- 内容: 物理シミュレーター、Digital Twin(DT: デジタルツイン)、WFMが生成したデータ。
- 特徴: 極端な条件下での動作や稀なイベントのデータを、安全かつ大量に生成できます。
学習パラダイムの整理
学習手法ごとの特徴と限界は以下のとおり整理されます。
| 手法 | 得意なこと | 限界 |
|---|---|---|
| RL(強化学習) | 試行錯誤で操作・移動・組立を獲得。PPO、SACが連続制御で安定 | 試行の負担が大きい |
| 教師あり学習 | 専門家のデモから明確なスキルを獲得 | 未経験の状況に弱く、タスクごとに注釈が必要 |
| 教師なし学習 | 物体や空間の構造、世界モデルの獲得 | 明示的な目標がない |
| 自己教師あり学習 | 未来の感覚状態の予測などで表現を学習し、生涯学習に向く | 相互作用データの量に依存 |
人間フィードバックの課題とAIによる代替
人間のフィードバックを用いるRLHF(Reinforcement Learning from Human Feedback)は、バイアスの増幅や評価者間のばらつきを招く恐れがあります。その代替策として、補助モデルが好みの比較を自動生成するRLAIF(Reinforcement Learning from AI Feedback)が注目されています。
ベンチマークと、その限界
主要な標準評価基盤
代表的な標準評価基盤として、以下の3つが挙げられます。
- LIBERO: 130種類のタスクを備え、生涯学習の能力を評価します。
- RLBench: 100種類の視覚誘導型マニピュレーションタスクを提供します。
- Open X-Embodiment: 22種類のロボットにまたがる100万件超の軌跡データを収録しています。
評価における注意点
ベンチマークの活用には以下の注意点や限界が存在します。
- 実世界での頑健性との乖離: ベンチマーク上の指標と実世界における頑健性の相関は弱いことが報告されています。統制された環境での成功率が高くても、実環境の汎化に失敗する例が見られます。
- 安全指標の不足: 失敗予測の精度や人間との安全マージンといった安全面に関する指標は、まだ十分に評価されていません。
3. 5つのモデル体系
機能で整理した全体像
GPAIを構成するモデル群は、機能面から主に3つのグループに分類されます。
- Generative Control Models: 感覚入力と制御指令を直接結びつけます(VLA、RFM、LBM)。
- Generative Action Policy Models: 実行可能な軌道を生成・洗練します(DPM)。
- Generative Data Models: 学習や評価用のデータを合成します(WFM)。
実用的なシステムでは、これら3つのグループを組み合わせることで頑健な動作を実現します。
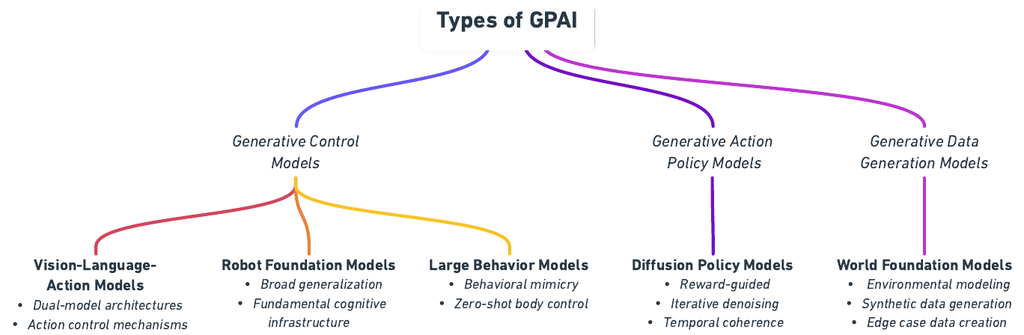
Robot Foundation Models(RFM)
アーキテクチャの特徴
RFMは、多様なロボットから収集した「状態と行動のペア」で学習する汎用モデルです。
- 専用エンコーダー:
- 行動: 時間畳み込み
- テキスト: BERT系やGPT系
- 視覚: ViTやCNN
- センサー: 専用エンコーダー
- 処理の流れ:
- 各入力を融合モジュールで1つのトークン列にまとめます。
- Transformer層で相互注意(Cross-Attention)を計算します。
- アクションデコーダーが最終的な制御指令を出力します。
自動運転車からマニピュレーター、ヒューマノイドまで、単一のモデルで対応することを目指しています。
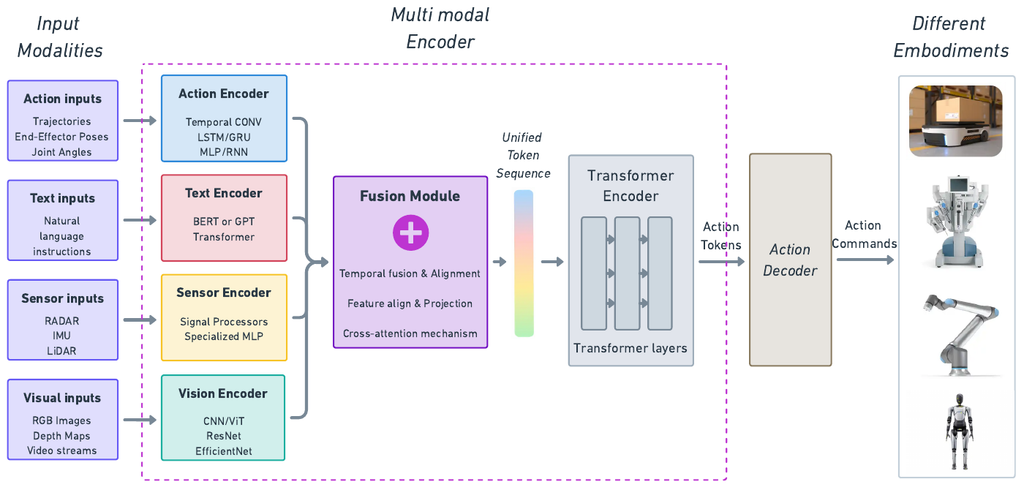
タスク特化型と汎用型の比較
- タスク特化型(例: GraspClutter6D):
- 乱雑な環境での把持など特定タスクに特化しています。
- 計算資源が少なく済み、制約下で高い精度を発揮します。
- ただし、新しいタスクには再学習が必要です。
- 汎用型:
- 幅広いタスクへの適応力が高い利点があります。
- 一方で、大規模なデータと膨大な計算資源を要求します。
汎用型の代表例
- PaLM-E:
- 事前学習済みLLMの埋め込み空間に画像やロボット状態を取り込む、言語中心の設計です。
- 出力は自然言語によるステップ計画であり、実行には外部の解釈機構を必要とします。
- Gato:
- あらゆる入出力を共通の語彙にトークン化し、単一のTransformerで処理します。
- 数百のタスクを同時に学習し、対話、画像キャプション生成、ロボット制御を1つのネットワーク内で切り替えて実行できます。
Vision Language Action Models(VLA)
アーキテクチャとRFMとの相違点
VLAは、視覚・言語・行動生成を1つの枠組みに統合したモデルです。
- 二重構造: VLMによるマルチモーダル推論と、Transformerデコーダーや拡散ポリシーによる行動生成を統合しています。
- 内部処理: 画像はViT、指示文はUSE(Universal Sentence Encoder)、ロボット状態は状態エンコーダーで埋め込み、共有空間へ射影して中核のLLMに入力します。出力は行動トークンとなります。
- RFMとの大きな違い: アクションデコーダーを後付けせず、視覚・言語と共に行動生成をエンドツーエンドで学習します。制御目的の勾配がモデル全体に流れるため、視覚エンコーダーからデコーダーまでが制御タスクに合わせて共適応します。
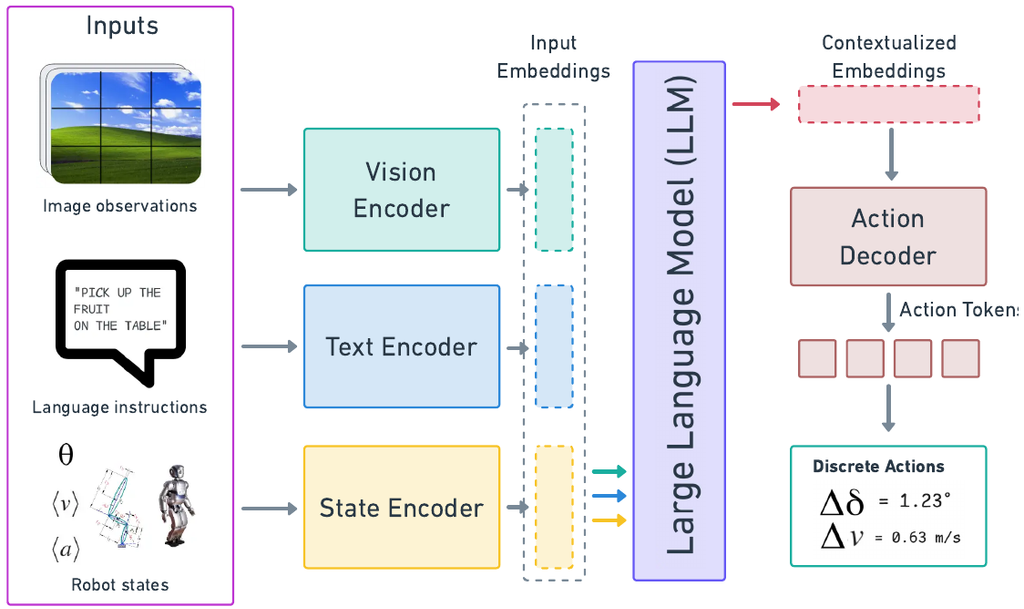
代表的なモデル
| モデル | 特徴 | 報告された数値 |
|---|---|---|
| RT-1 | 35Mパラメータ。TokenLearnerで視覚トークンを81から8に圧縮。行動は11次元を各256ビンに離散化 | 700超のタスクで成功率67% |
| RT-2 | 行動を言語のようなトークンとして扱い、ウェブ規模データとのco-fine-tuningを実施。55Bパラメータまで拡大 | 未知タスクで成功率62%(RT-1は32%) |
| OpenVLA | オープンソース。Llama 2と2種の視覚エンコーダー(DINOv2・SigLIP)を統合 | 29ベンチマークでRT-2-Xを上回る、パラメータは7分の1 |
| Gemini Robotics VLA | Gemini 2.0とALOHAで、同期した両腕操作に重点 | 高精度な両腕協調 |
OpenVLAが手軽さとパラメータ効率を追求しているのに対し、Gemini Roboticsは高精度な制御を重視しているという設計思想の違いがあります。
Large Behavior Models(LBM)
特徴と学習の仕組み
LBMは、人間らしい身体動作を学習・再現・生成するためのモデルです。
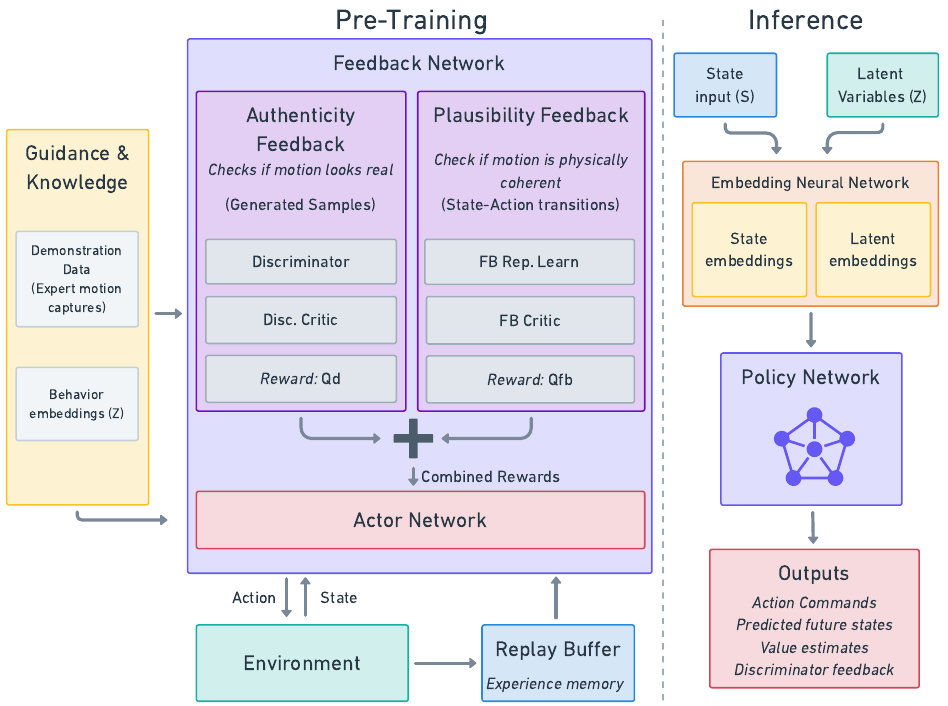
- 事前学習: モーションキャプチャなどの専門家デモと行動埋め込みがActorネットワークを訓練します。
- Feedback Network: 以下の2種類の報酬信号を与えます。
- Authenticity フィードバック: 動きが本物らしいかを判別します。
- Plausibility フィードバック: 状態遷移が物理的に整合しているかを評価します。
- 推論: 経験はReplay Bufferに蓄積され、推論時は状態と潜在変数を埋め込んでPolicy Networkが行動指令を出力します。
代表例: Meta Motivo
Meta Motivoは、FBCPRアルゴリズムに基づき、タスク固有の学習を行うことなく人型の全身制御をゼロショットで実行します。内部は以下の5つのネットワークで構成されます。
- Forward: 現在の状態・行動・潜在変数から次の状態を予測します。
- Actor: 行動をガウス分布の平均として出力し、滑らかな動きを生成します。
- Critic: 状態・行動・潜在変数の組み合わせを評価します。
- Backward: 状態を潜在表現に写像します。
- Discriminator: ラベルなしモーションデータと比較し、生物学的な妥当性を担保します。
なお、LBMはシミュレーション環境での高い能力に比べ、実世界での検証は基本的な歩行動作などにとどまっているのが現状です。
Diffusion Policy Models(DPM)
動作原理と Receding-Horizon 制御
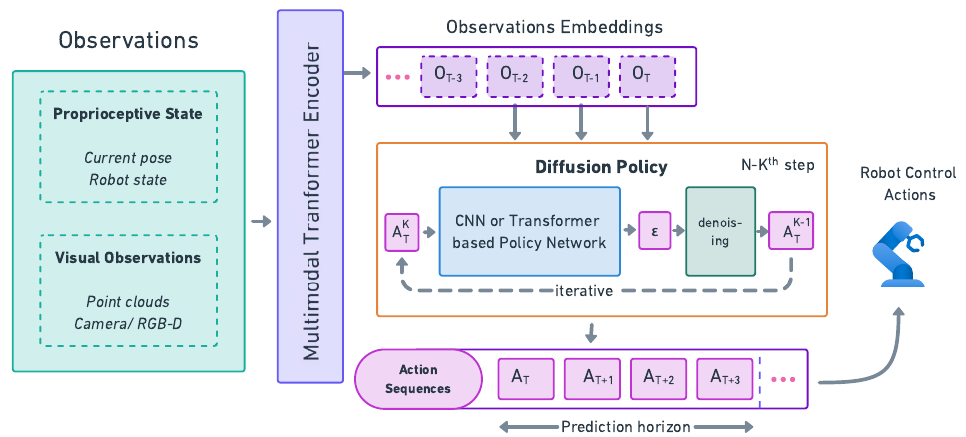
DPMは、ガウスノイズから開始して反復的にノイズを除去し、高次元の行動列を生成するモデルです。
- ノイズ除去プロセス: 観測情報(ロボットの姿勢、点群、RGB-D映像)をTransformerエンコーダーで埋め込み、CNNやTransformerベースのネットワークが各ステップでノイズを予測して行動列を洗練します。生成される行動列は、4〜8ステップ先までの時間的な一貫性を保ちます。
- Receding-Horizon(後退ホライズン)制御: 予測した長い行動列のうち最初の数ステップのみを実行し、頻繁に計画をやり直します。これにより、誤差の蓄積を抑え、動的な環境変化へ柔軟に適応できます。
従来の行動模倣に対する優位性
- Mode Collapse の回避: 従来の決定論的ネットワークでは、複数のデモを平均化してしまい無効な行動を出力することがありました。拡散ポリシーは複数の有効な解を表現できるため、LSTM-GMMやIBCで発生していたMode Collapseを回避できます。
- 性能の向上: 4つのベンチマーク群にわたる12タスクの評価において、成功率が平均47%向上したと報告されています。
近年の発展と計算上の弱点
- 近年の発展:
- DP3: 点群データを活用する3D Diffusion Policy。
- DPPO: 強化学習(RL)との統合による安定した微調整。
- VLAとの統合(Octo): 拡散ポリシーをVLAのアクションデコーダーとして組み込んだ事例では、80%超の成功率を達成し、素朴な実装(40%未満)を大きく上回っています。
- 遅延に関する弱点: 反復的なノイズ除去は制御1回につき複数回の順伝播を必要とします。そのため、50ms未満の応答が求められる素早い操作においてレイテンシが衝突しうると指摘されています。
World Foundation Models(WFM)
定義と役割
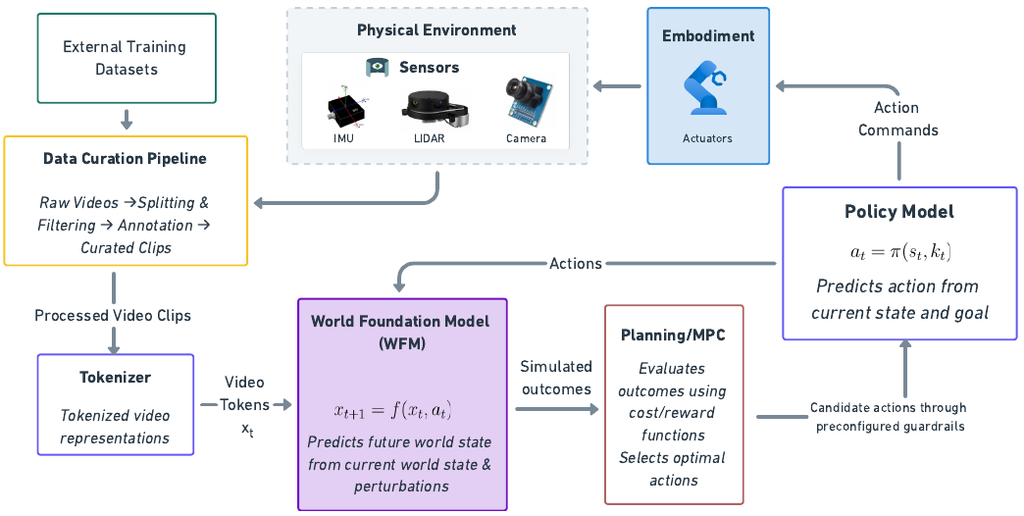
WFMは、環境の力学を学習した予測モデルです。現在の状態と候補となる行動から、未来の画像・映像・潜在表現をシミュレートします。実機を動かす前に反事実的な評価(「もしこう動いたら世界はどう変わるか」)ができるため、計画、検証、合成データ生成に幅広く活用されます。
数式モデルとロールアウト
観測 \(s_t\) をエンコードした潜在表現を \(x_t = \mathrm{enc}(s_t)\) と表すと、1ステップ先の予測は次の式で示されます。
$$x_{t+1} = f(x_t, a_t)$$
ここで \(a_t\) は時刻 \(t\) の行動、\(f\) は学習された世界モデルです。さらに行動列 \(a_{t:t+H-1}\) を与えたときの \(H\) ステップ先までの予測(ロールアウト)は次のとおりです。
$$x_{t+1:t+H} = f(x_t, a_{t:t+H-1})$$
実機を動かさずに試行できる一方、予測誤差はホライズンが長くなるほど累積します。そのため、短いロールアウトの生成と頻繁な再計画を組み合わせて使う運用が実用的です。
制御への応用とDigital Twinとの連携
- 制御への適用: プランナーやMPC(Model Predictive Control)が候補行動列を提示し、WFMが各候補のロールアウトを生成します。コスト・報酬関数および安全制約に基づいて評価し、最良の列の最初の行動のみを実行します。
- 計画コストの低減策: 実行時の計画コストを減らすため、プランナーの選択を方策に蒸留する手法や、WFMのロールアウトを用いるモデルベース強化学習、Digital Twin(DT)とのキャリブレーションループも活用されます。
- Digital Twinとの補完関係:
- DTは解釈しやすく物理制約に強い特徴を持ちます。
- WFMは解析的に扱いにくい複雑な力学や観測の統計的性質を学習できます。
- 両者を組み合わせ、支配方程式や保存則を損失関数や潜在空間に埋め込むPhysics-Informed Machine Learningの流れも進んでいます。ただし、WFMを用いても予測の不確実性そのものが完全に消えるわけではありません。
実装例: NVIDIA Cosmos
NVIDIA Cosmosは以下の3つの要素で構成されています。
- Cosmos Predict: 未来の世界状態を映像として生成します。
- Cosmos Transfer: LiDARや深度マップなどの構造化入力を写実的なシーンへと変換します。
- Cosmos Reason: シナリオの分析や注釈を支援する推論型VLMです。
評価軸と主要ベンチマーク
WFMは「生成品質」「制御可能性」「物理的な妥当性」「下流タスクでの有用性」の4軸で評価されます。
| ベンチマーク | 規模 | 特徴 |
|---|---|---|
| WorldScore | 3,000の次シーン予測シナリオ | 制御可能性・品質・動力学を統一的に評価 |
| WorldModelBench | 350の画像・テキスト条件ペア、67Kの人手ラベル、14モデルを評価 | 指示追従と物理法則の遵守を測定。質量保存に反するサイズ変化などを検出 |
| WorldSimBench | 3万5,000超の注釈タプル | 知覚品質を見る明示的評価と、映像から行動への変換で有用性を見る暗黙的評価の2部構成 |
5つのモデルの役割分担と収束の見通し
各モデルの役割分担
RFMとVLAは知覚から行動までの広い範囲をカバーして汎化を支える一方、WFMは予測シミュレーションとデータ生成、LBMは人間らしい動作、DPMは頑健な低レベル制御に特化しています。
| モデル | 中核機能 | 代表例 | 主な適用先 |
|---|---|---|---|
| RFM | 汎化・計画 | PaLM-E、Gato | 汎用ロボットの計画・制御 |
| VLA | マルチモーダルな知覚と行動 | RT-1、RT-2、OpenVLA | マニピュレーター、移動ロボット |
| LBM | 人間らしい行動 | Meta Motivo | 人との協働、ソーシャルロボット |
| DPM | 生成的な行動制御 | Diffusion Policy | マニピュレーション |
| WFM | 世界のシミュレーション・予測 | NVIDIA Cosmos | 学習・評価用のデータ生成 |
将来の統合トレンド
現状では汎用性と特化のトレードオフが存在しますが、今後はDPMの高精度な制御力やLBMの身体動作といった特化モデルの強みが、RFMやVLAなどの大規模汎用モデルへ統合されていく見通しが示されています。
4. 応用事例
主要な産業・研究分野における実例
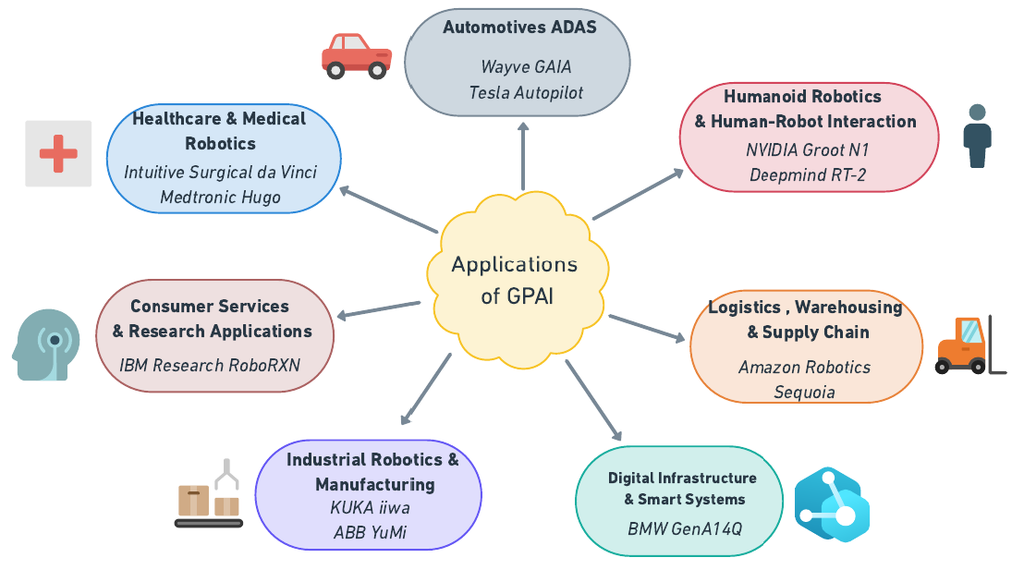
Physical AIはすでに多くの領域で導入や検証が進められています。報告されている主要な事例と数値は以下のとおりです。
| 領域 | 事例 | 報告されている内容 |
|---|---|---|
| 自動運転・ADAS | Wayve GAIA-1/2、Tesla Autopilot、NVIDIA DRIVE | GAIAは世界モデルで危険な稀少イベントを合成。Teslaは車両群のデータを再学習に回し、無線更新で全体に反映。DRIVEが低遅延な実行基盤を提供 |
| 産業・製造 | ABB YuMi、KUKA iiwa、RNB Cosméticos | ABBは50万台超の産業ロボットを展開。RNBはUR10を6台使い、7kgの荷を毎分6個、350超の製品バリエーションで柵なしにパレタイズ |
| 医療 | da Vinci、Hugo、Cyberdyne HAL | da Vinciは1,400万件超の低侵襲手術を支援。Hugoは承認試験で手術成功率98.5%(基準は85%)。HALは2分間歩行で10%長く歩けるように改善 |
| ヒューマノイド・HRI | NVIDIA GR00T N1、Atlas、Digit、Optimus、RT-2 | GR00T N1は2.2Bパラメータ、VLMが10Hz、Diffusion Transformerが120Hzで動作し推論時間は64ms。Atlasは1動作あたり1.5億回のシミュレーションで学習 |
| 物流 | Amazon Robotics、Walmart | Amazonは75万台超のロボットを導入し、Sequoiaで生産性が約25%向上。Walmartは3,000万マイルの無駄な走行と9,400万ポンドのCO2排出を削減 |
| デジタルインフラ | BMW Virtual Factory | 30拠点超のデジタルツインで、生産計画コストを最大30%削減する見込み。レーゲンスブルク工場では57秒に1台生産される車両の品質検査にGenAI4Qを導入 |
| 消費者・研究 | 家庭用ロボット、IBM RoboRXN | RoboRXNは化合物の開発サイクルを数週間から数時間に短縮 |
ヒューマノイドにおける二重システム構成
ヒューマノイドの領域では、GR00T N1にみられる二重システム構成が注目されます。
- 低周波数の推論(10Hz): VLMが周囲の状況を把握し、じっくり推論を行います。
- 高周波数の制御(120Hz): 拡散ポリシーヘッド(Diffusion Transformer)が素早く滑らかな動作指令を出力します。
周波数の異なる2つのシステムを連携させることで、高度な推論と即応性の高い動作の両立を図っています。
事例数値の解釈に関する留意点
こうした数値の多くは各企業の公表値や事例紹介に基づいており、完全な実運用での検証はまだ限られているのが現状です。各数値がどのような条件下で得られたものであるかは、個別に確認する必要があります。
5. 課題とトレードオフ
9つの主要課題と緩和策
Physical AIの実装には9つの課題が存在し、それぞれに対してリスクと対策が検討されています。
| 課題 | 内容 | 主な対策 |
|---|---|---|
| データ不足 | 物理的に裏づけられた大規模データの収集が高コスト | 自己教師あり学習、合成データ、シミュレーションからの転移 |
| バイアス・倫理 | 偏ったデータが差別的・危険な行動を招く。EU AI Actなどの規制対応も必要 | ガバナンス、バイアス検出と緩和 |
| ハードウェア・リアルタイム制約 | 生成モデルの計算負荷とエッジの制約が衝突 | 量子化・枝刈り・蒸留、エッジとクラウドの併用 |
| Sim-to-Real | 摩擦・接触・センサーノイズなどがシミュレーションで再現しきれない | ドメインランダマイゼーション、微分可能シミュレーター |
| 汎化・推論 | 物体の関係や長期的な帰結を誤解する。プロンプトのわずかな違いに敏感 | 推論モデルの強化、メタ学習・継続学習 |
| 拡張性・複雑性 | 知覚・推論・計画・制御の統合が難しく、1層の失敗が全体に波及 | モジュール型・階層型設計 |
| 安全性・頑健性 | 物理世界ではほぼ完璧な信頼性が必要 | 厳格な安全評価、監視、フェイルセーフ |
| 透明性・説明可能性 | ブラックボックスで監査や誤り診断が難しい | 説明可能AI |
| エネルギー効率 | 大規模学習の電力消費と炭素排出 | 効率的なアルゴリズム、グリーンコンピューティング |
各モデル固有の弱点
各モデル体系には、以下のような特有の弱点も存在します。
- VLA:
- 大きな視覚言語バックボーンが、組み込み機器での高速な反応制御を難しくします。
- 行動を256ビンに離散化する設計は学習しやすい反面、制御の分解能が下がり、精密な作業で動きの不連続を生じさせます。
- DPM:
- 反復的なノイズ除去処理が、50ms未満の応答が必要な素早い操作と衝突します。
- RFM:
- ロボットごとにアクチュエータの特性や関節の可動域が異なる「embodiment mismatch」があり、新しいロボットで予測しにくい挙動を引き起こします。
- 新しい領域への継続的な微調整において、破滅的忘却(catastrophic forgetting)も発生します。
- LBM:
- シミュレーション上で高い能力を示しても、モデル化されていない接触や機構の不完全さにより、現実世界では性能が低下します。
安全性の形式的保証と認証の課題
物理世界での運用において、安全性の確保には以下の技術的・制度的課題があります。
- 形式的保証の難しさ: 確率的な方策に対する形式的な安定性や安全性の保証が不足しています。Control Barrier Function(CBF)に基づくフィルタを用いて各行動ステップに状態空間の制約を課す手法がありますが、基盤モデルの高次元かつ確率的な出力と組み合わせる方法は未解決の課題です。
- 評価・認証枠組みの不足: 既存の評価・認証の枠組みは、接触力の上限、失敗からの復旧時間、エネルギー制約下での実行といった運用上の安全要件を十分に捉えきれていません。
おわりに
Physical AIは、RFM、VLA、LBM、DPM、WFMの5つに体系化され、汎用モデルが知覚から行動までを担いつつ、特化型モデルが制御、動作、データ生成を補完する構図が明確になってきています。その応用分野も、自動運転や製造、医療、ヒューマノイド、物流まで多岐にわたる領域で具体的な成果が示され始めています。
実務への導入を検討する上では、各モデルの得手不得手を把握した使い分けが不可欠です。素早い低レベル制御には拡散ポリシー(DPM)、自然言語による指示追従にはVLA、学習データの拡充や安全検証のためのシナリオ生成には世界基盤モデル(WFM)といったように、役割に応じた組み合わせが求められます。一方で、エッジ環境におけるレイテンシ、シミュレーションと現実のギャップ(Sim-to-Real)、そして確率的出力に対する形式的な安全保証の欠如といった制約は、実際の現場導入に先立って慎重に検討すべき事項です。
今後の展開としては、データ効率の高い学習手法の確立、異なるエンボディメントをまたぐモジュール型の基盤モデル、エッジ向けの計算効率向上、そして実運用に即した安全プロトコルやガバナンスの整備が重要な論点となります。なお、本記事で取り上げた各種の性能数値は公表値や実験報告に基づくものですので、実際の採用判断にあたっては前提となる動作条件を十分に確認することが推奨されます。
More Information
- arXiv:2609.18111, Satyam Gaba et al., 「A Comprehensive Review of Generative Physical Artificial Intelligence」, https://arxiv.org/abs/2609.18111
関連記事
データエージェントの自律性レベルとロードマップ
「データエージェント」という言葉、最近よく耳にしますよね。ですが、単にSQLを回答するだけのチャットボットから、複雑な分析ワークフローを自律的に回す高度なシステムまで、その定義は非常に曖昧です。この曖昧さは、開発者とユー […]

Nested Learning: Deep Learning の新たなパラダイム
ChatGPTやGeminiをはじめとする大規模言語モデル(LLM)は、人間が書いたかのような自然な文章を生成し、複雑な質問にも答えるなど、驚異的な能力を見せています。しかし、その万能に見える能力の裏で、根本的な問題を抱 […]

プロンプトエンジニアリングの限界-コンテキストエンジニアリングとは?
近年、AIのビジネス活用が急速に進み、特に大規模言語モデル(LLM)は、その多様な能力で企業の業務効率化や新たな価値創造に貢献しています。AIの性能を最大限に引き出すための技術として、これまでプロンプトエンジニアリング、 […]