DiffusionGemma: 拡散言語モデルの仕組み
大規模言語モデル(LLM)をチャットボットや対話型エージェントとして、単発かつ低同時接続で動かす場面では、生成速度が伸びずにもどかしさを感じることがあります。この種のワークロードでは、モデルの重みや会話履歴のキャッシュをメモリからアクセラレータへ転送する時間が計算時間を上回り、GPUの計算資源を持て余したまま応答を待つ「メモリバウンド」の状態に陥りやすいためです。この問題を緩和する手段として投機的デコード(Speculative Decoding)が広く使われていますが、小さなドラフトモデルが提案した候補列を本体モデルが検証する仕組みの都合上、1回の推論あたりに生成できるトークン数には現実的な上限が存在します。
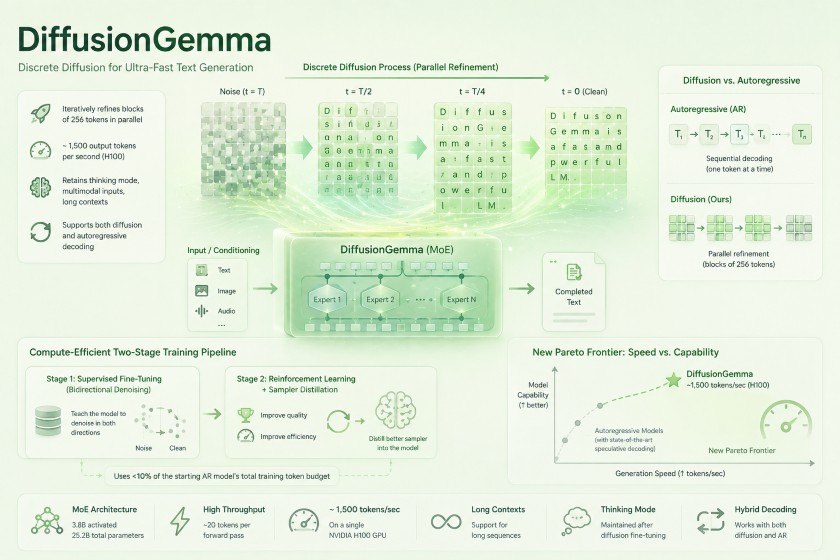
こうした状況に対し、Google DeepMind が「DiffusionGemma」というモデルを発表しました。本モデルは、トークンを1つずつ逐次的に生成する自己回帰(AR: Autoregressive)方式ではなく、離散拡散(Discrete Diffusion)と呼ばれる仕組みで文章のまとまりを並列に生成します。DiffusionGemmaは、公開済みの Gemma 4 26B A4B(Mixture-of-Experts構成、活性化パラメータ3.85B)をゼロから拡散モデルとして事前学習し直すのではなく、既存の重みを起点にファインチューニングすることで構築されています。1回の推論あたり平均20トークン、NVIDIA H100 1枚でおよそ秒間1,500トークンという生成速度が達成されたと報告されています。非公開APIの拡散モデルに匹敵する応答品質を保ちながらオープンウェイトで公開されている点も特徴であり、速度・知能・アクセス可能性のすべてを同時に満たす初めてのテキスト拡散モデルと位置づけられています。
今回は、自己回帰モデルの生成が遅くなる根本的な理由から出発し、DiffusionGemma が採用する離散拡散の仕組みとアーキテクチャ、教師ありファインチューニング(SFT)とサンプラー蒸留・強化学習を組み合わせた2段階の学習パイプラインを解説します。さらに、GPUレベルでの推論最適化、ベンチマークで示された性能と速度のトレードオフ、拡散モデルならではの実用上の利点や現時点での限界まで、順を追って詳しく見ていきます。
1. なぜ自己回帰モデルの生成は遅いのか
自己回帰モデルにおける生成速度のボトルネックと、従来の打開策である投機的デコードの限界、そしてテキスト拡散モデルが提案された背景について解説します。
1.1 自己回帰モデルにおける「メモリバウンド」の課題
- 逐次生成の仕組み: 自己回帰モデルは、直前までのトークン列を条件として次の1トークンを予測する処理を末尾まで繰り返すことで文章を生成します。
- 実行効率の弱点: この方式は理論的には厳密ですが、ハードウェア上での実行効率という観点では大きな弱点を抱えています。
- ワークロードによる違い:
- バッチ推論: 多数のリクエストを同時に処理する場合は、複数リクエスト分の計算をまとめて実行できるため十分なススループットを確保できます。
- 単発・低同時接続推論: モデルの重みと会話履歴のKey-Value(KV)キャッシュをメモリからアクセラレータへ転送する時間が、実際の計算時間を大きく上回ってしまいます。
- 発生する現象: GPUの計算ユニットが遊んだ状態のまま次のトークンを待つことになり、1ユーザーあたりの生成速度が頭打ちになる「メモリバウンド」の状態に陥ります。
1.2 投機的デコードとその限界
- 投機的デコードの仕組み: メモリバウンドを緩和する代表的な手法であり、軽量な「ドラフトモデル」が数トークン先(典型的には8トークン程度)を先回りして生成し、本体モデルがそれをまとめて検証・採択することで1回のフォワードパスあたりの生成トークン数(TPF: Tokens Per Forward)を底上げします。
- 実効速度のボトルネック:
- ドラフト長を8とした場合でも、実際に得られるTPFはおおむね3〜6程度にとどまります。
- ドラフトモデル自体も自己回帰的に動くため、逐次生成のボトルネックを完全には免れません。
- 複数候補を並列に提案するドラフトモデルを使用しても、ドラフトの後半になるほど本体モデルによる採択率が低下してしまいます。
1.3 テキスト拡散モデルという新たな発想転換
- 発想の転換: 上記の限界を踏まえ、文章のブロックそのものを並列に予測する「テキスト拡散」という方式が提案されています。これはハードウェアの実行特性を「メモリバウンド」から「計算バウンド」の領域へ意図的にシフトさせる狙いを持っています。
- 従来モデルの課題:
- 非公開APIモデル: Gemini Diffusion や Mercury のように高速な拡散モデルは存在していましたが、非公開APIとしてのみ提供されていました。
- 既存オープンウェイトモデル: LLaDAなどのオープンウェイトな拡散モデルは、推論・マルチモーダル理解の能力が限定的であったり、拡散技術本来の低レイテンシを十分に引き出せていなかったりする状況にありました。
- DiffusionGemmaの位置づけ: 高い知能・極めて高い速度・オープンなアクセス可能性の3つを同時に満たすテキスト拡散モデルが存在しなかったという課題認識のもと、DiffusionGemmaが提案されました。
2. DiffusionGemmaの全体像
既存の学習済み重みを活用するファインチューニング手法や2段階の学習パイプライン、継承された主要機能とオープンエコシステムにおける展開について概要を説明します。
2.1 ベースモデルの構成とファインチューニングアプローチ
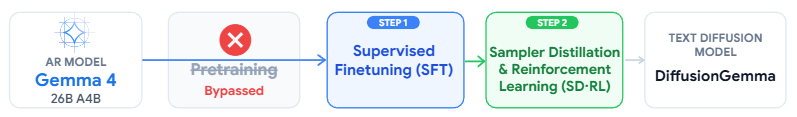
- 転換手法: 拡散モデルをゼロから事前学習するのではなく、既に公開・事後学習済みの「Gemma 4 26B A4B」の重みを起点とし、ファインチューニングのみで拡散モデルへと転換しています。
- ベースモデル(Gemma 4 26B A4B)の基本スペック:
- 総パラメータ数: 25.2B
- 活性化パラメータ数: 3.85B
- アーキテクチャ: Mixture-of-Experts(MoE: 複数の専門家ネットワークのうち一部を動的に選択して使用する構成)
- 語彙サイズ: 262,000
- 専門家の動員: 128個の専門家のうち8個と、共有専門家1個を1トークンごとに活性化。
- 推論への影響: この「1トークンあたり8専門家」という構成は、拡散モデルが1ステップでまとめて多くの専門家を動員する理由として推論速度の分析に関わってきます。
2.2 効率的な2段階の学習パイプライン
DiffusionGemmaの学習は、以下の2段階のパイプラインで構成されています。
- 教師あり微調整(SFT): ノイズが加えられた256トークンのブロックを、双方向アテンションにより一括で Denoisingできるようモデルを適応させます。
- オンライン学習(SD・RL): サンプラー蒸留と強化学習を組み合わせ、生成品質の向上とDenoisingステップ数の圧縮を同時に進めます。
- 学習コストの削減: これら2段階を合わせた学習トークン量は、元のAR版Gemma 4の学習トークン予算の10%未満に収まっています。ゼロから事前学習する場合と比較して、計算コストを大幅に抑制した設計です。
2.3 継承された機能とオープンエコシステムでの展開
- 継承された主要機能:
- 長文脈対応
- マルチモーダル理解
- thinkingモード(応答前に推論トレースを生成する機能)
- AR方式サンプリング能力: 拡散用に転換した後も、AR方式でそのままサンプリングできる能力を保持しています。
- 公開状況とコミュニティの反応:
- ライセンス: Apache 2.0ライセンスの下でオープンウェイトとして公開。
- 参照実装: HuggingFace Transformers および vLLM の双方に提供。
- ドメイン適応事例: 公開からわずか数週間の時点で、多言語音声認識や放射線科レポートの作成支援といった専門領域へのファインチューニング事例が登場しています。計算コストの低さが迅速なドメイン適応を強力に後押ししています。
3. 離散拡散とブロック単位の生成プロセス
DiffusionGemmaが採用している離散拡散の数学的なアイデア、因果的エンコーダと双方向デコーダによるネットワーク構成、およびエントロピーに基づいた動的サンプラーの仕組みを解説します。
3.1 離散拡散の基本アイデア
- 拡散モデルの基本概念: 画像生成の領域で発展してきた手法であり、完全なノイズから出発して少しずつ本物らしいデータへ近づけていく反復的な生成過程を特徴とします。
- 従来のテキスト拡散の課題:
- トークンは画像ピクセルのような連続量ではなく離散的な記号です。
- 初期手法ではトークンを一旦連続的な埋め込み空間へ写像し、ガウス分布的なノイズ処理後に最も近い語彙トークンへ丸め込むアプローチが取られていました。
- しかし、有効な語彙領域は高次元の埋め込み空間全体のごく一部であるため生成過程が領域外へ迷い込みやすく、丸め込んだ結果が無関係なトークンになって文章が破綻する課題がありました。
- 離散拡散による解決策: 埋め込み空間を経由せず、離散的な状態そのものの上でノイズ付加と復元を実施することで上記の問題を回避しています。
定式化
長さ\(C\)のトークン列(キャンバス)に対し、時刻\(t\)が\(0\)から\(1\)に進むにつれて各トークンが確率的にランダムな語彙トークンへ置き換わる前向き過程を定義します。
$$\mathbb{P}(X_t = x_t \mid X_0 = x_0) = \prod_{i=1}^{C} \left[ \kappa_t\, \delta(x_t^i, x_0^i) + (1 – \kappa_t) \frac{1}{V} \right]$$
- \(V\): 語彙数
- \(\delta\): 2つの値が一致するときに\(1\)、それ以外は\(0\)を取るクロネッカーのデルタ
- \(\kappa_t\): \(1\)から\(0\)へ単調減少するノイズスケジュール
- \(\kappa_t\)が\(1\)に近い(\(t\)が\(0\)に近い)ほど、元のトークン\(x_0^i\)が保たれる確率が高くなります。
- \(\kappa_t\)が\(0\)に近づく(\(t\)が\(1\)に近づく)ほど、語彙から一様ランダムに選ばれたトークンに置き換わる確率が高くなります。
生成過程と収束の例
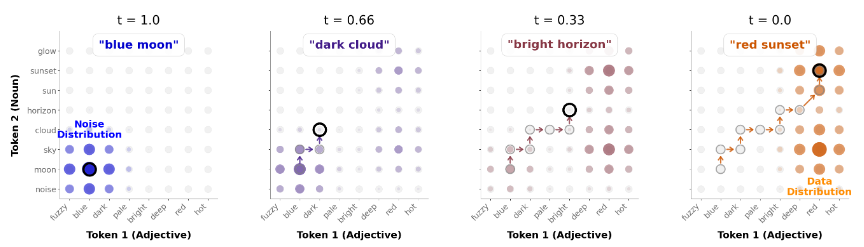
生成時にはこの前向き過程を逆にたどります。ニューラルネットワークがノイズの乗った状態\(x_t\)から元のクリーンなトークンの確率分布を予測し、ノイズをわずかに取り除く更新を1ステップずつ繰り返します。
- 形容詞と名詞の組み合わせ例:
- 時刻1.0: 「blue moon」(無関係な語の組み合わせ)
- 時刻0.66: 「dark cloud」(中間状態)
- 時刻0.0: 「red sunset」(意味の通った組み合わせへ収束)
- 並列更新: キャンバス内の複数の位置が、左から右への順序に縛られることなく同時並行的に確率分布を更新します。
3.2 アーキテクチャ: 因果的エンコーダと双方向デコーダ
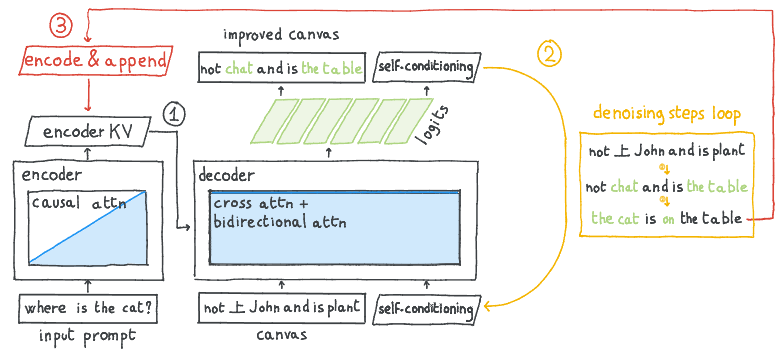
- ネットワーク構造: 重みを共有するエンコーダ・デコーダ型Transformerとして構成されています。
- 因果的エンコーダ: プロンプトや確定済みの過去のブロックといった文脈をKey-Value(KV)キャッシュへ変換します。
- 双方向デコーダ: 現在Denoising中のブロックに対し、KVキャッシュにクロスアテンションしながら並列に更新します。
- 従来モデルとの比較: BARTやT5のような従来のエンコーダ・デコーダモデル(双方向エンコーダ+因果的デコーダ)と比べて、双方向性と因果性の役割が入れ替わった特徴的な構成です。
- ブロック自己回帰(block-AR):
- 文章全体は256トークンの固定長ブロックを単位として生成されます。
- ブロックごとに完全にDenoisingしてKVキャッシュへ追記し、次のブロックへ進みます。
- ブロック間では従来の逐次的な依存関係が残る一方、1ブロック内の256トークンは並列にDenoisingされるという2階層の生成構造を持ちます。
- 自己条件付け(self-conditioning)信号:
- 直前のステップで予測されたクリーントークンの確率分布を、埋め込み行列と小さなフィードフォワード層に通して次のステップの入力へ足し戻します。
- これにより、モデルは直前の自分自身の予測を参照しながら段階的に予測を精緻化できます。
- multinomial diffusion(多項分布拡散)の採用:
- 一部のトークンをマスクして固定するmasked diffusionとは異なり、同一ブロック内であれば一度確定したトークンも後続のステップで別のトークンへ置き換わり得る柔軟性を持ちます。
- この性質が、ブロック内で発生した誤りを後のステップで訂正できる「自己修正能力」の土台となります。
- ※一度確定してKVキャッシュに追記された過去ブロックのトークンは書き換えられません
3.3 サンプラー: エントロピーに基づく適応的な打ち切り
- 動的なステップ数決定: 対象論文が提案するエントロピー制約付きサンプラーによってDenoisingステップ数が動的に決定されます。
- 適応的停止(Adaptive Stopping)の発生条件:
- 各ステップで計算されるキャンバス全体の平均予測エントロピー(予測の不確実性を示す指標)があらかじめ定めた閾値を下回ること。
- 直前ステップと今回のステップで最も確からしいトークンの予測が一致すること。
- ステップごとの処理:
- 打ち切りが起きない場合、エントロピーが低い(確信度が高い)トークンから順に受理されます。
- 確信度の低い残りのトークンは再び語彙全体から一様ランダムな状態に戻され、次のステップでの探索が続けられます。
- 温度パラメータの動的制御:
- 温度パラメータが0.8から0.4へ段階的に線形下降します。
- Denoising序盤は様々な可能性を広く探索し、終盤になるほど確信度の高い候補へ一気に収束させます。
- ステップ数の圧縮成果:
- 最大Denoisingステップ数は48に設定されています。
- 実際の平均ステップ数はタスクに応じて12程度に収まり、この大幅なステップ数圧縮が生成速度向上へ直結しています。
4. SFTとSD・RLによる2段階の学習パイプライン
教師ありファインチューニング(SFT)による基礎適応と、サンプラー蒸留・強化学習(SD・RL)を組み合わせたオンライン最適化によって、品質向上とステップ圧縮を両立する学習パイプラインを解説します。
4.1 1段階目:教師ありファインチューニング(SFT)
- 学習の起点: Gemma 4 26B A4Bの公開済み重みをベースに使用します。
- アテンションマスク制約: 256トークンのブロックごとに区切ったアテンションマスクの下でDenoisingするようモデルを適応させます。1つのブロック内での双方向アテンションを許可しつつ、他のブロックの内容には条件付けしない制約を課します。
- 損失関数: 0から1の範囲で一様にサンプルしたノイズレベル\(t\)に従って各ブロックにノイズを加え、モデルの予測と正解トークン間のDenoisingクロスエントロピー損失を最小化します。
- モードによる学習挙動の差:
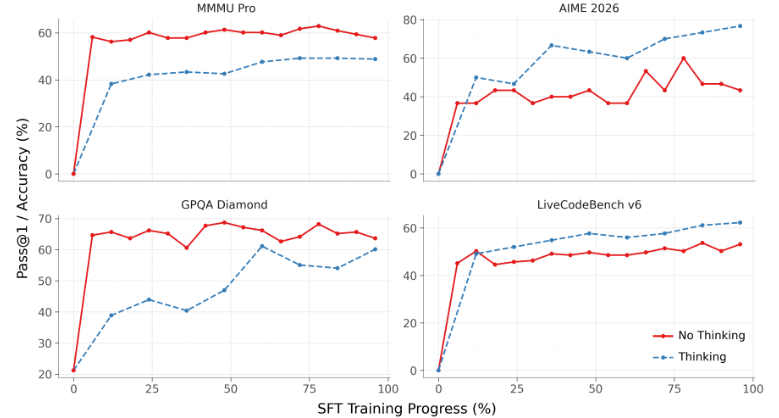
- 通常応答(non-thinkingモード): 比較的少ないSFT量で十分な性能に達します。
- thinkingモード(応答前の推論トレース生成): 学習初期段階では首尾一貫した推論を保てず、途中で同じ語句を繰り返す挙動に陥りやすい傾向があります。対数線形的にゆるやかに性能が向上するため、安定した推論能力の獲得にはより長いSFTを要します。
4.2 2段階目:サンプラー蒸留と強化学習(SD・RL)の同時最適化
- SFT完了時点の課題:
- Denoisingステップ数を多く取れば高い生成品質を発揮します。
- 高度な推論やコーディングタスクではAR版のベースラインにやや劣ります。
- 低レイテンシに必要な少ステップ設定で動かすと、品質が大きく崩れてしまいます。
- SD・RL手法の導入:
- 「報酬最大化による生成品質向上」と「高品質生成の少ステップ圧縮(サンプラー蒸留)」を、単一のオンライン学習ステップで同時に最適化します。
- SFT済みの重みから初期化されたモデル自身が「オンライン教師」として高いステップ数でDenoisingトラジェクトリを生成し、それを高品質な参照として学習を進めます。
- 学習過程における2つの相乗効果:
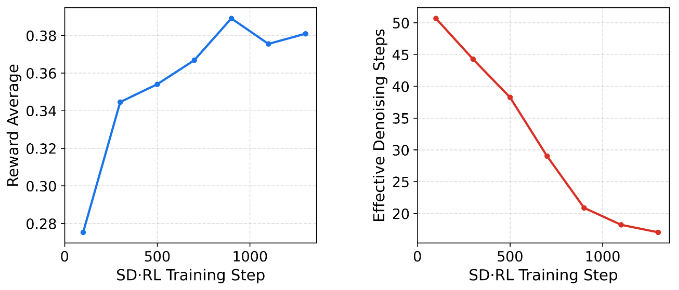
- オンライン教師の平均報酬が学習の進行とともに着実に向上します。
- モデルの予測エントロピーが下がるにつれて適応的停止が早いタイミングで発動し、オンライン教師が高い報酬を得るために必要な実効Denoisingステップ数が徐々に減少します。
- 暗黙のカリキュラム学習効果: 学習初期は予測エントロピーが高いため停止が遅れますが、確信度が上がるにつれて学習データ分布自体が自然と短いトラジェクトリへ偏っていきます。AR方式の強化学習とは異なり、報酬が頭打ちになった後もエントロピー低減を通じて速度面の改善が続きます。
4.3 SD・RLによる品質・速度向上と出力の「簡潔化」
SD・RLの適用により、品質と速度の両軸で明確な改善が達成されています。
- 品質面の向上: 数学的推論と競技プログラミングを組み合わせた指標で10ポイントの向上が見られました。
- 速度面の向上: 1回のフォワードパスあたりの生成トークン数(TPF)が5から約20へと4倍近くに伸びました。
- 推論ループの抑止: SFT直後のモデルを少ステップ設定(最大48ステップ)で動かした際に発生していた、同じトークンを繰り返して予測エントロピーが崩壊し適応的停止が不自然に早く発動する現象が大幅に抑えられ、少ステップでも一貫した推論が維持できるようになりました。
- 副産物(出力の簡潔化とそのトレードオフ):
- 最終的なモデルは、SFT直後のモデルと比べて生成する応答の長さがおよそ半分にまで短くなる「簡潔化」の傾向が報告されています。
- 長い推論トレースで報酬を高めようとするAR方式の強化学習とは対照的です。
- 簡潔な出力は生成速度をさらに底上げする一方で、長い推論トレースを通じた品質向上の余地を手放すことにもなるため、重要なトレードオフとなります。
5. 推論を高速化する仕組み
DiffusionGemmaが高速なスループットを実現する数理的定義、GPU上での各処理ステップの実行時間内訳、およびバッチサイズに応じたスループットの特性を解説します。
5.1 スループット指標の定義(TPFとTPS)
DiffusionGemmaの生成スループットは、「1回のフォワードパスで生成できるトークン数」と「1回のフォワードパスの実行時間」によって決まります。
Tokens Per Forward (TPF) の定義
1回のフォワードパスあたりに生成できる平均トークン数を示す指標です。
$$\mathrm{TPF} \triangleq \frac{\text{総生成トークン数}}{\text{総Denoisingステップ数} + K – 1}$$
- \(K\): 生成されたブロックの総数
- 補足: 分母に \(K-1\) が加わっているのは、あるブロックが確定するたびにそのブロックをKVキャッシュへ追記するための追加フォワードパスが1回必要になることを反映しています。
Tokens Per Second (TPS) の定義
実際の生成速度を表す指標であり、TPFを1回のSenoisingステップに要する実時間 \(t_{\mathrm{fwd}}\) で割ることで算出されます。
$$\mathrm{TPS} \triangleq \frac{\mathrm{TPF}}{t_{\mathrm{fwd}}}$$
5.2 GPUにおける1ステップあたりの実行時間と内部オーバーヘッド
256トークンを一括処理する1ステップは一見重く思われますが、NVIDIA H100・FP8精度・入力4096トークン/出力1024トークンという条件での計測結果では、AR方式の1ステップに対してわずか3.2倍の時間で済むことが報告されています。
内部処理ごとのオーバーヘッド詳細
- Mixture-of-Experts(MoE)レイヤー(4.3倍遅い): AR方式では1トークンあたり8個の専門家しか活性化されないのに対し、DiffusionGemmaでは256トークンのブロック全体でおよそ84個のユニークな専門家が動員されます。これが専門家の重みをメモリから読み出す転送コストを押し上げる主要因となっています。
- サンプリング処理(5.5倍遅い): AR方式が1トークン分のソフトマックスと抽選で済むのに対し、DiffusionGemmaは256トークン分・語彙数262,000次元にわたる自己条件付け信号の計算とソフトマックスを全精度で実施する必要があります。これにより処理時間が0.56ミリ秒から3.06ミリ秒へと増加します。
- アテンション計算(4.1倍遅い): 256トークンの並列処理に伴うアテンション計算の負荷が増加します。
- まとめ: 各項目の遅延はいずれも絶対時間としては数ミリ秒程度に収まっています。

5.3 従来モデル(AR版)との生成速度比較
対象論文における具体例な試算値は以下の通りです。
- 1ステップの実時間 \(t_{\mathrm{fwd}}\): 平均 13.56 ミリ秒
- 7種ベンチマーク平均 TPF: 19.74
- 平均生成速度 (TPS): 秒間 1,456 トークン
AR版Gemma 4とのスピード比較(同一H100環境)
- 標準AR版 Gemma 4(秒間 204 トークン): 約 7.1倍 の高速化
- 投機的デコード(MTP)付きAR版 Gemma 4(秒間 303 トークン): 約 4.8倍 の高速化
フォワードパス1回あたりの回数を大幅に減らすことで、フォワードパス自体が多少重くなっても差し引きで大きな純増になる関係が成り立っています。
5.4 バッチサイズ(同時接続数)による性能変化と限界
- 低バッチサイズ(単発・低同時接続): DiffusionGemmaがAR版Gemma 4(MTPあり)を、総スループットおよびユーザーあたりスループットの双方で大幅に上回ります。
- 高バッチサイズ(多人数同時接続): 同時接続数(バッチサイズ)がおよそ32を超えたあたりから、AR方式の方がスループットで有利になります。
- ボトルネックの原因: DiffusionGemmaは1トークンあたりにより多くの計算量を必要とするため、バッチサイズが大きくなると計算負荷がボトルネックになりやすいためです。
- 現在の状況: この結果は、サンプリング処理などバッチサイズ32を超える領域に向けた最適化が未十分な状態での計測数値であることが付記されています。
6. 性能評価: 速度と品質のパレートフロンティア
主要ベンチマークにおけるDiffusionGemmaの品質と速度の測定結果を整理し、既存のARモデルやオープン・非公開拡散モデルとの位置づけを比較します。
6.1 パレートプロットにおける位置づけ
品質(GPQA-Diamondとコーディングベンチマークのスコア平均)と出力速度の2軸で各種モデルを比較したパレートプロットにおいて、DiffusionGemma 26B A4Bは極めて優位な位置を占めています。
- 全スケールのGemma 4ファミリー(投機的デコード込み)との比較: 速度軸で大きく右側(高速)に位置し、品質軸でも競合水準を維持しています。
- オープンウェイト拡散モデル(LLaDA 2.1 Flash 100B, Nemotron Diffusion 14B)との比較: TPFにおいておよそ1桁の差をつけながら、品質面でも上回っています。
- 非公開API拡散モデル(Mercury 2)との比較: 品質面でほぼ拮抗しながら、およそ2.5倍の生成速度を達成しています。
6.2 主要ベンチマークのスコア比較
具体例なベンチマーク結果は以下の通りです。
| ベンチマーク | DiffusionGemma(拡散モード) | Gemma 4 26B A4B(AR) | Gemma 4 26B A4B(AR・MTP) |
|---|---|---|---|
| AIME 2026(数学) | 69.1 | 84.2 | 88.3 |
| GPQA-Diamond(知識) | 73.2 | 79.8 | 82.3 |
| LiveCodeBench-v6(コーディング) | 69.1 | 71.4 | 77.1 |
| 出力速度(トークン/秒) | 1,479 | 204 | 303 |
| Tokens Per Forward | 19.74 | 1.00 | 1.40 |
トレードオフの分析
- 品質面: 同一の重みから出発したAR版と比較すると、個々のベンチマークスコアではおおむね10ポイント前後低い水準にとどまります。
- 速度面: 出力速度は1桁近く高く、フォワードパスあたりのトークン数もAR版の10倍以上に達しています。
- 領域別の評価: 推論・知識、コーディング、指示追従・エージェントの各領域で、オープンウェイト拡散モデルを能力面で大きく上回りつつ、AR版より高速に動作することが一貫して確認されています。
6.3 AR方式としても動作する二重動作(dual-mode)特性
- 二重動作の仕組み: DiffusionGemmaの重みは、通常の左から右への逐次生成を行うAR方式でそのまま動かすことも可能です。
- ARモード時の特徴: 拡散モードで生じていた品質ギャップの一部が解消される反面、速度面での優位性は失われます。
- 実務上のメリット: リクエストごとのレイテンシ要件やタスクの複雑さに応じて、拡散モードとAR方式を動的に使い分けるハイブリッド運用という選択肢が広がります。
7. 拡散モデルならではの実用上の利点
低レイテンシ化だけでなく、双方向アテンションや並列検討の仕組みがもたらすテキスト拡散特有の実用的なメリットについて解説します。
7.1 双方向推論と自己修正能力
- AR方式の制約: 因果的アテンションの制約上、次トークンを生成する際に未来のトークンを考慮することができません。
- 拡散モデルの特長: キャンバス全体で双方向アテンションが働くため、任意の位置のトークンが過去と未来の両方の表現を同時に参照できます。
- 多段階算数問題での挙動比較:
- AR版 Gemma 4: 途中の計算過程を導出する前に最終解答の最初の記号を確定させる必要があるため、いったん誤った答えを出力し、その後の推論トレース内で誤りに気づいて訂正する動きを見せます。
- DiffusionGemma: 双方向アテンションを活かし、最終解答と根拠となる計算過程を同時並行的に発展させます。途中経過で誤った中間状態を経由しつつも、生成が進むにつれて推論トークンと答えトークンが相互に影響し合い、わずか5ステップで正しい答えへ直接収束します。
7.2 動的な計算量配分
- 計算量割り当ての違い: AR方式は生成トークン数ごとに一定の計算量しか割けません。
- 適応的停止による調整: 予測エントロピー低下による打ち切り機能により、簡単なタスクは少ない計算量で済ませ、難しいタスクにはより多くのステップを費やす調整が自動的に働きます。
- タスク難易度とステップ数:
- コーディングのような構造が明確なタスクは少ないステップ数で収束します。
- 自然言語での推論タスクではより多くのステップを要します。
- 同一のコーディング系タスクでも、問題難易度が上がるほど必要なステップ数が増加します。
- 制御ノブとしての活用: 最大Denoisingステップ数 \(N\) を増やすと品質が向上しますが、SD・RLを経たモデルでは \(N=48\) 付近で伸びが頭打ちになります。この上限値はレイテンシと品質のトレードオフを調整する明示的なノブとして利用できます。
7.3 構造化・制約付き出力への強さ
- 適用しやすいタスク: JSON形式での情報抽出や、既存コードの一部のみを修正するコード編集など。
- 処理効率の差:
- 出力の大部分がプロンプトから決まる定型的・低エントロピーな内容であっても、AR方式は1トークンずつ逐次生成が必要で $O(N)$ の計算コストを回避できません。
- 拡散モデルは全トークンを並列検討できるため、予測しやすい定型構造をまとめて一気に確定させることができます。
- 実証実験の成果: JSON抽出およびPythonコード編集の実例において、いずれもわずか2〜3回のDenoisingステップで出力全体が収束しており、定型出力ほど拡散方式のレイテンシ向上効果が大きくなります。
8. 独自ドメインへのファインチューニング
独自データセットへの適応を可能にするオープンソースツールキットの構成と、Sudokuパズルなどの具体的なドメイン適応実験の結果を説明します。
8.1 ファインチューニング用ツールキットとLoRA設定
- 提供形式: DiffusionGemmaの公開にあわせ、独自データセットへのファインチューニング用オープンソースツールキットが提供されています。
- 基盤フレームワーク: 汎用生成モデル向け研究フレームワーク「Hackable Diffusion」の上に構築されています。
- ハードウェア要件: Low-Rank Adaptation(LoRA)のレシピが用意されており、A100 80GB×2枚程度のコンシューマー寄りハードウェア構成でもファインチューニングが可能です。
- 学習損失関数:
- 文脈全体に対する通常の次トークン予測に基づくエンコーダ損失
- ノイズが加えられたブロックに対するDenoisingクロスエントロピー損失
- LoRAの適用範囲: アテンションの射影、MLPのゲート、MoEのルーター、自己条件付け用のフィードフォワード層まで、線形演算のほぼすべてに適用されます。
8.2 Sudokuパズル解法における検証
- 実験のねらい: Sudokuはマス目同士の制約を同時に満たす必要があり、左から右への逐次生成と相性が悪いため、非自己回帰生成方式の適性を試す題材として選定されました。
- 実験結果:
- ベースモデル(ファインチューニング前): 正しいパズルをほぼ生成できませんでした。
- フルファインチューニング後: 未学習の4,096問に対する正答率が85%を超えるまでに向上しました。
- LoRA(ランク8)による軽量ファインチューニング: 80%を超える正答率を達成しました。
- 速度と精度の同時改善: ファインチューニング後のモデルは予測の確信度が高まる(予測エントロピーが下がる)ことで実効denoisingステップ数自体が減少し、精度と速度の両方が同時に改善する結果が示されました。
8.3 他ドメイン(医療分野等)への応用可能性
- 医療QAでの検証: 医療分野の質問応答データセットである「PubMedQA」への適用結果も付録にて報告されています。
- 適応の広がり: Sudokuのような構造的制約を持つタスクにとどまらず、幅広いドメインへ低コストに適応できる可能性が示されています。
おわりに
DiffusionGemmaは、拡散モデルをゼロから事前学習し直すのではなく、公開済みのAR版Gemma 4を起点にSFTとSD・RLという2段階のファインチューニングを施すことで、計算コストを抑えながら速度と知能のパレートフロンティアを押し広げた事例として位置づけられます。単発・低同時接続のインタラクティブな用途でレイテンシを大きく削りたい場面では、拡散方式への転換が有力な選択肢になり得る一方、万能な置き換えではありません。
挙げられている限界として、AR方式からの性能低下には複数の要因が絡み合っています。拡散事前学習を経ずAR重みからウォームスタートしていること、計算予算の制約からSFTの期間が比較的短いこと、SD・RLが超低レイテンシを明示的に狙う設計のため漸近的な性能をある程度犠牲にしていること、そしてAR版から引き継いだアーキテクチャ・最適化・データ構成が離散拡散に最適とは限らないことなどが説明されています。このほか、まれに同じトークンを繰り返すスタッタリング(Stuttering)と呼ばれる劣化が低い頻度で残る点や、マルチモーダル入力を扱うthinkingモードで推論トレースの終了タグが生成されず、MMMU-Proでthinkingモードのスコア(54.3)がnon-thinkingモードのスコア(66.0)を下回る逆転現象が起きる点、同時接続数が約32を超えるとAR方式に速度で追い越される点も現時点の課題です。
実務的には、インタラクティブなエージェントやリアルタイム性が重視される単発リクエスト中心のサービスでは拡散方式が候補となる一方、多数のリクエストをさばく高スループット指向のサービングや長い推論トレースが精度に直結するタスクでは、AR方式やハイブリッド運用が適しています。DiffusionGemmaはオープンウェイトかつファインチューニング用ツールキット付きで公開されており、コミュニティによる新しいサンプリングアルゴリズムの探索や推論効率の向上、特定タスクへのファインチューニングを通じてテキスト拡散技術の可能性がさらに広がることが期待されています。また、ARと拡散を組み合わせたハイブリッドデコードへの発展も今後の研究方向として示されています。
More Information
- arXiv:2608.00146, DiffusionGemma Team (Google DeepMind), 「DiffusionGemma Technical Report」, https://arxiv.org/abs/2608.00146
関連記事

The Japan Bias: LLMに潜む隠れた文化的バイアス
大規模言語モデル(LLM)が世界中で利用される中で、モデルが出力する回答の「文化的な偏り」はAI開発における重要な課題となっています。これまで、LLMの文化的・地域的バイアスは、主にアメリカやヨーロッパといった欧米の視点 […]

距離学習入門 ~様々なタスクに応用できる機械学習手法~
距離学習(Metric Learning)は、データ間の類似度を学習する 機械学習の一手法です。従来の教師あり学習が、与えられたデータから特定のラベルや値を予測することを目的とするのに対し、距離学習は、データ間の関係性そ […]
Phantom Guardrails: 存在しない問題を修正するAIエージェント
近年、LLMベースのエージェントにおいて、自らのプロンプトやガードレールを修正し自己改善を進める「自動ハーネス最適化 (Automated Harness Optimization)」の導入が進んでいます。しかし、「観察 […]