Strong-to-Weak Scaffolding: パラメータ更新なしで弱いモデルを鍛える推論時ハーネス設計
LLM(大規模言語モデル)を使ったエージェントシステムの実運用が広がるにつれて、コストの観点から小型・安価なモデルをどう活用するかが現実的な課題になっています。大型モデルに匹敵する性能を小型モデルに持たせる代表的な方法はモデル蒸留(Distillation)ですが、これは教師モデルの出力やフィードバックを使って生徒モデルのパラメータを追加学習することが前提になっており、学習コストや運用の手間が発生します。
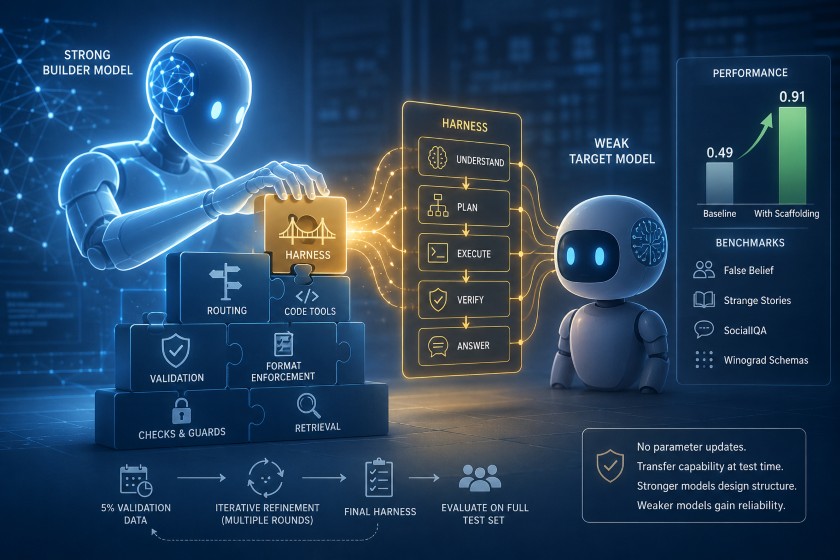
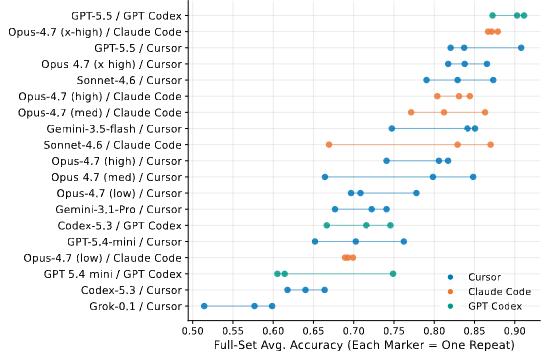
こうした中、Salesforce AI Research と UIUC の研究では、パラメータを一切更新せずに、推論時(Test-time)だけで強いモデルから弱いモデルへ能力を転移できるかという問いが検証されています。具体的には、強いBuilderモデルに、固定された弱いTargetモデル専用の推論時ハーネス(Scaffold、足場・治具のようなもの)を書かせ、それによってTargetモデルの性能がどこまで底上げされるかを Theory-of-Mind(心の理論)系ベンチマーク4種・72回の実験で検証しており、平均精度を \(0.49\) から \(0.91\) まで押し上げるという結果が報告されています。
この記事では、Strong-to-Weak Scaffolding と呼ばれるこの手法の仕組み、実験設定、効果の大きさと安定性、なぜ効くのかというメカニズム分析、Builderモデルやプラットフォームへの依存性、そして残された限界について、順番に解説します。
1. モデルを鍛えず「環境」を作り込むという発想
モデル性能向上の2つのアプローチ
モデルの性能を引き上げる方法は大きく2つに分けられます。
- モデル自体を賢くするアプローチ:
- 代表例はモデル蒸留(Distillation)です。
- 教師モデルが生成した根拠(Rationale)や推論トレースを使って生徒モデルを追加学習する手法(Distilling Step-by-Step)や、生徒モデル自身が生成した系列に教師のフィードバックを与える On-Policy Distillationなどが知られています。
- これらはいずれも生徒モデルのパラメータを変更することが前提であり、追加学習のコストが避けられません。
- タスクをモデルにとって解きやすい形に変えるアプローチ:
- 本アプローチはこの前提を置かず、こちらの「タスクを解きやすくする」経路に焦点を当てています。
認知負荷の軽減と推論時ハーネスの役割
- 背景にある問題意識:
- 小型モデルがタスクに失敗する原因は、必ずしもモデル自体の能力不足だけではありません。
- タスクの提示のされ方が過剰な認知負荷を課している場合もあります。
- 認知負荷理論を提唱した Sweller の1988年の研究を引き合いに、タスクの構造を外部で整理することで、モデル本体を変えずに性能を引き上げられる可能性が示唆されています。
- 推論時ハーネス(Inference-time Harness)の役割:
- 「タスクを解きやすくする」役割を担うのが、プロンプトテンプレート・ルーティングロジック・検証チェック・ツール利用などをモデルの周囲に配置する推論時ハーネスです。
- 実運用でも、小型モデルが単体で使われることは少なく、入力の解析・ツール選択・回答検証・タスク分解といったパイプラインに組み込まれて動くのが実態であり、ハーネス設計の巧拙がシステム全体の性能を左右します。
既存研究との位置づけと本手法の新規性
既存の関連分野を踏まえたうえで、それらと異なる新しい設定が切り出されています。
- 関連する既存分野:
- Chain-of-Thought(思考の連鎖)プロンプティングや自己整合性(Self-Consistency)に代表される推論時プロンプティング研究
- Toolformer・ReActのようなツール利用・プログラム的推論の研究
- DSPy や ADAS のようなハーネス自体を最適化対象とする研究
- 本手法が切り出した新しい設定:
- 単一モデルの推論を最適化するのではなく、強いBuilderモデルが、別の固定された弱いTargetモデルのために持続的な推論時手続きを構築するという、モデルをまたいだ(Cross-Model)Scaffold構築の問題を設定しています。
2. Strong-to-Weak Scaffolding の仕組み
2種類のモデル構成
この仕組みの設定には2種類のモデルが登場します。
- 強いBuilderモデル: ハーネスを書く側のモデルです。
- 弱いTargetモデル: 実際にベンチマークを解く側のモデルです。
Targetモデルのパラメータは一切更新されず、Builderモデルが構築した推論時のハーネスだけが、Targetモデルの振る舞いを変える手段になります。
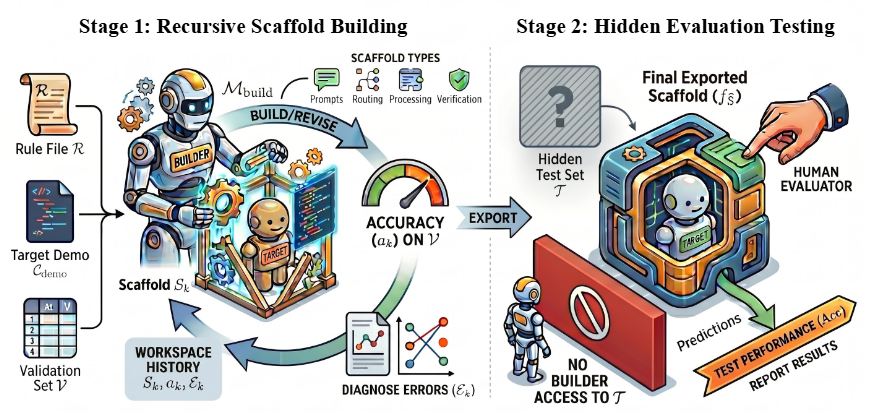
データ分割とビルドのプロセス
- データ分割:
- 各ベンチマークのデータのうち5%がラベル付きの検証セットとしてBuilderに公開されます。
- 残り95%は隠れテストセットとして最後まで非公開のまま保持されます。
- 初期環境の提供:
- Builderは Claude Code・Cursor・GPT Codex といった既存のエージェント型コーディング環境の中に置かれます。
- ルールファイル、Targetモデルの呼び出し方を示すデモ、検証データという初期ワークスペースが与えられます。
- 自律的な改善サイクルの実行:
- 資料を読み込んでタスクを理解します。
- スキャフォールドを実装または改訂します。
- 検証セットでTargetモデルを実際に呼び出して精度を測定します。
- 誤答を分析して次の改善につなげます。
- このサイクルを、自ら「提出」を判断するまで繰り返します。
- 最終評価の実施:
- ループを終えると、Builderは未知の入力に適用できる実行可能なエントリーポイントを提出します。
- その後は人間の評価者がそのハーネスを隠れテストセットに対して1回だけ実行して最終性能を測定します。
最適化の定式化と検証指標による近似
この設計の核心は、Builderが本来最適化したい対象と、実際に最適化できる対象が異なる点にあります。
- 本来最適化したい対象(理想):
ハーネス \(S\) を隠れテストセット \(\mathcal{T}\) 上の精度で最適化したいところですが、\(\mathcal{T}\) がBuilderから隠されているために実行できません。
$$S^\star = \arg\max_{S\in\mathcal{S}} \mathrm{Acc}(S, M_{tar}; \mathcal{T})$$ - 実際に解いている最適化(現実):
そこでBuilderが実際に解いているのは、公開された検証セット \(\mathcal{V}\) を代理指標とした最適化です。
$$\hat{S} = \arg\max_{S\in\mathcal{S}_{build}} \mathrm{Acc}(S, M_{tar}; \mathcal{V})$$
つまり、本当に知りたい「隠れたテストでの成績」を、見えている「検証データでの成績」で近似しながらハーネスを改善していく構図になっており、この近似がどこまで信頼できるかが、後述する検証効率の分析につながっています。
スキャフォールドの構成要素
スキャフォールドの中身に技術的な制約はなく、Builderが有効だと判断したものを自由に組み合わせられる設計になっています。
- プロンプトテンプレート
- ベンチマーク別のタスクルーティング
- 決定的な前処理・後処理コード
- 回答フォーマットの強制
- Few-shotサンプル
- 記号的なソルバー
3. Theory-of-Mind ベンチマークによる検証
評価対象の4つのベンチマーク
検証データに選ばれたのは Theory-of-Mind(ToM、心の理論)を問う4種類のベンチマークです。他者の信念や意図、隠れた情報を推論する能力が要求されるため、単純な知識問題では見えにくい「タスク構造の発見」が Builderに求められる点が特徴です。
| ベンチマーク | 件数 | 問われる能力 |
|---|---|---|
| BigToM | 1,200件 | 世界の変化を観測したかどうかに基づく二値の信念・ゴール・行動判定 |
| Hi-ToM | 1,200件 | 再帰順序0〜4の入れ子の信念推論、欺瞞(deception)や複数部屋にまたがる物体追跡を含む |
| MMToM-QA | 600件 | 行動トレースからのベイズ的なゴール・信念の二値推論 |
| MuMA-ToM | 900件 | マルチエージェント環境での信念・社会的ゴール・相手のゴールについての信念を問う3択問題 |
- データセットの内訳: 4ベンチマークの合計3,900件が隠れテストセットを構成し、Builderには全体の5%にあたる195件の検証サンプルが固定シードで割り当てられます。
- 評価指標:
- 主指標: 4ベンチマークの精度の単純平均(Macro average)
- 副指標: 検証データの評価回数(効率性を測るため)
実験パラメータと制御変数
合計72回の実験が、以下の制御変数を組み合わせて実施されています。
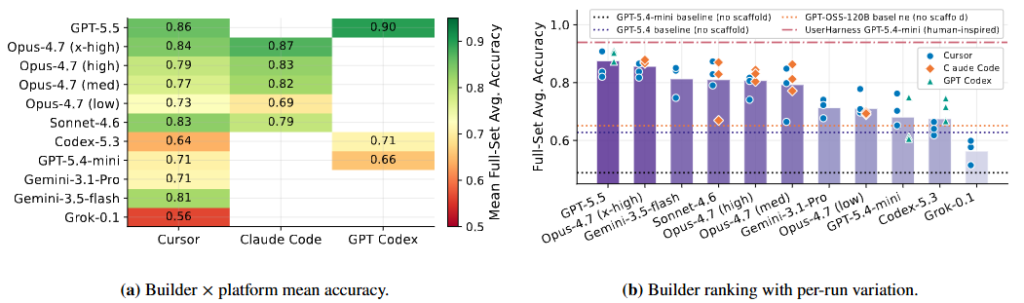
- プラットフォーム: Cursor、Claude Code、GPT Codex
- builderモデル(計11構成):
- Opus-4.7(推論努力量を4段階に変更したものを含む)
- Sonnet-4.6
- GPT-5.5
- GPT-5.4-mini
- Codex-5.3
- Gemini-3.1-Pro
- Gemini-3.5-Flash
- Grok-0.1
- targetモデル: GPT-5.4-mini、Gemini-3.5-Flash
- 繰り返し回数: 安定性を確認するため各設定で3回
比較ベースライン
比較対象として2種類のベースラインが設定されています。
- Vanilla設定:
- タスク固有の工夫を一切与えずtargetモデルを直接呼び出す設定です。
- Macro average 精度は GPT-5.4-mini で \(0.488\)、Gemini-3.5-Flash で \(0.761\) です。
- 「自動スキャフォールディングがどれだけ底上げしたか」を測る基準点として機能します。
- UserHarness設定:
- 人間がToM問題向けに設計したハーネスを適用した設定です。
- Macro average精度は GPT-5.4-mini で \(0.939\)、Gemini-3.5-Flashで \(0.941\) に達します。
- 「人手設計にどれだけ迫れたか」を測る上限の目安として機能します。
4. スキャフォールディングの効果の大きさと安定性
主要な性能向上結果
主要な結果は GPT-5.4-mini を Target とした実験に集約されています。
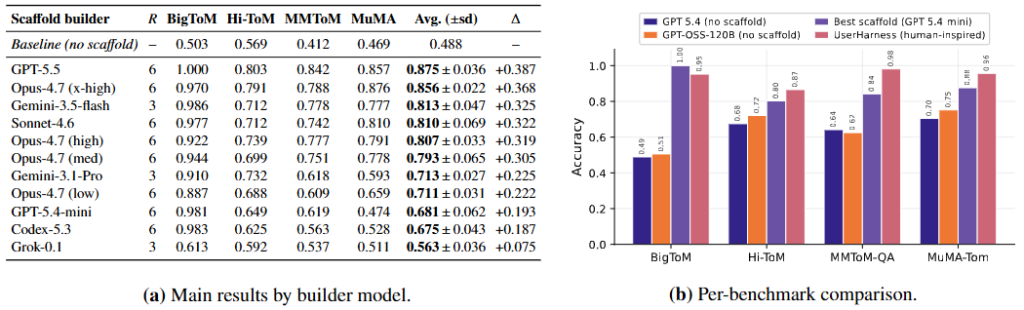
- 57回の全スキャフォールド付き実行の平均 Macro average 精度は \(0.763\) で、Vanillaベースラインの \(0.488\) から \(+0.275\) の底上げが確認されています。
- 57回すべてがベースラインを上回っています。
- 11種類の Builder構成のすべてが平均でベースラインを上回っています。
- 最良の個別実行は GPT-5.5 を GPT Codex上で動かした構成で、\(0.912\)(\(+0.423\)、相対で87%向上)に達しています。
| 指標 | 値 |
|---|---|
| GPT-5.4-mini vanillaベースライン | 0.488 |
| GPT-5.4 vanillaベースライン(無足場でのより大きいモデル) | 0.619 |
| GPT-5.4-mini human-inspired(UserHarness) | 0.939 |
| 全スキャフォールド付きランの平均 | 0.763(+0.275) |
| 最良ラン(GPT-5.5 / GPT Codex) | 0.912(+0.423、相対87%) |
注目すべき点は、多くのスキャフォールド付き GPT-5.4-mini構成が、無足場のより大きいGPT-5.4モデル(\(0.619\))さえも上回っていることです。これは、良く設計されたハーネスが、より大きいモデルへのアップグレードよりも大きな効果を持ちうることを示しています。
ベンチマーク別の達成状況
成果はタスクによって異なります。
- BigToM:
- 自動生成スキャフォールドが \(1.00\) に達し、UserHarnessの0.95をわずかに上回る近い天井の性能を記録しています。
- 人手設計との差が残るベンチマーク:
- Hi-ToM: 自動 \(0.80\) 対 UserHarness \(0.87\)
- MMToM-QA: 自動 \(0.84\) 対 UserHarness \(0.98\)
- MuMA-ToM: 自動 \(0.88\) 対 UserHarness \(0.96\)
この差は、後述するように、タスクの推論内容をどこまで決定的な手続きに落とし込めるかという「コンパイル可能性」の違いに起因すると分析されています。
再現性とばらつきの分析
- 全体的な安定性:
- 同一設定内の繰り返し3回における標準偏差の平均は \(0.036\) で、\(+0.275\) という主効果の1桁小さいレベルに収まっており、おおむね安定していると報告されています。
- ばらつきの要因と戦略による差:
- 最大では \(0.201\) の幅を持つ設定もあり、ビルドプロセスが完全に決定的ではないことも示されています。
- 最もばらつきが大きいのは決定的ソルバー戦略を採用した設定です。1,000件を超えるベンチマーク全体に対して単一のロジックエラーが数十ポイント規模の精度変動を引き起こすことがあると報告されています。
- プロンプトのみのスキャフォールドはより安定していますが、その分得られる伸びも小さい傾向にあります。
5. 何が効いているのか?
検証データの活用実態と相関分析
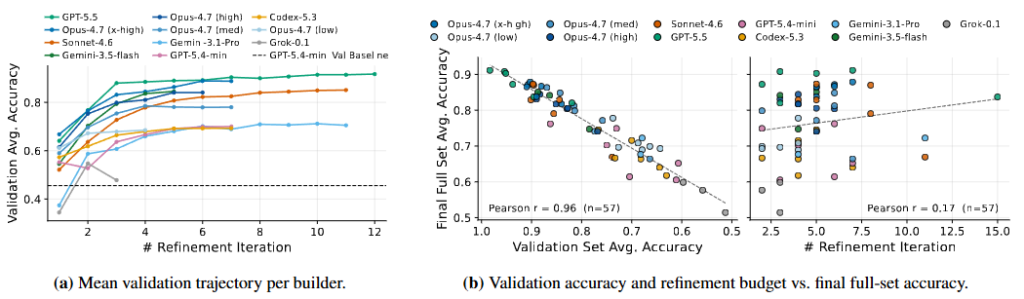
- 評価回数: Builderは検証評価を平均4.9回(中央値5回、範囲2〜15回)しか使っていません。
- 精度の相関: 検証セットで得られた最良精度と、隠れテストセットでの最終精度の相関はピアソン相関係数で\(0.96\) と非常に強く、平均の乖離(Optimism Gap)もわずか \(0.021\) にとどまっています。
- 評価回数と精度の無相関: 一方で、検証評価の回数自体と最終精度の相関は \(r=0.17\) とほぼ無関係でした。
- 示唆: この2つの相関係数の対比は、検証データをたくさん叩くことよりも、Builderが少ない手がかりから正しい仮説を立てられるかどうかの方が重要であることを示唆しています。
スキャフォールド技術の12分類タキソノミー
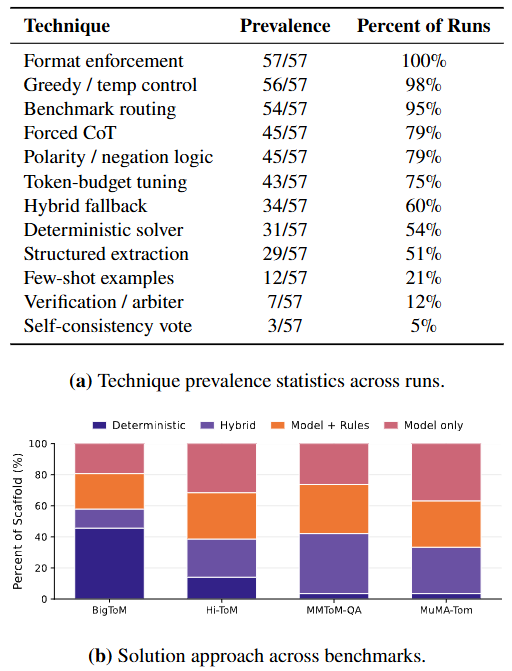
さらに、全72実行のスキャフォールドコードを読み解いて12種類の技術タキソノミーに分類する分析が行われています。
- 信頼性の土台となる基礎技術(ほぼ全てのランが採用):
- 回答形式を確実にパースするフォーマット強制(57件中57件が採用)
- 温度0の貪欲デコーディング(56件)
- ベンチマーク別ルーティング(54件)
- 強制的な思考の連鎖(Forced CoT、45件)
- 高度・複雑な技術(一部のランにのみ採用):
- 決定的ソルバー(31件)
- 構造化された状態抽出(29件)
- Few-shot サンプル(12件)
- 検証・裁定パス(7件)
- 自己整合性投票(3件)
- 性能向上への寄与が大きい技術:
- 極性・否定論理(使用ランと未使用ランの平均精度差:\(+0.09\))
- 構造化抽出(\(+0.06\))
- ハイブリッドフォールバック(\(+0.04\)) これらは表面的なプロンプトの工夫ではなく、観測/非観測の混同や信念状態の追跡といったToMベンチマーク特有の失敗モードを直接狙い撃ちした技術であると分析されています。
決定性の比率(Determinism Fraction)と認知負荷
この2層構造は、認知負荷の削減という観点からさらに裏付けられています。
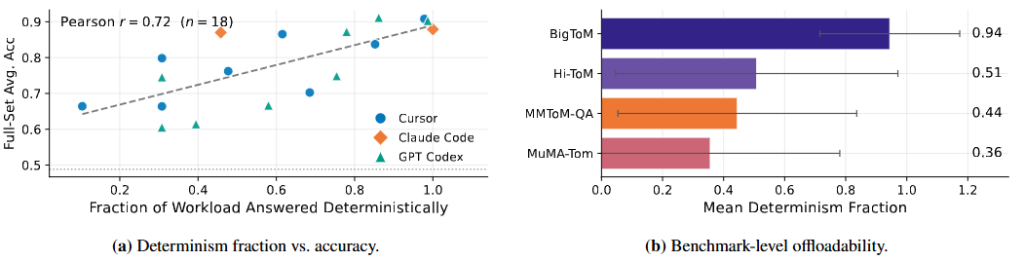
- 決定性の比率の定義: 決定的なコードやルールだけで回答できた項目の割合を「決定性の比率(Determinism Fraction)」として定義しています。
- 精度との相関: この比率と最終精度の相関を調べたところ、ピアソン相関係数で \(0.72\) という強い正の相関が確認されています。
- ベンチマーク別のコード化割合:
- BigToM: 平均94%までコード化可能
- Hi-ToM: 51%
- MMToM-QA: 44%
- MuMA-ToM: 36%(自由な対話推論を要するため低い) このように、タスクごとにコンパイル可能性が大きく異なることが分かります。
改善の統計的信頼性
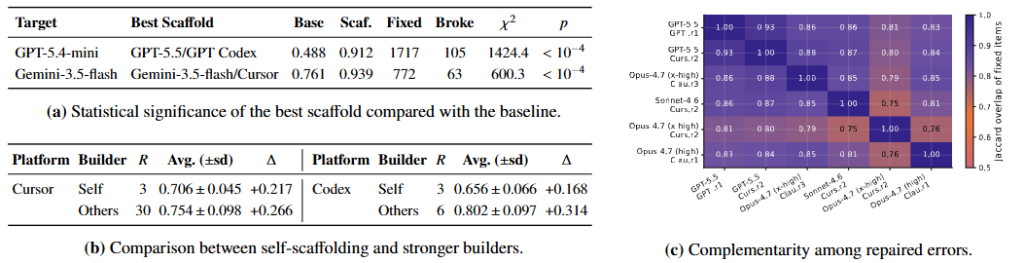
統計的検定(対応ありのMcNemar検定)によると、GPT-5.4-miniに対する最良スキャフォールドの改善は極めて有意(\(p < 10^{-4}\))です。
- 3,900件の評価項目のうち、ベースラインで誤答だった1,717件を正解に修正
- もともと正解だった項目を誤りに変えたのはわずか105件
この非対称性は、精度の向上が単なる誤りの入れ替えではなく、広範な正答への転換によって生じていることを示しています。
自己スキャフォールディングとBuilderの能力差
Builderの強さがどこまで必要かという問いに対しては、興味深い結果が得られています。
- 自己スキャフォールディングの有効性:
- GPT-5.4-mini自身が自分自身のためにスキャフォールドを構築する自己スキャフォールディングの設定でも、ベースラインに対して\(+0.17\)〜\(+0.22\)の改善が確認されています。
- 弱いTarget自身にも、検証フィードバックとタスク構造から有用なハーネスを組み立てる力があることが示されています。
- 強いBuilderによる上乗せ効果:
- より強いBuilderを使うとその差はさらに広がります。
- GPT Codexプラットフォームでは、自己スキャフォールディングの+0.17に対し、より強いBuilderでは\(+0.31\) まで伸びており、強い Builderが高性能領域を切り開く鍵であることが確認されています。
6. ビルダー・プラットフォーム・ターゲットモデルへの依存性
Builder の Reasoning Effort の影響
精度のばらつきの主要因を分解すると、Builderモデル自体の実力が最も大きな要因であり、同一Builder内でのプラットフォーム間の差は相対的に小さいという傾向が確認されています。この点をさらに掘り下げるため、Opus-4.7のReasoning Effort を low・medium・high・extra-high の4段階に変える実験が行われています。
| プラットフォーム | Low | Medium | High | Extra-high |
|---|---|---|---|---|
| Cursor | 0.728 | 0.770 | 0.788 | 0.840 |
| Claude Code | 0.694 | 0.816 | 0.826 | 0.872 |
- Reasoning Effortと精度の単調増加: 両プラットフォームともに Reasoning Effort を上げるほど精度が単調に改善しており、順位相関はスピアマン係数で0.77に達しています。
- コード量の増加: スキャフォールドのコード量も low での約510〜650行から extra-high での約1,000〜1,300行まで増加しており、Builder が深く考えるほどより多くのタスク構造をコードへと変換していることがうかがえます。
プラットフォームの影響とネイティブ環境の優位性
- プラットフォーム自体の効果: プラットフォームそのものの効果は限定的です。Builder自身の開発元と同じ「ネイティブ」なプラットフォームを使う優位性は、平均でわずか \(+0.013\) にとどまり、統計的にも有意ではありませんでした(順列検定で \(p=0.484\))。
- 推論努力量との交互作用: ただし、Opus-4.7を対象にした分析では、Reasoning Effort が高いときに限ってネイティブプラットフォームの優位性が現れるという交互作用が確認されています。プラットフォームの利点は、Builderが十分な思考量を使いこなせる場合にのみ発現する二次的な要因であると位置づけられています。
Targetモデルの「伸びしろの法則(Headroom Law)」
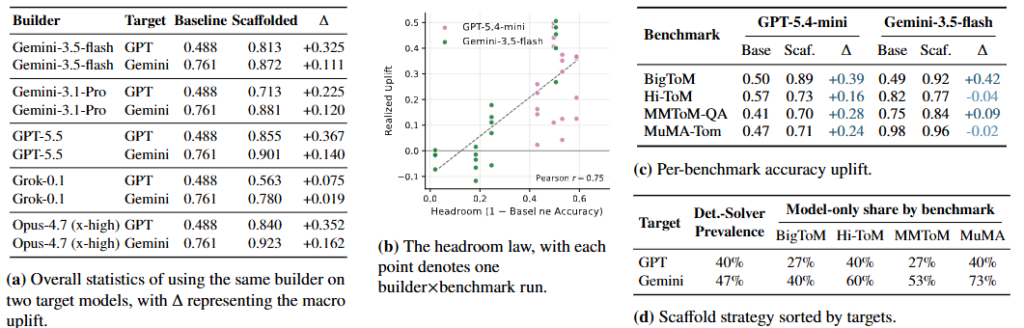
Targetモデルの違いについては、「Headroom law(伸びしろの法則)」と呼べる明確な規則性が見出されています。あらゆるBuilder×ベンチマーク×Target組み合わせを通じて、実現したUpliftの大きさは、Targetがそのベンチマークに残している伸びしろ(1からベースライン精度を引いた値)とピアソン相関係数 \(0.75\) で強く相関しています。
- モデルごとの伸びしろと改善幅:
- 弱いGPT-5.4-miniは平均 \(+0.262\) の改善を得た一方、既に強い Gemini-3.5-Flash の改善は \(+0.110\)にとどまっており、この差の大部分は伸びしろの大小で説明できます。
- Gemini-3.5-Flashでは、改善のほぼ全てがBigToMに集中しており、同モデルの Macro average 上のUpliftのうち96%を占めています。これは、BigToMが強いTargetでも依然として伸びしろが残っており、かつ最もルール化しやすいタスクであることの両方を反映していると分析されています。
- Targetに応じたbuilderの戦略変化:
- Builder側の戦略もTargetの強さに応じて変化しています。
- Gemini-3.5-Flashを対象にする場合は、GPT-5.4-miniを対象にする場合よりも決定的な仕組みへの依存が減り、タスクをモデル自身の推論に任せる割合がベンチマーク全体で上昇します。
- 特にMuMA-ToMではモデル任せの比率が40%から73%まで跳ね上がっています。
- Builderが「Targetが既にある程度解けるタスクにはルールベースの介入を控え、伸びしろが残る部分にだけ重い仕組みを割り当てる」という適応的な判断をしていることがうかがえます。
過剰スキャフォールディング(Over-scaffolding)のリスク
さらに重要な指摘として、既にベースライン精度が高いTargetモデルに対しては、スキャフォールディングが逆効果になりうる「過剰スキャフォールディング」のリスクが報告されています。
- GPT-5.4-mini: 20件の対応するケースのうちベースラインを下回った例は1件もありませんでした。
- Gemini-3.5-flash: 20件中9件でいずれかのベンチマークにおいてベースラインを下回っており、特にHi-ToM(平均\(-0.04\))や既にほぼ天井に達しているMuMA-ToM(平均\(-0.02\))で顕著でした。
伸びしろがほとんど残っていない状態に追加のプロンプトやルールを重ねると、正しい振る舞いをかえって乱す可能性があることを示す結果です。
7. 限界と残された課題
タスクの複雑性と残差誤差
最も強い8つのGPT-5.4-miniスキャフォールドの残差誤差を分析した結果からは、自動スキャフォールディングの限界がはっきりと見えてきます。
- BigToM: あらゆる下位区分で \(0.95\) 以上の精度に達しており、事実上解決済みとされています。
- Hi-ToM:
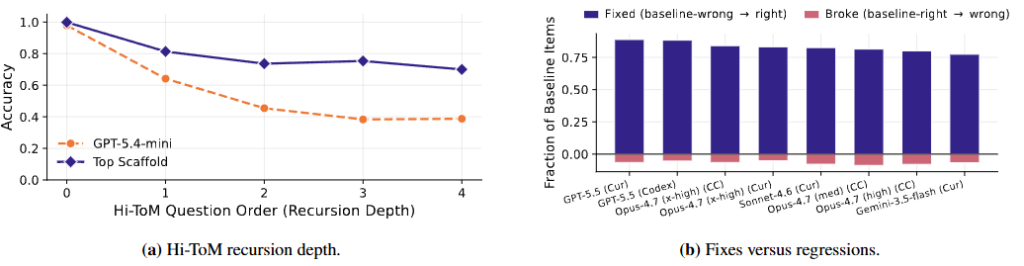
- 信念推論の再帰の深さが増すほど精度が低下し、再帰順序 0 の \(0.999\) から、順序 4 では \(0.700\) まで落ち込みます。
- 欺瞞(Deception)を伴うケースでは、伴わないケース(\(0.829\))に比べてさらに精度が下がり \(0.772\) となっています。
| ベンチマーク | 残差精度が低い区分 | 精度 |
|---|---|---|
| Hi-ToM | 再帰順序4 | 0.700 |
| MMToM-QA | ベイズ的ゴール推論のqtype 2.1 | 0.680 |
| MuMA-ToM | 社会的ゴール判定 | 0.872 |
| MuMA-ToM | 相手のゴールについての信念判定 | 0.880 |
- 推論依存領域の限界:
- MMToM-QAではベイズ的なゴール推論を問う設問タイプで精度が伸び悩んでいます。
- MuMA-ToMでは社会的ゴールや「相手のゴールについての信念」を問う設問が、単純な信念質問(\(0.985\))と比べて明確に難しいままです。
- これらは、決定的なコードやルールに落とし込みにくい「モデル自身の推論に委ねざるを得ない領域」であり、スキャフォールディングが有効なのはタスクの構造がコンパイル可能な場合に限られると結論づけられています。
- 副作用の存在:
- 最良のスキャフォールドでも、ベースラインの誤りのうち平均83%を修正する一方、もともと正解だった項目の7%を新たに誤らせており、改善はおおむね純増に近いものの完全に無害ではありません。
現在の前提と今後の検証課題
- ToM系ベンチマークへの限定性:
- 検証対象がTheory-of-Mind系ベンチマークに限定されている点が挙げられます。
- これらのベンチマークは記号的に扱いやすい構造と、扱いにくい難しい推論の両方を含む混合的な性質を意図的に選んでいるため、他の分野のタスクに同じ結論がそのまま当てはまるかは今後の検証課題として位置づけられています。
- 少量検証データの一般化:
- 検証データがベンチマーク全体の5%という少量で十分に機能した点についても、それがToMタスクに特有の性質に依存している可能性があり、より曖昧・非構造的なタスクでの追試が必要であると述べられています。
おわりに
この取り組みが示した中心的な発見は、強いBuilderモデルが一度だけまとまった推論コストを払ってタスクの構造を発見し、それを推論時ハーネスという形でコンパイルしてしまえば、以降は弱く安価なTargetモデルがそのハーネスを実行するだけで、大幅に高い性能を発揮できるという点です。学習によるDistillationとは異なる経路で、強いモデルの知的な作業を弱いモデルに再配分できることが、複数の実験を通じて実証されています。
実務的には、提示されている簡潔なレシピが参考になります。
- Builderは妥協しない: 使える中で最も強いモデルを選ぶ
- 考える時間を惜しまない: Scaffold構築時の Reasoning Effort は高めに設定する
- 検証は数で押さない: 評価回数は少数に絞り込み、質の高い改善に集中する
- オフロードを優先する: 決定的に処理できるサブタスクから認知負荷を引き剥がす
- 予算が許せば並走させる: 複数の独立したスキャフォールドを構築し、良いものを選ぶか組み合わせる
一方で、既に高性能なモデルに対してはむやみにスキャフォールドを追加すると精度を損なう恐れがあるため、Targetモデルの伸びしろを見極めたうえで、必要な箇所にだけ選択的にハーネスを適用する判断が求められます。
今後の展望として、ToM以外の様々なベンチマークファミリーへの拡張、エージェントハーネス自体が自動的に改善していく「ハーネス自己進化」研究への接続、そしてBuilderモデル自体の能力を測る新しい評価軸としてこの設定を発展させる可能性が挙げられています。モデルの訓練とハーネスの設計は対立する経路ではなく、互いを高め合いながら共進化していく方向性が示唆されており、モデルそのものを強くする努力と、タスクをどう構造化してモデルに提示するかという設計知は、今後どちらも欠かせないものになりそうです。
More Information
- arXiv:2608.12307, Cheng Qian et al., 「AI4AI at Test-Time: Strong-to-Weak Capability Transfer via Harnesses」, https://arxiv.org/abs/2608.12307
関連記事

X-ANFISではじめる適応型ニューロファジィ推論システム入門
AI技術の進化はめざましく、特に深層学習は画像認識から自然言語処理まで、多様な分野で驚異的な成果を上げています。その強力な予測能力は目を見張るものがありますが、時に「なぜそのような判断を下したのか」という意思決定プロセス […]
SWE-chat: 実際の開発者はAIコーディングエージェントをどう使っているのか?
AIコーディングエージェントが急速に普及していますが、実際の開発現場ではどのように使われているのでしょうか?この記事では、現実の利用実態を分析した初の大規模データセット「SWE-chat」から、実践的なインサイトを紹介し […]

強化学習の世界を俯瞰してみる - 基礎から最前線の課題・応用・トレンドまで
強化学習(RL)は、エージェントが試行錯誤を通じて最適な行動を学習する機械学習の一分野です。近年、囲碁やビデオゲーム、大規模言語モデル(LLM)の制御など、多岐にわたる分野で著しい進展を遂げ、応用されています。 特に、深 […]