Stable Baselines3 で検証する: 強化学習のトレーディングエージェントは Buy & Hold に勝てるか?
以前の記事では、強化学習の基本概念から最新のトレンドまでを俯瞰し、Stable Baselines3(SB3)を使った実装例も紹介しました。ただ、実際に手を動かそうとすると、公開されている Gym 環境の多くはロボット制御やゲームを前提にしたもので、ビジネスの場面に近い題材はあまり見つかりません。
そこで今回は、pandas の DataFrame を読み込むだけで売買の環境を作れる gym-trading-env を選びました。計算だけで完結するので速く、時系列データの観測・離散的な意思決定・報酬の設計という、在庫管理や価格設定などの業務課題にも通じる要素を一通り試せます。
題材は暗号資産 BTC/USDT の 1 時間足です。PPO で学習したエージェントが、「買ってそのまま持ち続ける」だけの Buy & Hold(いわゆるガチホ) に勝てるのかを検証します。
最初の実験でエージェントはひどく過学習したため、その対策、評価方法の見直し、特徴量の追加、報酬の変更と、順に手を加えていきました。この記事では、その過程と、途中で何度も結論がひっくり返った経緯をまとめます。
この記事は強化学習の検証記録であり、投資助言ではありません。
先に結論
- gym-trading-env は 1 ステップあたり約 19µs と高速で、ノート PC の CPU だけでも 30 万ステップの PPO 学習が約 1 分で終わります。
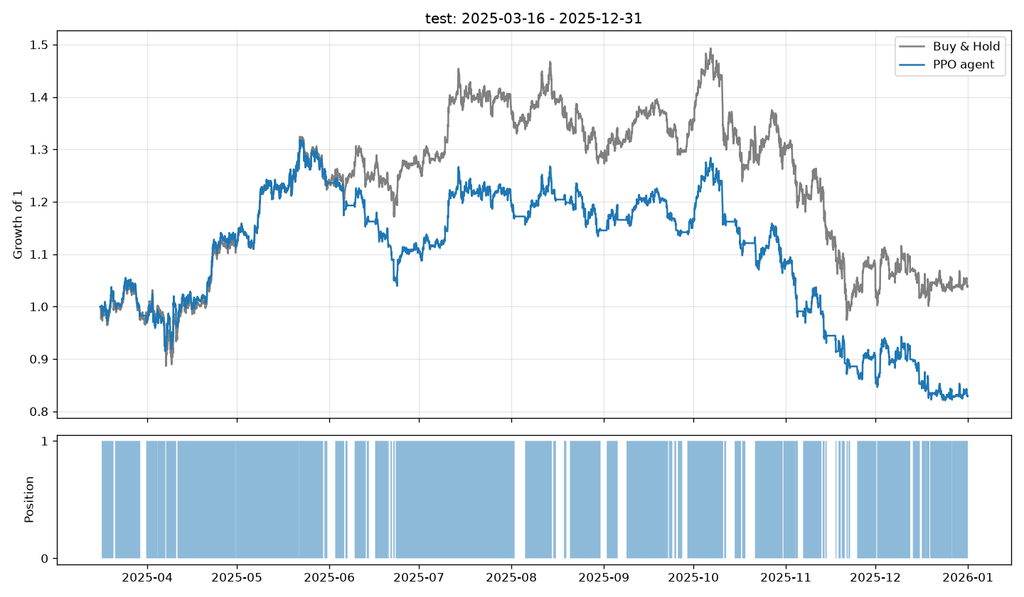
- 最初の実験では、学習期間のリターンが +405% だった一方、テスト期間では -17%(Buy & Hold は +4%) と典型的な過学習になりました。
- 学習時だけ手数料を高くする方法と、複数 seed のモデルによる多数決(seed アンサンブル) は、過剰な売買と seed 間のばらつきを抑えるのに効きました。
- 2024〜2025 年のウォークフォワード評価では、価格以外の情報を全部入れたアンサンブルが Buy & Hold を上回りました(Sharpe 0.98 vs 0.74)。
- しかし、どの判断にも使っていなかった 2026 年のデータでは再現せず、Buy & Hold に大きく負けました。報酬を超過リターンに変えても、期間をまたいで安定して勝てる設定は見つかりませんでした。
- 一番の教訓は評価方法です。単一のテスト期間での比較や、多数の条件から最良を選ぶ比較は、2 回にわたって誤った結論を導きました。
gym-trading-env の概要
環境の仕組み
gym-trading-env は、Gymnasium 互換の売買シミュレーション環境です。価格データの DataFrame を渡すだけで、次のような環境ができあがります。
- 観測:DataFrame のうち、列名に
featureを含む列がそのまま観測ベクトルになります。これに「直前のポジション」と「現在の実ポジション」の 2 つが自動で加わります。 - 行動:あらかじめ決めたポジションのリストから 1 つを選びます。今回は
[0, 1]、つまり「現金 100%」か「BTC 100%」かの 2 択です(Discrete(2))。 - 報酬:デフォルトは資産評価額の対数リターンです。報酬関数は自由に差し替えられます。
- 手数料・金利:売買手数料や、レバレッジをかけたときの借入金利も設定できます。
観測は Box、行動は Discrete なので、SB3 の PPO や DQN に、ラッパーを書かずにそのまま渡せます。
0.3.5 を使う際の注意点
執筆時点の最新版(0.3.5、2025 年 2 月リリース)は更新が止まり気味で、実際に使ってみると、いくつか落とし穴がありました。
- 警告フィルタの上書き:
gym_trading_env.environmentsはモジュールの先頭でwarnings.filterwarnings("error")を実行します。import した瞬間からプロセス全体の警告が例外に変わるため、SB3 や pandas が出す無害な警告でも学習が止まりかねません。import の前後で警告フィルタを退避・復元しておきます。 - pandas 3 系でのエラー:付属のデータ取得機能
gym_trading_env.downloaderは、pandas 3 系ではTypeErrorで落ちます。今回は ccxt を直接使ってデータを取得しました。 - 乱数シードの再現性:エピソード開始位置の抽選に
np.randomを直接使っているため、env.reset(seed=...)では再現性が確保できません。np.random.seed()も合わせて設定します。
なお、gym_trading_env/__init__.py は環境を登録するだけで、environments モジュールは gym.make() の時点で遅延 import されます。1 の対策は、TradingEnv を直接 import して、その前後で行う必要があります。
環境構築
uv でプロジェクトを作成
uv でパッケージ形式のプロジェクトを作り、必要なライブラリを追加します。
$ uv init --package --python 3.12 sb3-trading-env
$ cd sb3-trading-env
$ uv add gym-trading-env stable-baselines3 matplotlib
最終的なディレクトリ構成は次のとおりです。各モジュールは pyproject.toml の [project.scripts] に登録し、uv run trading-train のようにコマンドとして呼び出せるようにしています。
sb3-trading-env/
├── pyproject.toml
├── src/sb3_trading_env/
│   ├── data.py          # ccxt で OHLCV を取得(trading-download)
│   ├── extra_data.py    # 価格以外のデータを取得(trading-download-extra)
│   ├── features.py      # 特徴量の作成と時系列分割
│   ├── env.py           # TradingEnv の生成と報酬関数
│   ├── train.py         # PPO の学習(trading-train)
│   ├── evaluate.py      # 評価・多数決アンサンブル(trading-evaluate)
│   ├── experiments.py   # 過学習対策の比較(trading-experiments)
│   └── walkforward.py   # ウォークフォワード評価(trading-walkforward)
├── data/
├── models/
└── results/
データを取得する
ccxt で Binance の 1 時間足を取得します。1 回のリクエストで取れるのは 1,000 本までなので、取得済みの最後の時刻を起点にページングしながら集めます。
2022〜2025 年の 4 年分(約 3.5 万本)の取得は 10 秒ほどで終わります。
def fetch_ohlcv(exchange_name, symbol, timeframe, since, until, limit=1000) -> pd.DataFrame:
    exchange = getattr(ccxt, exchange_name)({"enableRateLimit": True})
    rows = paginate(
        lambda cursor: exchange.fetch_ohlcv(symbol, timeframe, since=cursor, limit=limit),
        timestamp_of=lambda row: row[0],
        since=since,
        until=until,
        step_ms=exchange.parse_timeframe(timeframe) * 1000,
        pause_s=exchange.rateLimit / 1000,
    )
    df = pd.DataFrame(rows, columns=["timestamp", "open", "high", "low", "close", "volume"])
    df = df.drop_duplicates("timestamp").sort_values("timestamp")
    df.index = pd.to_datetime(df.pop("timestamp"), unit="ms")
    return df.astype("float64")
特徴量を設計する
観測に使う特徴量は、価格と出来高から作った次の 14 個です。
- 1・2・3・6・12・24 時間の対数リターン
- 終値に対する高値・安値・始値の比(足の形)
- 24・72・168 時間の移動平均からの乖離
- 直近 1 週間に対するボラティリティ水準と出来高
特徴量の作成にあたっては、次の工夫を入れています。
- ボラティリティによるスケーリング:すべての特徴量を直近 1 週間のボラティリティで割って、スケールを揃えています。BTC は価格水準もボラティリティも時期によって大きく変わるため、生のリターンをそのまま入れると、学習期間とテスト期間で値の分布がずれてしまいます。
- 外れ値のクリップ:外れ値の影響を抑えるため、±5 でクリップしています。
- 未来情報のリーク防止:rolling 計算はすべて過去方向だけを使うので、未来の情報が特徴量に混ざることはありません。
log_ret = np.log(df["close"]).diff()
vol = log_ret.rolling(24 * 7).std()

for lag in (1, 2, 3, 6, 12, 24):
    df[f"feature_ret_{lag}"] = log_ret.rolling(lag).sum() / (vol * np.sqrt(lag))
環境を生成する
TradingEnv の生成は 1 つのモジュールにまとめ、先ほどの警告フィルタの問題もここで吸収します。
1 時間足の対数リターンは 0.001 前後と小さく、そのままでは PPO の価値関数がうまく学習できないため、報酬を 100 倍して % 単位にしています。
import warnings

_saved_filters = warnings.filters[:]
from gym_trading_env.environments import TradingEnv  # noqa: E402
from gym_trading_env.utils.history import History  # noqa: E402

warnings.filters[:] = _saved_filters

POSITIONS = [0, 1]       # 0: 現金 100%、1: BTC 100%
TRADING_FEES = 0.001     # Binance 現物の標準的な手数料(0.1%)
REWARD_SCALE = 100.0


def scaled_log_return(history: History) -> float:
    return REWARD_SCALE * np.log(
        history["portfolio_valuation", -1] / history["portfolio_valuation", -2]
    )


def make_env(df, max_episode_duration="max", initial_position="random",
             trading_fees=TRADING_FEES) -> TradingEnv:
    return TradingEnv(
        df=df,
        positions=POSITIONS,
        reward_function=scaled_log_return,
        trading_fees=trading_fees,
        max_episode_duration=max_episode_duration,
        initial_position=initial_position,
        verbose=0,
    )
PPO で学習する
学習では、8 つの環境を並列に動かし、各エピソードは学習期間内のランダムな位置から始まる 30 日間(720 ステップ)とします。
学習の実行速度は次のとおりです。
- 1 ステップあたりの処理時間:約 19µs
- 学習全体のスループット:1 秒あたり約 6,000 ステップ
- 30 万ステップの所要時間:約 1 分
vec_env = DummyVecEnv([make_train_env(train_df) for _ in range(8)])
model = PPO(
    "MlpPolicy",
    vec_env,
    n_steps=512,
    batch_size=256,
    learning_rate=3e-4,
    gamma=0.99,
    ent_coef=0.01,
    device="cpu",
)
model.learn(total_timesteps=300_000)
最初の実験:学習期間は +405%、テスト期間は -17%
実験条件と評価指標
最初の実験は、次の条件と指標で行いました。
- データ分割:データを時系列順に 80:20 に分け、前半で学習し、後半(2025-03〜2025-12)でテストします。
- 評価時の動作:期間全体を 1 エピソードとして、確率的にではなく決定的に(最も確率の高い行動を選んで)動かします。
- 成績の指標:
- リターン
- Sharpe レシオ(1 時間ごとのリターンから年率換算した、リスクあたりのリターン)
- 最大ドローダウン(資産の高値からの最大下落率)
実験結果
学習期間では Buy & Hold の 4 倍のリターンを上げている一方、テスト期間では負けています。学習データの値動きを丸暗記しただけの、典型的な過学習です。テスト期間の売買回数は 97 回あり、手数料 0.1% だけで約 10% を失っている計算になります。
| 期間 | PPO エージェント | Buy & Hold |
|---|---|---|
| 学習期間(2022-01〜2025-03) | +404.8%(Sharpe 1.06) | +101.0%(Sharpe 0.41) |
| テスト期間(2025-03〜2025-12) | -17.1%(Sharpe -0.65) | +3.9%(Sharpe 0.12) |
過学習対策を比較する
検討した対策
過学習を抑えるために、次の 4 つの対策を比較しました。データは学習 60% / 検証 20% / テスト 20% に分け直しています。また、1 つの seed だけの結果は偶然に左右されやすいため、各条件を 5 seed ずつ学習しました。
学習時の手数料を引き上げるのは、評価時の手数料(0.1%)とは別に、学習中だけエージェントに「売買は高くつく」と思わせる工夫です。
| 対策 | 狙い |
|---|---|
| 検証期間で最良のモデルを選ぶ(早期停止) | 学習しすぎる前の時点のモデルを使う |
| 学習時だけ手数料を 0.3% にする | 売買のコストを重く見せて、過剰な売買を抑える |
| 観測にノイズを加える(σ=0.3) | 特徴量の細かな値への過敏さを抑える |
| 5 銘柄(BTC・ETH・SOL・BNB・XRP)で学習する | データの多様性を増やし、BTC 固有のパターンの丸暗記を防ぐ |
結果:単一のテスト期間では差が誤差に埋もれる
テスト期間(2025-03〜2025-12)での 5 seed の平均は次のとおりです。
- ばらつきの抑制:学習時の手数料引き上げ、観測ノイズ、5 銘柄での学習は、いずれも seed 間のばらつきを大きく減らしました。
- 手数料引き上げの効果:中でも学習時の手数料引き上げは、売買回数を 83 回から 29 回に減らし、5 seed すべてでリターンがプラスになりました。
- 単一テスト期間の限界:この時点では「5 銘柄で学習」がリスク調整後の成績で最も良く見えました。ただ、テスト期間が 1 つしかなく、5 seed の差も標準偏差の範囲に収まっています。実際、次の章でこの結論はひっくり返ります。
| 条件 | モデル | リターン(平均 ± 標準偏差) | Sharpe | 最大ドローダウン | 売買回数 |
|---|---|---|---|---|---|
| Buy & Hold | – | +3.9% | 0.12 | -34.8% | – |
| 対策なし | 学習終了時 | -0.9% ± 12.2% | -0.06 | -34.2% | 83 |
| 対策なし | 検証期間で最良 | -9.4% ± 10.6% | -0.44 | -31.8% | 66 |
| 学習時の手数料 0.3% | 学習終了時 | +4.5% ± 2.4% | 0.16 | -30.2% | 29 |
| 観測ノイズ | 学習終了時 | +4.9% ± 3.9% | 0.16 | -30.2% | 45 |
| 5 銘柄で学習 | 学習終了時 | +6.5% ± 6.6% | 0.27 | -22.0% | 61 |
検証期間でのモデル選択は逆効果だった
意外だったのは、早期停止がかえって成績を悪くしたことです。検証期間での成績とテスト期間での成績の相関は -0.35 でした。
検証期間は約 9.5 か月の 1 区間しかありません。その区間で一番成績の良かったモデルを選ぶと、「その相場にたまたま合ったモデル」を選ぶことになり、次の相場ではむしろ外れやすくなったと考えられます。教師あり学習の感覚で早期停止を入れると、時系列の強化学習では裏目に出ることがある、という例です。
ウォークフォワード評価と seed アンサンブル
ウォークフォワード評価で評価の信頼性を上げる
テスト期間が 1 つだけでは比較が当てにならないため、ウォークフォワード評価に切り替えました。2024-01 から 2025-12 までの 2 年間を 3 か月ずつ 8 つの区間に分け、各区間について次の手順を繰り返します。
- 各区間のテスト結果をつなげると、2 年分の「学習に使っていない期間」の成績が得られます。
- 実運用で「四半期ごとに、それまでの全データで学習し直す」ことをそのまま再現した形です。
- 前の章の結果を踏まえ、検証期間でのモデル選択はやめ、学習終了時のモデルを使います。
区間 1: [2022-01 ───────── 2023-12 で学習] → [2024-01〜03 でテスト]
区間 2: [2022-01 ──────────── 2024-03 で学習] → [2024-04〜06 でテスト]
  ...
区間 8: [2022-01 ──────────────────── 2025-09 で学習] → [2025-10〜12 でテスト]
seed アンサンブル
あわせて、5 seed のモデルの行動を多数決で決める seed アンサンブルも試しました。実装は、SB3 のモデルと同じ predict() を持つクラスを 1 つ用意するだけです。
PPO.predict() と同じ形で呼べるので、評価用の関数には単体のモデルと区別せずに渡せます。
class MajorityVoteEnsemble:
    def __init__(self, models: list[PPO]):
        self.models = models

    def predict(self, obs, deterministic=True):
        votes = [int(m.predict(obs, deterministic=deterministic)[0]) for m in self.models]
        return int(np.bincount(votes).argmax()), None
結果:アンサンブルで単体モデルの弱さが打ち消される
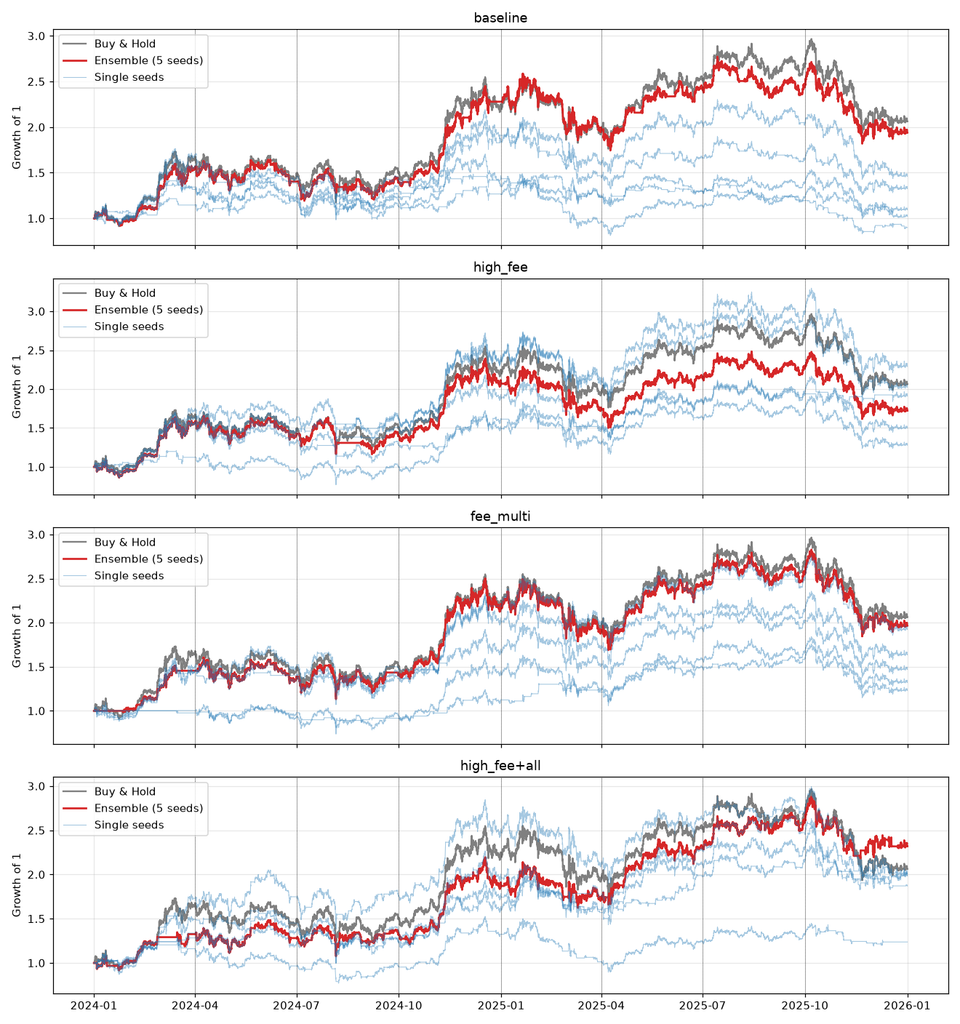
4 条件 × 8 区間 × 5 seed、計 160 回の学習を 20 並列で回し、20 分強で終わりました。2 年間を通した成績は次のとおりです。
- seed アンサンブルの効果:まず効いたのが seed アンサンブルです。対策なしの条件では、単体モデルの最高が +47% だったのに対し、アンサンブルは +94% まで伸びました。多数決で各 seed のばらばらな売買が打ち消し合い、売買回数も 200〜360 回から 123 回に減っています。
- 単体モデルでの比較:単体モデルで最も安定して強かったのは、前の章と同じく学習時の手数料引き上げでした。逆に、前の章で一番良く見えた「5 銘柄で学習」は最下位です。単一のテスト期間でたまたまうまくいっただけでした。
- Buy & Hold との比較:それでも、どの条件も Buy & Hold は上回れていません。最良の条件でも Sharpe は Buy & Hold と同じ 0.74 で、結局は「ほぼ持ち続ける」方針に近づくことで負けを防いでいるだけでした。
| 条件 | 単体 seed のリターン(平均 ± 標準偏差) | アンサンブルのリターン | アンサンブルの Sharpe | アンサンブルの売買回数 |
|---|---|---|---|---|
| Buy & Hold | – | +106.4% | 0.74 | – |
| 対策なし | +16.2% ± 23.0% | +94.1% | 0.74 | 123 |
| 学習時の手数料 0.3% | +80.3% ± 40.8% | +72.4% | 0.57 | 19 |
| 5 銘柄で学習 | +10.4% ± 44.4% | -5.8% | -0.07 | 185 |
| 手数料 0.3% + 5 銘柄 | +51.9% ± 27.4% | +96.7% | 0.74 | 31 |
価格以外の情報を特徴量に加える
使えるデータ、使えないデータ
価格と出来高だけでは相場の手がかりが足りない可能性があるため、価格以外の情報を加えることにしました。2022 年までさかのぼって無料で取得できるかを確認した結果は次のとおりです。
| グループ | 特徴量 | 取得元 | 採否 |
|---|---|---|---|
| derivatives | 無期限先物と現物の価格差、資金調達率 | Binance USDT-M 先物 | 採用 |
| flow | 成行買いの比率、1 約定あたりの平均サイズ | Binance 現物の生 kline | 採用 |
| sentiment | Fear & Greed Index(日次の市場心理指数) | alternative.me | 採用 |
| calendar | 時刻・曜日(sin/cos で表現) | 計算で作成 | 採用 |
| cross_asset | 主要 5 銘柄の平均リターン、市場全体に対する BTC の相対リターン | 取得済みの OHLCV | 採用 |
| – | 建玉(未決済の先物残高)、ロング/ショート比率 | Binance 先物 | 直近 30 日分しか取れず不採用 |
データ取得と前処理の注意点
- 成行買い比率の取得:成行買いの比率は、Binance の kline に含まれる「taker buy volume」の列から作ります。ccxt の
fetch_ohlcv()はこの列を捨ててしまうため、publicGetKlines()で生のデータを取得しました。 - 時刻の扱い(未来情報の混入防止):
- 資金調達率は 8 時間ごとに確定するので、確定した時刻以降に前方補完します。
- Fear & Greed Index は日付 d の値を d+1 日の 0 時から使うことにし、未来の情報が混ざらないようにしています。
- 将来リターンとの相関:各特徴量と将来リターンとの相関を事前に見たところ、最大でも |0.05| 程度でした。市場データとしては想定どおりの水準ですが、目に見えるほど強い手がかりはないということでもあります。
結果:全部入りのアンサンブルだけが Buy & Hold を上回った
単体モデルで最も強かった「学習時の手数料 0.3%」を土台に、5 つのグループを 1 つずつ加えた条件と、全部を加えた条件を、同じウォークフォワード評価で比べました(学習は計 240 回)。
| 条件 | 単体 seed の Sharpe | アンサンブルのリターン | アンサンブルの Sharpe | 最大ドローダウン | Buy & Hold に勝った区間 |
|---|---|---|---|---|---|
| Buy & Hold | – | +106.4% | 0.74 | -34.8% | – |
| 追加なし | 0.63 | +72.4% | 0.57 | -37.3% | 3/8 |
| + derivatives | 0.69 | +77.3% | 0.72 | -37.7% | 4/8 |
| + flow | 0.38 | +37.9% | 0.34 | -37.2% | 2/8 |
| + sentiment | 0.45 | +40.5% | 0.37 | -38.6% | 2/8 |
| + calendar | 0.36 | +23.7% | 0.26 | -35.5% | 2/8 |
| + cross_asset | 0.32 | +84.4% | 0.64 | -34.8% | 4/8 |
| + 全部 | 0.71 | +132.0% | 0.98 | -27.5% | 6/8 |
実験から見えた傾向
- 単独グループの効果:derivatives だけは単独でも効果があり、単体 seed 間のリターンのばらつきが ±41% から ±13% に縮みました。一方、flow・sentiment・calendar は、単独ではむしろ悪化しています。
- 全部入りアンサンブルの成績:全部を加えたアンサンブルだけが、リターン・Sharpe・最大ドローダウンのすべてで Buy & Hold を上回りました。
- 局面ごとの挙動:区間ごとに見ると、2025-10〜12 の下落局面では Buy & Hold の -23.3% に対して -11.2% と損失を半分程度に抑えています。一方、2024-01〜03 の急騰局面では +67.8% に対して +32.5% と出遅れています。下落に強く上昇に弱い、守りのエージェントという性格です。
この結果に対する留保
もっとも、この結果には大きな留保がつきます。
- 10 条件を同じ 2 年間で比べて一番良いものを選んでいるため、この期間にたまたま合った条件を選んでいる可能性があります。
- 単体 seed の平均では Buy & Hold の Sharpe を超えていません。
- Sharpe 0.98 と 0.74 の差も、2 年分のデータでは統計的に有意とは言えません。
未使用の 2026 年データで確かめる
事前に判定基準を決める
ここまでのデータは 2025 年末まででしたが、執筆時点(2026-11)では、2026-01〜2026-11 の約 10 か月分のデータが、まだどの判断にも使われずに残っています。この期間で選択バイアスのない検証ができます。
結果を見てから解釈を変えないよう、実行前に次のことを決めました。
- 比べるのは、手数料 0.3% + 全特徴量のアンサンブル(本命)、手数料 0.3% で追加特徴量なしのアンサンブル、Buy & Hold の 3 つ
- 手順はウォークフォワード評価と同じく、四半期ごとに、それより前の全データで学習し直す
- 本命のアンサンブルが、Sharpe と最大ドローダウンの両方で Buy & Hold を上回れば合格とする
データを延長する際は、2025 年までの部分が以前のデータと完全に一致することも確認しています。
結果:再現しなかった
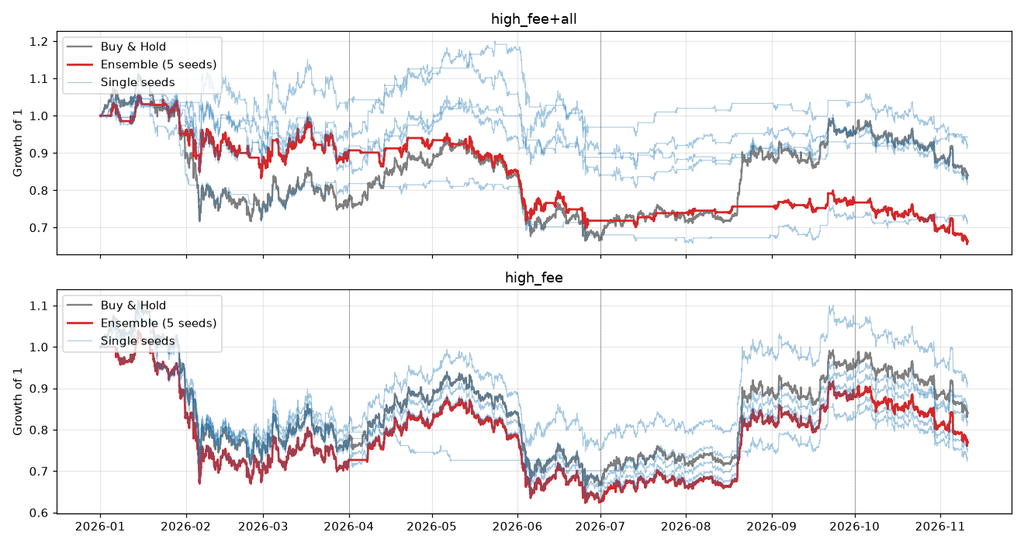
判定は不合格です。最大ドローダウンはわずかに良かったものの、Sharpe では大きく負けました。
目立つのは、アンサンブルが 5 seed のどの単体モデルよりも悪かったことです。
- 2026 年 8 月中旬に BTC が急騰し、7〜9 月の区間で Buy & Hold は +42.8% でしたが、この区間にアンサンブルが市場にいた時間は 35% しかありません。
- 各 seed がばらばらのタイミングで買っていたため、多数決では「買い」がほとんど成立しなかったと考えられます。
- 2024〜2025 年には売買のばらつきを抑えて有利に働いた多数決が、今回は上昇相場への乗り遅れとして裏目に出ました。
2024〜2025 年に見えた優位性は、10 条件の中から最良を選んだことによる選択バイアスだった可能性が高いと言えそうです。
| 条件 | リターン | Sharpe | 最大ドローダウン |
|---|---|---|---|
| Buy & Hold | -16.0% | -0.48 | -40.3% |
| 手数料 0.3% + 全特徴量(アンサンブル、本命) | -33.7% | -1.41 | -38.1% |
| 同上(単体 seed の平均) | -15.1% ± 9.0% | -0.62 | -28.4% |
| 手数料 0.3%(アンサンブル) | -23.0% | -0.73 | -40.1% |
報酬を超過リターンにする
理論上、最適な方策は変わらない
最後に、報酬を Buy & Hold に対する超過リターンに変えてみました。
$$r_t = 100 \times \left( \log \frac{V_t}{V_{t-1}} – \log \frac{P_t}{P_{t-1}} \right)$$
ここで \(V_t\) はエージェントの資産評価額、\(P_t\) は BTC の価格です。
- BTC を持ち続けている場合:報酬は 0(手数料分だけマイナス)になります。
- 現金で待機している場合:市場リターンの符号を反転した値になります。
def scaled_excess_log_return(history: History) -> float:
    market = np.log(history["data_close", -1] / history["data_close", -2])
    return scaled_log_return(history) - REWARD_SCALE * market
実は、この変更で最適な方策そのものは変わりません。引き算している市場リターンは、エージェントの行動に左右されないためです。
それでも試す価値があると考えたのは、学習信号のノイズが減るからです。元の報酬は大部分が「相場がたまたま上がったか下がったか」で決まり、売買判断の良し悪しが埋もれていました。超過リターンにすれば、売買判断の差だけが報酬に残ります。
結果:期間によって効果が逆転する
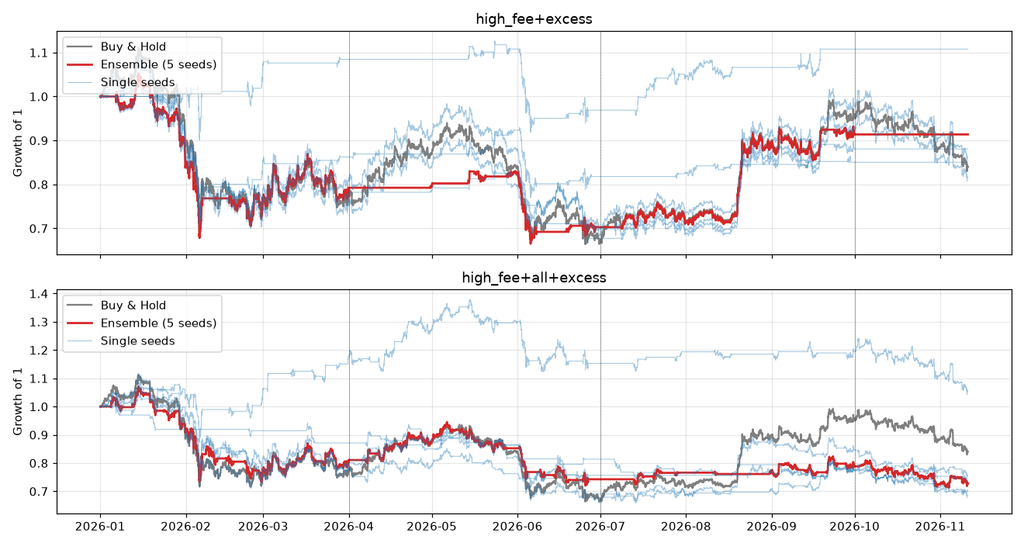
手数料 0.3% と、手数料 0.3% + 全特徴量の 2 条件について、報酬だけを変え、2024〜2025 年と 2026 年の両方で評価しました。なお、2026 年は前の章で一度使っているため、もう完全な未使用期間ではありません。
- 2026 年単体の成績:2026 年だけを見ると、「手数料 0.3% + 超過リターン」が Sharpe・最大ドローダウンとも Buy & Hold を上回りました。中身を見ると、最後の区間(2026-10〜11)のモデルが一度も買わずに現金のまま過ごし、その間の -11.6% の下落を避けたことが大きく効いています。
- 期間をまたいだ一貫性:2024〜2025 年では逆に成績が悪化しており、効果は一貫しません。
- 単体モデルの安定性と通算成績:狙っていた「学習信号のノイズが減って単体モデルが安定する」効果も確認できませんでした。2024〜2025 年の単体 seed の Sharpe は、2 条件とも元の報酬より下がっています。そして約 2 年 10 か月の通算では、どの条件も Buy & Hold を下回りました。
| 条件 | 2024〜2025 年のアンサンブル(リターン / Sharpe) | 2026 年のアンサンブル(リターン / Sharpe) | 通算リターン(2024-01〜2026-11) |
|---|---|---|---|
| Buy & Hold | +106.4% / 0.74 | -16.0% / -0.48 | +73.4% |
| 手数料 0.3% | +72.4% / 0.57 | -23.0% / -0.73 | +32.7% |
| 手数料 0.3% + 超過リターン | +61.7% / 0.50 | -8.6% / -0.31 | +47.8% |
| 手数料 0.3% + 全特徴量 | +132.0% / 0.98 | -33.7% / -1.41 | +53.8% |
| 手数料 0.3% + 全特徴量 + 超過リターン | +128.9% / 1.02 | -27.2% / -1.09 | +66.6% |
過信してはいけないポイント
- 対象は BTC の 1 時間足、行動は 2 択だけ
今回の結論は、BTC/USDT の 1 時間足で、行動を「現金 100%」と「BTC 100%」の 2 択に限った場合のものです。日足や分足、ポジションの段階的な調整、空売りを含む設定では、結果が変わる可能性があります。 - 手数料以外の取引コストは入っていない
売買手数料(0.1%)は考慮していますが、スリッページ(注文価格と約定価格のずれ)や約定の遅れは入っていません。実際の取引では、成績はさらに悪くなると考えたほうが安全です。 - PPO のハイパーパラメータは調整していない
PPO の設定は一般的な値のまま固定しています。ハイパーパラメータの調整や、別のアルゴリズム(DQN、SAC など)で結果が変わる余地はあります。その代わり、調整すればするほど、今回見たような選択バイアスの問題は大きくなります。 - seed は 5 つ、未使用期間は 10 か月だけ
seed 5 つ、検証期間 2 年 + 10 か月は、成績の差が統計的に意味のある差かを判定するには短い期間です。今回の「勝ち」「負け」は、あくまで傾向として捉えてください。 - アンサンブルの集約方法は多数決だけ
多数決は「全部持つか、全く持たないか」になるため、2026 年のように上昇相場を丸ごと逃すことがあります。各 seed の行動確率を平均する方法や、5 seed 中 3 seed が買いなら 60% だけ持つといった方法は試していません。
おわりに
今回は、Stable-Baselines3 と gym-trading-env を使って、PPO のトレーディングエージェントが Buy & Hold に勝てるかを検証しました。過学習対策、ウォークフォワード評価、seed アンサンブル、価格以外の特徴量、超過リターン報酬と手を加えましたが、期間をまたいで Buy & Hold を安定して上回る設定は見つかりませんでした。
一番の収穫は、強化学習の性能を評価する手順の重要さを身をもって確かめられた点です。単一のテスト期間での比較で一番良く見えた「5 銘柄で学習」はウォークフォワード評価で最下位になり、10 条件の中から選んだ「全特徴量のアンサンブル」は未使用の 2026 年で再現しませんでした。どちらも、手順を 1 段階厳しくしただけで結論がひっくり返っています。
もし 2024〜2025 年の結果だけで記事を締めていたら、「強化学習で Buy & Hold に勝てた」と書いていたはずです。gym-trading-env は 1 ステップが速く、学習を何百回も回す比較実験を手元の CPU だけで実行できるので、こうした厳しい評価の練習台としても向いていそうです。在庫管理や価格設定など、ビジネスの課題に強化学習を応用する場合も、ウォークフォワード評価と未使用期間での確認は最初から手順に組み込んでおくのが安全です。
もう一つ気になっているのが、相場の性質は年ごとに変わるという点です。今回は、それまでの全データを同じ重みで学習し、3 か月ごとに学習し直していました。2026 年に急騰を丸ごと逃したのも、過去の相場で学んだことが今の相場に合っていなかったからかもしれません。
学習が 1〜2 分で終わる速さを活かせば、直近のデータを優先して学習し、こまめに学習し直す方法も取れます。直近と似た相場の時期を過去から抜き出して、学習データの量を補う方法もありそうです。このあたりは次の機会に試してみたいと思います。
More Information
関連記事

TruthTorchLMによるLLMのハルシネーション検出
大規模言語モデル(LLM)の目覚ましい進化は生活やビジネスに革新をもたらす一方で、事実に基づかない情報を生成するハルシネーションが問題となっています。特に医療や金融といった高リスクな分野では、LLM出力の信頼性と正確性が […]

scikit-upliftで始めるアップリフトモデリング入門
データ駆動型の意思決定において、機械学習モデルは「どの顧客が商品を購入する可能性が高いか」という相関関係の予測に広く活用されています。しかし、マーケティング施策や介入の予算を真に最適化するためには、「我々の施策(介入)に […]

YOLOv13: ハイパーグラフで実現する高速・高精度リアルタイム物体検出
リアルタイム物体検出の分野では、YOLOシリーズがその優れた精度と計算効率により、長らく支配的な地位を占めてきました。しかし、YOLO11以前の畳み込みアーキテクチャやYOLOv12の自己注意メカニズムは、局所的な情報集 […]