FrontierPhysics: AIエージェントによる物理学研究能力の評価
LLM(Large Language Model: 大規模言語モデル)を使ったエージェントは、文献を探して要約し、仮説を立て、シミュレーションのコードを書いてデバッグし、最後に技術レポートを仕上げるところまで手が届くようになってきました。そうなると次に気になるのは、「研究プロジェクトをまるごと任せたら、論文として通用する成果が出てくるのか」という点です。ところが、それを測るベンチマークが十分ではありません。既存の科学系ベンチマークの多くは固定された問題か研究の一部分だけを切り出したもので、正解が一意に決まる問題はモデルの進歩ですぐに飽和してしまいます。
2026年11月に公開された「FrontierPhysics」(arXiv:2611.06910)は、この問題に正面から向き合ったベンチマークです。42人の現役物理学者が自分自身の研究プロジェクトをもとに56のタスクを作り、エージェントに文献調査、研究計画、計算・実験、論文執筆までを一通りこなさせます。採点は、数値を機械的に照合する検証器と、タスク作成者が書いたルーブリック(rubric: 採点基準)の2本立てです。22モデル・26構成で評価したところ、最も成績の良い構成でも168回の試行のうち合格は46回(27.4%)にとどまりました。
この記事では、タスクの作り方と品質管理、スコアの計算式、モデルごとの結果とコスト、採点そのものの信頼性の検証、そして「エージェントは何でつまずくのか」を分析した失敗モードの分類までを順に紹介します。結論として示されているのは、エージェントの弱点は物理の知識不足ではなく、推論の厳密さと専門家としての直感にあるという点です。審査員モデルの選び方や偽陰性の扱いなど、物理以外の分野でエージェントを評価する人にもそのまま参考になる話が多く含まれています。
1. 既存の科学ベンチマークが抱える課題
既存ベンチマークにおける3つの弱点
科学分野のベンチマークは、教科書レベルの問題から、専門家レベルの閉じた問題、さらに研究レベルの問題へと難度を上げてきました。それでも、既存の研究レベルのベンチマークには大きく次の3つの弱点があります。
- 飽和の問題
決定論的な正解がある問題は、モデルが強くなるとすぐ解かれてしまい、モデル間の差が測れなくなります。 - 論文再現型ベンチマークの限界
論文を丸ごと再現させるタイプ(PRBench、ReplicationBench、QMP-Benchなど)では、エージェントに元論文を渡すため、何を問い、どう解くかの骨組みが最初から決まっています。これでは開かれた探究の評価になりません。 - 解答なし課題への作り変えに伴う難しさ
公開済み研究を解答なしの課題に作り変える最近のベンチマーク(NatureBench、PRL-Bench、ResearchClawBench、PhySciBench)にも難しさが残ります。偽陰性を避けながら自由度をなるべく残す指示文の書き方や、エージェントの失敗が科学的な誤解によるものか経験・勘の不足によるものかの見極めには、その研究をした本人の専門性が要ります。
既存ベンチマークとの7観点での比較
既存ベンチマークを7つの観点で比較した主な結果は次のとおりです(✓: あり、◦: 部分的、×: なし)。
7つすべてを満たすのはFrontierPhysicsだけです。特に、文献調査の質と執筆した論文の質を両方採点しているベンチマークはほかに見当たりません。「計算結果が合っているか」だけでなく、「研究として、論文として通用するか」まで問う設計になっています。次の章では、それを実現するタスクの中身を見ていきます。
| ベンチマーク | 作成者自身の研究 | 参照論文を渡さない | 文献調査の採点 | 執筆論文の採点 | 専門家ルーブリック | 決定論的検証器 | 失敗分析 |
|---|---|---|---|---|---|---|---|
| CritPt | ✓ | ✓ | × | × | × | ✓ | ✓ |
| Terminal-Bench-Science | ✓ | ✓ | × | × | × | ✓ | ◦ |
| ReplicationBench | ◦ | ◦ | × | × | ✓ | ✓ | ✓ |
| PRL-Bench | × | ✓ | × | × | ✓ | ✓ | ◦ |
| ResearchClawBench | × | ✓ | × | ✓ | ✓ | × | ◦ |
| PhySciBench | × | ✓ | ◦ | × | ✓ | ✓ | ◦ |
| FrontierPhysics | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
2. FrontierPhysicsのタスク設計
タスクの構成要素
エージェントへの入力とアクセス制限
各タスクは、研究プロジェクトの最初から最後までを再現するように作られています。エージェントが受け取るのは次の要素です。
- 大まかな指示(
task.md): PI(Principal Investigator: 研究室の主宰者)がプロジェクト開始時に出すような指示です。重要な問いや探索の方向が示されることはありますが、方法論や解き方は書かれていません。 - 補助ファイル(
environment/): 必要に応じて提供される入力データや装置シミュレータなどです。
なお、採点用のファイル(検証用の test_outputs.py、採点基準の rubric.json、参照解の solve.py)はエージェントからは見えません。元論文などの情報源へのアクセスもブロックされています。
求められる2種類の成果物
エージェントが提出する成果物は次の2種類です。
- 決定論的アーティファクト(deterministic artifacts)
計算した物理量、シミュレーション出力、処理済みデータなどをresult.mdにキーと値の形で書き出し、テストスクリプトで機械的に照合します。 - 論文原稿(
paper.pdf)
研究の背景、手法、結果、結論を査読論文の水準でまとめます。タスク実行中に得た証拠や計算結果を正しく反映していることが求められます。
2種類のルーブリック
ルーブリックには次の2種類があります。
- グローバルルーブリック(全タスク共通)
研究者としての基本動作を見ます。具体的には以下の項目を確認します。- 報酬ハッキング(reward hacking: 本来の目的を果たさずに評価指標だけを上げる行為)や幻覚(hallucination)がないか
- 文献をきちんと統合しているか
- 結果を検証しているか
- 主張を証拠で支えているか
- タスク固有ルーブリック(分野の専門家が作成)
物理の理解、科学的な見せ方、研究の遂行を評価します。タスク作成者が自分の研究について自分で設計するため、その研究をした本人でなければ書けない以下のような基準を盛り込めます。- 鍵となる文献を見つけて正しく使えたか
- 核心的なアイデアに自力でたどり着いたか
- 現実の実験制約を考慮したか
具体例: リュードベリ原子鎖の量子臨界点
タスクのテーマと設定
例題 rydberg-ising-critical-point を見ると、このベンチマークの難しさがよく分かります。
- テーマ: 1次元に並べたストロンチウム原子をリュードベリ状態(Rydberg state: 電子が非常に高い準位に励起された状態)に駆動したときの、無秩序相から秩序相への量子相転移
- 物理設定: レーザーのラビ周波数は \(\Omega = 2\pi \times 6\) MHzで固定され、デチューニング(detuning: レーザー周波数と共鳴周波数のずれ)\(\Delta\) を変えていくと、ある臨界値 \(\Delta_c\) で相転移が起こります。
2段階の課題
課題は次の2段階で構成されています。
- 装置の特性評価とモデル化
最大3原子しか扱えない装置シミュレータで少数原子の配置を試し、原子間相互作用を測ります。そのうえで鎖のモデルを組み、21原子と27原子の鎖について、中央の結合における秩序変数 \(\sigma_{\mathrm{mid}}\) を計算します。装置では大きな系を直接測れないので、約30原子まで必要な精度で計算できるシミュレーションを自分で用意しなければなりません。 - 臨界点の決定
いくつかの系サイズで \(\sigma_{\mathrm{mid}}\) を計算し、有限サイズスケーリング(finite-size scaling: 有限の系の計算結果から無限系の振る舞いを推定する手法)で \(\Delta_c\) を求めます。あわせて以下の値も報告します。- 7原子と11原子の再スケール因子の比
- 秩序変数の臨界指数の比 \(\beta/\nu\)
- \(\Delta_c\) の不確かさ
検証器のテストと物理的な難所
検証器のテストは10項目あり、たとえば以下の範囲で照合されます。
- 相互作用 \(V_2\): ±0.002 MHz
- \(\Delta_c\): ±0.010 MHz
- \(\beta/\nu\): \(1/8 \pm 0.01\)
ここで面白いのが、以下の2つのポイントです。どちらも文献を正しく読み込み、物理的な状況を見極めた人でなければ気づきにくい点となっています。
- 再スケール因子の比における境界効果
正解は \(0.956346 \pm 10^{-6}\) ですが、教科書どおりのバルク(無限系)の式で計算すると \((7/11)^{1/8} = 0.945068\) になり、不合格になります。開放境界の鎖では、境界の効果を取り込んだ別の因子 \(\sin(\pi/(L+2))^{-1/8}\) を使う必要があるからです。 - 高次補正を含めたハミルトニアン構築
この系では最近接相互作用 \(V_1\) が \(\Omega\) に比べてそれほど大きくありません。そのため、単純な有効模型(1次のPXP模型)では精度が足りず、Schrieffer–Wolff変換による2次の補正を入れたハミルトニアンが要ります。
ルーブリックの評価項目
ルーブリックには、合否を左右するブロッカーと、点数に効く非ブロッカーが設定されています。
- ブロッカーの例
- リュードベリ系の基本理解
- 普遍性クラス((1+1)次元イジング)と共形場理論の基礎
- 成果物がそろっていること
- 捏造・改ざん・報酬ハッキングがないこと
- 非ブロッカーの例
- ハミルトニアン構築(重み8)
- 外挿の質(重み8)
- 装置の較正(重み6)
- 文献による裏づけ(重み2)
物理の正しさと研究の作法の両方が細かく問われることが分かります。では、こうしたタスクはどうやって集められ、品質はどう保たれているのでしょうか。
3. タスクの収集と品質レビュー
複数段階の品質レビュー体制
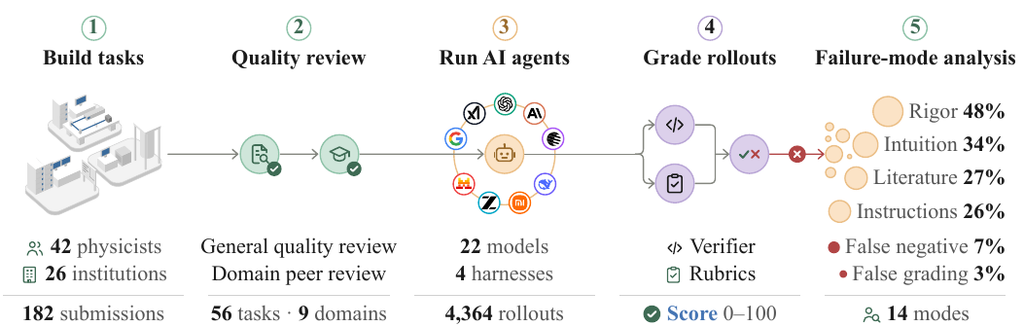
研究者自身にタスクを作ってもらう方式では、その品質をどう担保するかが肝になります。FrontierPhysicsでは、タスクが採用されるまでに以下の複数段階のレビューを通す仕組みが採られています。
① 一般品質レビュー
まず、タスクが本当に応募者自身の研究から来ているかを確かめます。
- 応募者は参照論文や特許のリンクを示し、プロジェクトの背景、研究の経緯、かかった時間を申告します。
- 元の研究には少なくとも2週間以上の作業が必要です。
task.mdとrubric.jsonが人間に読める形で、実際に人の手が入っているかを確認します。AIが生成しただけに見えるタスクは却下されます。
➁ ドメインピアレビュー
近い分野の研究者がタスクを査読します。レビュアーは自分のタスクが一般品質レビューを通った応募者から募っており、博士課程の学生が47%、博士号保持者が37%です。新しいレビュアーには1対1のオンボーディングがあり、最初のレビューは監査されて基準がそろえられます。
レビューのチェックリストは次の3観点です。
| 観点 | 確認すること | 防ぎたい問題 |
|---|---|---|
| 指示の過剰指定 | task.md に、有能な研究者なら自分で知っているか調べられるはずの知識が書かれていないか | タスクの自由度が下がり、研究力ではなく指示の実行力を測ってしまう |
| ルーブリックの質 | 研究を実際に進めた人しか持たない物理的洞察が rubric.json に入っているか | AI生成のルーブリックによくある、当たり障りのない低信号の基準 |
| 失敗モードの確認 | 作成者がSOTA(State of the Art: 最先端)エージェントで3回以上ローカル実行し、その失敗分析を検証する | 偽陽性・偽陰性。根拠のない数値許容誤差で正しい物理モデルを落とす、曖昧な指示でエージェントが誤解する、など |
③ 最終承認
すべてのチェックを通ると、異なる分野の背景を持つ物理学のPhD研究者6名による管理チームが最終承認します。
採択されたタスクの統計と内訳
レビューの結果、182件の応募から56件が採択されました。採択タスクの主な特徴は以下のとおりです。
- 作成者と分野: 26機関の42人で、作成者の被引用数は平均420です。以下の9分野にわたります。
- 物性物理
- AMO(原子・分子・光)物理
- 量子情報
- 宇宙物理
- 流体力学
- 統計物理
- フォトニクス・イメージング
- 高エネルギー物理
- 化学物理
- ベースとなった研究: 18タスクは作成者が共著者として発表済みの研究に基づいています。うち4件はNature掲載論文で、ほかにNature Communications、Physical Review Letters、Physical Review Xの論文も含まれます。元のプロジェクトにかかった期間は1タスクあたり平均約270日、合計で8,000時間を超えます。
- 入力データの種類:
- テーブル形式のデータ: 39%
- ドキュメント: 34%
- 信号・スペクトル: 32%
- ソースコード: 30%
- 画像・動画: 14% など
- 必要な研究活動(1つのタスクで複数の作業をこなす必要があります):
- 検証: 84%
- データ分析: 71%
- モデリング: 64%
- シミュレーション: 61%
- 導出・方法論・計画: それぞれ41%
4. 評価方法: 決定論的検証器とエージェントによる審査
検証器とAgent-as-judgeの組み合わせ
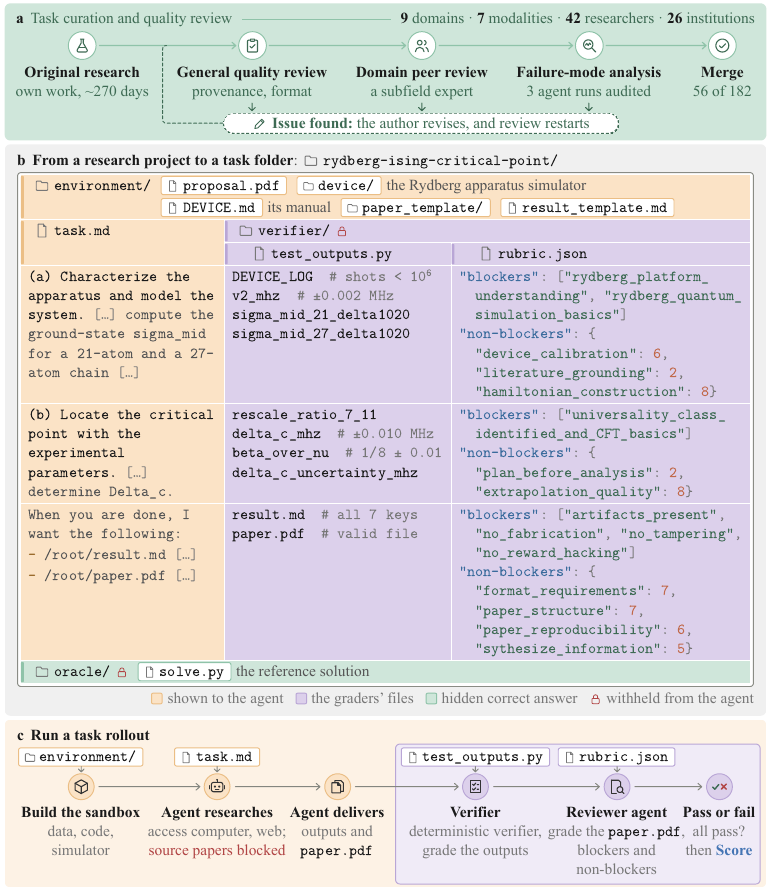
評価の狙いは、エージェントの結果が客観的に正しいかと、研究全体の質が高いかを同時に測ることです。そのために、プログラムによる決定論的検証器と、LLMエージェントを審査員にするAgent-as-judgeを組み合わせています。
採点の手順は次のとおりです。
- エージェントの作業が終わると、行動の記録(軌跡、trajectory)、検証器の結果、
paper.pdfを含む出力ファイルが保存され、別のサンドボックスにコピーされます。 - レビュアーエージェントが
rubric.jsonに沿って軌跡と論文を採点します。レビュアーは全ロールアウトで共通で、Codex CLI上のGPT-5.6 Sol(推論レベルxhigh)です。
1回のLLM呼び出しではなくエージェントに審査させる理由は、報酬ハッキング、結果の捏造、文献検索の質といった基準が paper.pdf を読むだけでは判定できないためです。軌跡、コード、出力ファイルと突き合わせて初めて分かります。たとえば論文に「シミュレーションで確認した」と書いてあっても、実際にそのコードが走ったかは軌跡を見なければ確かめられません。
ルーブリックの区分とスコア計算式
ルーブリックの基準は、コーディングエージェント向けベンチマークFrontierCodeの設計にならってブロッカーと非ブロッカーに分かれています。いずれの基準にもタスク作成者が1〜10の整数で重みを付けます。
- ブロッカー: 研究の科学的妥当性に欠かせない要件で、合格か不合格かの二値で判定されます。
- 非ブロッカー: 研究の質的な側面を表し、以下の3段階で採点されます。
0: 欠けている・誤り1: 部分的に満たす2: 完全に満たす
最終スコアは次の式で計算されます。
$$
S_{\mathrm{final}} =
\begin{cases}
\dfrac{\sum_{i\in\mathcal{N}} w_i s_i}{2\sum_{i\in\mathcal{N}} w_i} \times 100, & D = 1 \text{ かつ } b_j = 1 \ \\ \forall j \in \mathcal{B} \
0, & \text{それ以外}
\end{cases}
$$
記号の意味は次のとおりです。
- \(\mathcal{N}\): 非ブロッカー基準の集合、\(\mathcal{B}\): ブロッカー基準の集合
- \(s_i \in {0, 1, 2}\): 非ブロッカー \(i\) の得点、\(w_i\): その重み
- \(D\): 決定論的検証器の結果(全テスト通過で1)
- \(b_j\): ブロッカー \(j\) の判定(通過で1)
噛み砕くと、検証器のテストとブロッカーをすべて通過した場合だけ、非ブロッカーの重み付き達成率がスコアになるという仕組みです。分母に2を掛けているのは満点が2点だからで、全基準で2点を取れば100点になります。逆に、ゲートを1つでも落とせば0点です。ブロッカーの重みはメタデータとして残りますが、点数には使われません。
スコア設計が持つ2つの意味と合格の定義
この設計には次の2つの意味があります。
- 科学的妥当性のゲート化
論文の書き方がどれだけ上手でも、数値が間違っていたりブロッカーに落ちたりすれば挽回できません。\(S_{\mathrm{final}} = 0\) は「出版できない研究」を表します。 - 研究の質の段階的評価
数値がすべて正しくても、動機づけが弱い、根拠が足りない、伝え方が下手な論文は合格はしても低いスコアになります。例題のリュードベリ原子鎖タスクなら、10テストと7つのブロッカーをすべて通ったうえで、9つの重み付き基準で点数が決まります。
なお、記事で「合格(pass)」と書くときは、検証器の全テストとすべてのブロッカーを通過したことを指します。
- Pass@1: 3回の試行の平均合格率
- Pass@3: 3回中1回以上合格したタスクの割合
5. 実験設定と結果
実験設定
評価対象モデルとエージェントハーネス
評価対象は22のフロンティアモデルで、4種類のエージェントハーネス(harness: モデルにツール実行やファイル操作の環境を与える実行基盤)で動かしています。
- Codex CLI: GPTモデル
- Claude Code CLI: Claudeモデル、および残り7モデル(DeepSeek V4 Pro、DeepSeek V4.1 Flash、GLM-5.3、Kimi K3、Kimi K3.1 Pro、MiMo V2.6 Pro、Mistral Large 4)
- Grok Build: Grokモデル
- Antigravity CLI: Geminiモデル
各モデルは利用できる最高の推論レベルで56タスクを3回ずつ解きます。GPTの4モデルは推論レベルxhighでも実行しているため、合計26構成、各構成168ロールアウト、全体で4,364ロールアウトになります。
実行環境と制限
実行環境はクラウドのサンドボックスで、条件は以下のとおりです。
- 計算リソース: 4 vCPU・16GB RAM・10GBストレージ以内のタスクはDaytona上で、それを超えるタスクはAzure VM上のDockerで動かし、Lambda API経由でGPUも使えるようにしています。
- 実行管理: 実験の実行と記録にはBenchFlow CLIが使われています。
- 制限時間: 1ロールアウトの上限は10時間です。
- エラー時の扱い: 予算切れやメモリ枯渇などモデル側の原因で終わったものは失敗として数え、サンドボックスの消失などインフラ側の原因によるものは再実行します。
全体結果
モデル別の合格率とスコア
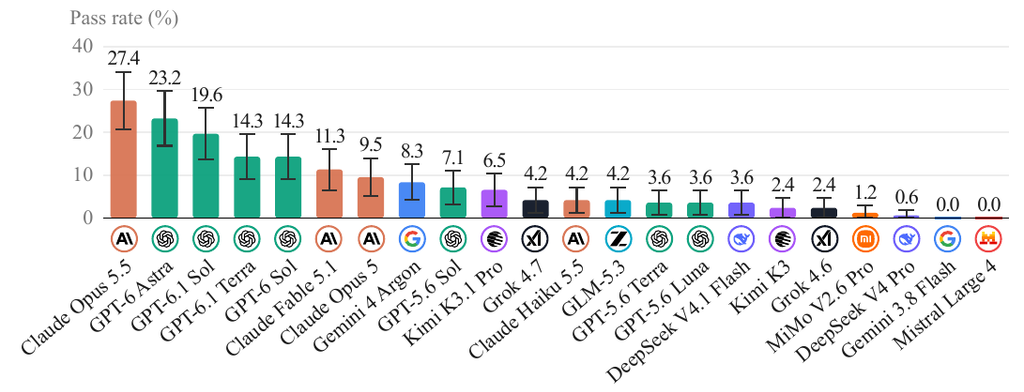
全構成で合格率は30%未満でした。上位と下位の構成は次のとおりです。
| モデル(ハーネス) | 総合 Pass@1 | 総合 Pass@3 | 検証器のみ Pass@1 | スコア |
|---|---|---|---|---|
| Claude Opus 5.5(Claude Code) | 27.4% | 44.6% | 45.8% | 26.0 |
| GPT-6 Astra max(Codex) | 23.2% | 30.4% | 39.3% | 21.8 |
| GPT-6 Astra xhigh(Codex) | 19.6% | 30.4% | 38.7% | 18.0 |
| GPT-6.1 Sol(Codex) | 19.6% | 30.4% | 33.3% | 18.4 |
| GPT-6.1 Terra(Codex) | 14.3% | 21.4% | 28.6% | 12.6 |
| GPT-6 Sol(Codex) | 14.3% | 28.6% | 27.4% | 12.5 |
| Claude Fable 5.1(Claude Code) | 11.3% | 21.4% | 31.0% | 10.2 |
| Claude Opus 5(Claude Code) | 9.5% | 17.9% | 20.2% | 8.6 |
| Gemini 4 Argon(Antigravity) | 8.3% | 17.9% | 31.5% | 6.5 |
| … | … | … | … | … |
| Gemini 3.8 Flash(Antigravity) | 0.0% | 0.0% | 7.7% | 0.0 |
| Mistral Large 4(Claude Code) | 0.0% | 0.0% | 5.4% | 0.0 |
検証器合格率と総合合格率の乖離
注目したいのは、検証器だけの合格率とブロッカー込みの総合合格率の差です。
- Claude Opus 5.5: 数値の検証だけなら45.8%通っていますが、ルーブリックのブロッカーまで含めると27.4%に下がります。
- Gemini 4 Argon: 検証器で31.5%通っているのに、総合では8.3%です。
数値が合っていても、研究として必要な条件を満たしていないロールアウトがかなりあることが分かります。
統計的なばらつき
統計的なばらつきにも気を配る必要があります。同じタスクの3回の試行は互いに相関するとして、タスク単位のブートストラップ(10,000回の再サンプリング)で95%信頼区間が算出されています。
- Claude Opus 5.5の合格率27.4%の信頼区間は [17.9, 36.9] とかなり広く、GPT-6 Astra(max、xhigh)とGPT-6.1 SolはOpus 5.5と統計的に区別できません。
- 3回とも合格したタスクの数は、Opus 5.5が8、GPT-6 Astra(max)が9で、ここではむしろGPT-6 Astraがわずかに上回ります。
順位の小さな差を読み込みすぎないほうがよさそうです。
コスト・実行時間と合格率
一般的には、1ロールアウトあたりのコストが高いモデルほど合格率も高い傾向があります。ただし例外もあり、GPT系はコスト効率が良い結果となっています。
| モデル | 平均コスト/ロールアウト | 平均実行時間 | 総合 Pass@1 |
|---|---|---|---|
| Claude Opus 5.5 | 26.95ドル | 2.44時間 | 27.4% |
| GPT-6 Astra(max) | 26.91ドル | 1.73時間 | 23.2% |
| GPT-6 Astra(xhigh) | 19.21ドル | 1.24時間 | 19.6% |
| GPT-6.1 Sol | 5.33ドル | 1.79時間 | 19.6% |
| GPT-6.1 Terra | 3.46ドル | 1.14時間 | 14.3% |
| Claude Fable 5.1 | 32.63ドル | 1.87時間 | 11.3% |
| Claude Opus 5 | 56.77ドル | 2.40時間 | 9.5% |
- GPTモデルのコスト効率: GPT-6.1 SolはGPT-6 Astra(xhigh)と同じ19.6%を、4分の1ほどのコストで出しています。
- Claudeモデルにおける逆転現象: Opus 5.5(26.95ドル)、Fable 5.1(32.63ドル)、Opus 5(56.77ドル)とコストが上がるほど合格率が下がっています。
高価なモデルや高い推論レベルが常に良い結果につながるわけではない、という点は実務でも覚えておきたいところです。
分野別・研究モード別の結果
最上位のOpus 5.5とGPT-6 Astraについて、分野ごとおよび研究モードごとの合格率は次のとおりです。
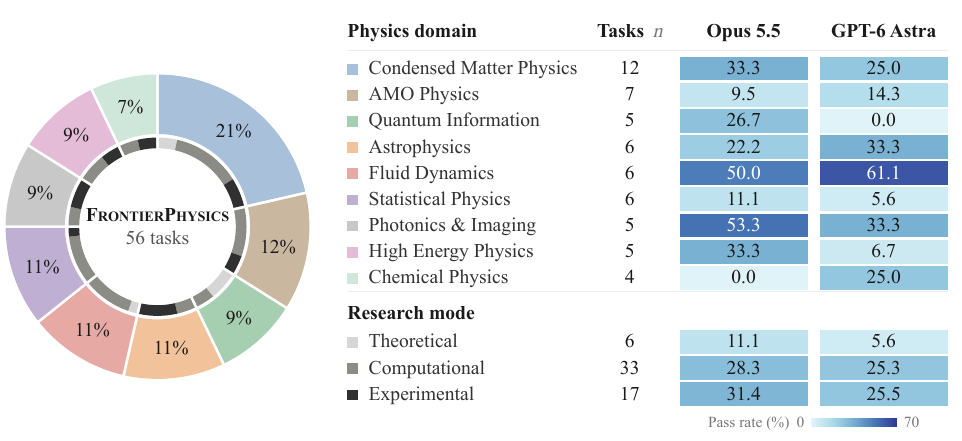
- 分野別の傾向と注意点: 量子情報ではOpus 5.5が26.7%に対してGPT-6 Astraは0.0%、化学物理では逆にOpus 5.5が0.0%でGPT-6 Astraが25.0%と、モデルによって得意分野が入れ替わっているように見えます。とはいえ、1分野あたりのタスクは4〜12件しかなく、分野間の差は不確かである点に注意が必要です。
- 研究モード別の傾向: 理論タスクの合格率が両モデルとも低めですが、ここでもタスク数は6件だけです。
結果を見て次に気になるのは、「その採点はそもそも正しいのか」という点です。この問いについても詳しく検証されています。
6. 評価器の信頼性
3段階の確認プロセス
レビューを通しても、検証器やルーブリックに欠陥が残る可能性はあります。特に警戒されているのは、合格率を下げるために検証器やルーブリックを敵対的に作り込み、人間の専門家の正しい解答まで落ちてしまうケースです。これを抑えるため、次の3段階の確認プロセスが導入されています。
- 作成者による失敗モードレポート
各タスクの作成者が、分析開始時点で単一エージェントのハーネスでは最も成績が良かったGPT-6 Astraの3ロールアウトについて、軌跡と出力ファイルを確認し、どこでなぜ失敗したかを報告します。 - 管理チームによる再確認
管理チームがそのレポートを軌跡と出力ファイルに照らして検証します。約60ロールアウトを見たところで、繰り返し現れる失敗を分類体系にまとめました。 - 作成者自身の論文による検証
作成者の論文や原稿を参照資料として採点環境に入れ、同じレビュアーエージェントと同じルーブリックで採点します。
偽陰性の発見と補正
2段階目の確認では、正しい結果を出したのに検証器かレビュアーに落とされた偽陰性が見つかっています。
- 発見された件数: GPT-6 Astraの168ロールアウトのうち9件が誤って不合格とされていました(内訳は、タスク設計の問題による偽陰性8件と、レビュアーの誤採点1件)。
- 補正後の合格率: これを補正すると、合格率は14.9%(25/168)から20.2%(34/168)に上がります。
- 背景と対応: この結果は、専門家が既存ベンチマークを再採点し、失敗の多くが採点ミス、誤った参照解、曖昧な問題文によるものだったとする最近の研究とも一致します。偽陰性を見つけるには専門知識と時間が必要ですが、ベンチマークの品質を保つうえでは欠かせません。見つかった設計上の問題は修正され、影響を受けた結果は再実行・再採点されています。
作成者自身の論文によるルーブリック検証
非ブロッカーの採点は主観が入りやすく、検証もより難しくなります。そこで3段階目として、作成者の論文がある33タスクで、その論文自体をルーブリックで採点しました。
- 平均スコア: 96.2% となり、ルーブリックが人間の専門家の成果物と整合していることが示されました。
- 例外ケース: すべてが満点だったわけではなく、作成者の原論文でもブロッカーを落としたタスクが3件ありました(そのうち1件は3つのブロッカー中2つだけ通過)。また、
glass-nonequilibrium-landscape-evolutionの原論文は50%、metallic-glass-pel-ruggednessは72.73%にとどまりました。ルーブリックがタスク用に書かれた成果物の形式を前提にしているため、元の論文とは評価軸がずれる部分もあると考えられます。
レビュアーを替えた再採点と自己選好バイアス
もう一つの重要な検証が、レビュアーを替えた再採点です。初回の評価結果を、デフォルトのGPT-5.6 SolとClaude Opus 5.5の両方に同じルーブリックで採点させました。
| 採点対象のロールアウト | レビュアー | 合格数 | 検証器通過分での一致 | Cohenのκ | 片方だけ合格 |
|---|---|---|---|---|---|
| GPT-6 Astra(xhigh) | GPT-5.6 Sol | 25 | 48/53 | 0.81 | Opusのみ3、Solのみ2 |
| GPT-6 Astra(xhigh) | Claude Opus 5.5 | 26 | 〃 | 〃 | 〃 |
| Claude Opus 5.5 | GPT-5.6 Sol | 37 | 58/67 | 0.72 | Opusのみ8、Solのみ1 |
| Claude Opus 5.5 | Claude Opus 5.5(自己採点) | 44 | 〃 | 〃 | 〃 |
Cohenの\(\kappa\)(カッパ係数: 偶然の一致を差し引いた2者間の一致度)は、GPT-6 Astraのロールアウトでは0.81と高い値です。ところが、Opus 5.5が自分のモデルファミリーのロールアウトを採点すると、合格数は37件から44件に増え、「Opusだけが合格と判定」したものが8件ありました。
レビュアーエージェントは自分のファミリーのモデルに甘くなるという自己選好バイアスが、数字ではっきり出ています。Agent-as-judgeを使う場合、被評価モデルとは別系統のモデルをレビュアーにする理由がここにあります。
7. 失敗モード分析: エージェントがつまずく箇所
失敗モードの内訳
採点の信頼性を確かめたうえで、「エージェントはなぜ失敗するのか」が詳しく分析されています。対象はGPT-6 Astra(xhigh)の168ロールアウトのうち不合格だった143件で、1件に複数の失敗タグを付けられます。
| 失敗モード | ラベル | 割合(件数) | 内容 |
|---|---|---|---|
| 厳密な思考の欠如 | RIG | 48%(68) | 循環的な自己検証、エッジケースの考慮不足 |
| 専門家の直感の欠如 | INT | 34%(48) | 何が重要かを見極められない |
| 文献の誤り | LIT | 27%(39) | 鍵となる文献を見つけられない、文献で主張を支えられない |
| 指示追従の失敗 | INS | 26%(37) | 指示の見落とし・誤解 |
| 物理の誤り | PHY | 16%(23) | 式や理論の細かな誤り、知識の欠如 |
| 現実の制約の見落とし | REAL | 10%(15) | 装置の現実的な制約を理解していない |
| 支離滅裂な推論 | COH | 6%(9) | 矛盾する論理展開 |
| 実行ミス | EXE | 4%(6) | コードやツールを正しく扱えない |
| 科学的な見せ方 | SP | 2%(3) | 理解はしているが論文として発表できる水準にない |
| 幻覚 | HAL | 1%(2) | 証拠・データ・文献の捏造 |
| 偽陰性 | FALSE | 7%(10) | 正しくできているのにタスク設計の問題で不合格 |
| 誤採点 | RRMIS | 3%(4) | レビュアーエージェントの採点が人間の判断と食い違う |
物理のベンチマークでありながら、物理の誤り(16%)や実行ミス(4%)は主な失敗原因ではありません。上位を占めるのは以下の3つです。
- 厳密に考えること: 48%
- 物理的な直感で判断すること: 34%
- 文献を統合すること: 27%
代表的な失敗パターンの具体例
厳密な思考の欠如(48%)
- 循環的な自己検証: エージェントが自分の結果を検証するときに、検証方法そのものが自分の誤った仮定に依存していると、何度確かめても誤りに気づけません。例題のリュードベリ原子鎖タスクでも、まさにこの失敗が観察されています。
- エッジケースの見落とし: 手法やコードが限られた条件でしか動かず、隠しテストで落ちるパターンです。
専門家の直感の欠如(34%)
- 重要な誤差要因の見落とし: 例題では、AMO物理の研究者なら当然考えるリュードベリ状態の崩壊を、誤差要因の分析でエージェントが考慮しませんでした。これは知識がないからではなく、何が重要かを見極める専門家の勘がないからだと分析されています。
- 見当違いなデバッグ: デバッグで問題の根本に気づかず、見当違いのパラメータを延々と調整し続けるケースもこの分類に入ります。
指示追従の失敗(26%)と支離滅裂な推論(6%)
- 暗黙のメッセージの読み取り不足(指示追従の失敗): 要件の見落としや誤解です。例題では、「最近接リュードベリ・ブロッケード領域で作業する」という一文が、ハミルトニアンを近似するか、ブロッケードを破る試行をポストセレクション(postselection: 条件を満たす測定結果だけを残す処理)で除くべきことを意味しているのに、エージェントはそれを読み取れませんでした。作成者からすれば同じ分野の専門家には明らかな指示でも、エージェントには暗黙のメッセージが伝わらないことがあります。
- 支離滅裂な推論: 一度は自分の誤りに気づいたのに、後でそれを忘れてしまうケースが挙がっています。
検証器とルーブリックが捕捉する失敗の違い
失敗が検証器とルーブリックのどちらで捕まったかの内訳は次のとおりです。
- 厳密さの欠如: 検証器だけ、または検証器とブロッカーの両方で捕まるものが大半で、ブロッカーだけで捕まるものはごくわずかです。
- 直感の欠如・文献の誤り・物理の誤り: 数値は通ったのにブロッカーで落ちた例も一定数あります。
- 科学的な見せ方の失敗: すべてブロッカーだけで捕まっています。
このように、数値検証とルーブリックはそれぞれ別の種類の失敗を拾っています。
失敗モード分析の限界
この分析には以下の限界もあります。
- 対象はGPT-6 Astraだけです。サブエージェントを使う軌跡は人手で読むのが難しいことがその理由です。
- ほかのモデルやハーネスの組み合わせは、別の失敗の仕方をする可能性があり、この分類に収まらない失敗もありえます。
- 同じ理由で、偽陰性を正確に補正できたのもGPT-6 Astraだけです。
8. エージェント開発・評価への示唆
開発・評価における6つの実践ポイント
ここまでの結果を、エージェントを作る側・評価する側の視点で整理します。直接提案されている点と結果から読み取れる点を合わせると、次のようになります。
- 数値検証とルーブリックを組み合わせる
検証器で数値が通っても、ブロッカーで落ちるロールアウトはかなりありました(Opus 5.5で45.8%→27.4%)。最終出力の正解判定だけでは「答えは合っているが研究としては無効」なものを見逃します。科学的妥当性に欠かせない条件はブロッカーとしてゲート化し、質の評価とは分けて扱うのが有効です。 - 審査員エージェントは別系統にする
Opus 5.5が自分のファミリーを採点すると合格が37件から44件に増えました。Agent-as-judgeを使うなら、被評価モデルと異なるファミリーのレビュアーを使うか、複数のレビュアーで一致率(κ)を確認すると安心です。 - 偽陰性を前提に人のレビューを残す
168件中9件が誤って不合格でした。自動採点だけでモデルの優劣を決めると、合格率を数ポイント単位で過小評価するおそれがあります。ドメインの専門家による軌跡レビューは手間がかかりますが、省けない工程です。 - 検証を自分の仮定から切り離す
最大の失敗原因は循環的な自己検証でした。エージェントの設計では、自分の手法とは独立した方法で検算する、別の仮定で結果を再導出する、といった仕組みを組み込む余地があります。 - 文献探索と暗黙の指示の解釈を鍛える
文献の誤り(27%)と指示追従の失敗(26%)も大きな割合を占めます。鍵となる文献を見つけて研究の動機づけに使う力や、分野の常識を前提にした指示を読み解く力は、知識の量とは別に強化が必要な能力だといえます。 - コストと性能は単調ではない
ClaudeモデルではOpus 5(56.77ドル)がOpus 5.5(26.95ドル)より合格率が低く、GPT-6.1 Solは5ドル台で上位と統計的に並びます。推論レベルや予算を上げれば解決するとは限りません。
ベンチマークのトレードオフ
一方で、このベンチマークのトレードオフも押さえておく必要があります。
- タスク規模と統計的余裕: 56タスクという規模は、研究者本人の研究に根ざした高品質なタスクを集めた結果ですが、分野別の比較や構成間の細かな順位づけには統計的な余裕がありません。
- 評価コストと実行時間: 1ロールアウトに数十ドル、数時間かかるので、気軽に回せる評価ではありません。
- 採点基準とレビュアーへの依存: ルーブリック採点はレビュアーエージェントの性能とバイアスに依存しますし、作成者自身の論文でもブロッカーに落ちる例があったように、採点基準が完全とはいえません。
おわりに
FrontierPhysicsは、42人の物理学者が自分の研究から作った56タスクで、AIエージェントが文献調査から論文執筆までの研究プロセス全体をこなせるかを測るベンチマークです。決定論的検証器と専門家のルーブリック、エージェントによる審査を組み合わせ、「結果が正しいか」と「論文として通用するか」を同時に評価します。22モデル・26構成を評価したところ、最高のClaude Opus 5.5でも合格は168回中46回(27.4%)で、エンドツーエンドの研究はいまのエージェントにとってまだ難しい課題だと示されました。失敗の主因は物理の知識不足や実行ミスではなく、循環的な自己検証に代表される厳密さの欠如と、専門家としての直感の不足だと結論づけられています。
実務的には、エージェントを研究や高度な技術業務に使う場合、最終出力の数値チェックだけでなく、軌跡まで見て「どう考えてその結論に至ったか」を確認する工程が欠かせません。評価を自動化する場合も、審査員モデルの自己選好バイアスや偽陰性を前提に、別系統のレビュアーや人による抜き取り確認を組み合わせるのが現実的です。モデル選びでは、コストの高いモデルや高い推論レベルが常に良い結果を出すわけではない点も参考になります。
今後の方向としては、具体的なタスクを与えるだけでなく、高レベルの方針だけを受けて問題設定から新しい発見までを自律的に探究するエージェントが挙げられています。そうしたエージェントを訓練・評価するには、より開かれた研究タスクと、探索的な推論、部分的な前進、予期しない発見まで評価できる柔軟な評価枠組みが必要です。現時点はv0.1で、タスク数の拡大や失敗分析の対象モデルを広げることも、今後の課題になりそうです。
More Information
- arXiv:2611.06910, Bingran You, Wenjun Ke, Ria Rosenauer, Bo Liu, et al., 「FrontierPhysics: Evaluating Agents for End-to-End Physics Research」, https://arxiv.org/abs/2611.06910
関連記事
宇宙物理学研究の新たなパラダイム: AIサイエンティストと Human-in-the-Loop
現代の宇宙物理学におけるデータ解析は、データ表現やモデルの構造、最適化戦略といった高次元の「方法論的設計空間」を人間が網羅的に探索することが困難になっています。そのため、大規模言語モデル(LLM)を活用した自律型エージェ […]

The Multimodal Universe: 天文学向け大規模機械学習用ビッグデータ
天文学は、その観測対象の広大さと複雑さから、常に膨大なデータを扱う分野です。近年、技術の進歩に伴い、画像、スペクトル、時系列データなど、多種多様な形式のデータが取得できるようになりました。これらのデータを統合的に解析する […]
AstroGenesis: 天体物理学研究を加速させるマルチエージェントAIフレームワーク
天体物理学の観測環境は、この十数年で劇的に変化しました。LSST、Gaia、Euclid、DESIといった大規模サーベイに加え、重力波やニュートリノを含むマルチメッセンジャー観測網が整備されたことで、電波からγ線までの電 […]