AstroGenesis: 天体物理学研究を加速させるマルチエージェントAIフレームワーク
天体物理学の観測環境は、この十数年で劇的に変化しました。LSST、Gaia、Euclid、DESIといった大規模サーベイに加え、重力波やニュートリノを含むマルチメッセンジャー観測網が整備されたことで、電波からγ線までの電磁波全域、さらにはその外側の観測チャネルにまたがる、大量かつ異種混淆のデータが日々生み出されています。
一方で、こうしたデータを解釈するには、装置ごとに異なるデータ形式や観測タイミングをまたいだ分析が欠かせません。研究者は文献調査、観測データの取得・前処理、統計解析、理論モデリングといった作業を、互いに連携していないアーカイブやソフトウェアパッケージ、自作スクリプトの間で手作業でつなぎ合わせているのが実情です。加えて、天体物理学分野の論文数自体も年々増加しており、専門分野内の最新動向を追い続けることさえ難しくなりつつあります。
こうした背景のもと、ブレーザー研究に特化したマルチエージェントAIフレームワーク「AstroGenesis」が提案されています。文献検索、多波長観測データの取得・解析、理論モデリング、研究アイデアの生成までを単一の対話環境に統合し、Supervisor Agent(監督エージェント)とPlanner/Replannerが専門特化した複数のAIエージェントを調整する構成を採っている点が特徴です。
汎用の大規模言語モデルを単純に科学研究へ適用するだけでは、観測データベースとの接続や結果の再現性・トレーサビリティの確保が難しいという課題があります。この課題に対する具体的な設計上の解答として、AstroGenesisのアーキテクチャが設計されています。
今回は、AstroGenesisの全体アーキテクチャと各専門エージェントの仕組みを整理した上で、文献検索エンジンの性能を検証したベンチマーク結果、観測データ解析や理論モデリングの実例、システムを支える実装基盤、そして現時点での限界について解説します。
1. 天体物理学研究が抱える構造的課題
観測データの多様性と解析における障壁
高エネルギー天体物理学、とりわけ変動天体・突発天体・マルチメッセンジャー現象の研究では、感度・観測頻度・データ形式が全く異なる装置群から得られる観測を組み合わせる必要があります。対象となるデータは多岐にわたります。
- 電波、光赤外、X線、γ線といった電磁波全域のデータ
- ニュートリノや重力波などのマルチメッセンジャーデータ
こうした天体の多くは秒単位から年単位まで様々なタイムスケールで変動するため、放射機構の解釈は「どの時間帯のどの観測を使うか」という時間的な選定と装置間の調整に強く依存します。
フレアや突発的な増光の即時的な調査は、追観測の計画や、粒子加速・輻射過程・相対論的アウトフローといった理論的シナリオの検証のために不可欠です。しかし、以下の要因がこの調査をさらに難しくしています。
- 理論モデリングツールへのアクセスが限られていること
- パラメータ空間の探索や統計的フィッティングに要する計算コストが高いこと
要素技術の分散と統合プラットフォームの不在
研究ワークフローを構成する要素技術は、すでに個別に存在しています。
- ADS(Astrophysics Data System)のような文献データベース
- Virtual Observatoryのツール群
- 検索拡張生成(RAG: Retrieval-Augmented Generation)システム
- SSCやEICモデリング向けの専門フレームワーク
しかし、文献の推論、科学的に利用可能な形に整えられた観測データへのアクセス、理論モデリング、研究アイデアの生成を一つの統合環境で提供するプラットフォームはこれまで存在しませんでした。
マルチエージェントアーキテクチャが有効な理由
ここでマルチエージェントアーキテクチャが有効とされる理由は、単一のモデルにすべてのタスクを担わせるのではなく、タスクを専門エージェントへ分担させる点にあります。
- タスクの分担: 文献検索、観測データアクセス、理論モデリング、仮説生成をそれぞれ専門のエージェントが担当します。
- 監督機構の調整: 監督機構が全体のタスク実行と情報交換を調整します。
これにより、モジュール性とタスク特化が実現され、中間出力を評価・改善しながら次の段階へ伝播させる反復的な推論が可能になります。天体物理学のように、科学的解釈が複数の相互接続された操作に依存する分野では、こうした性質が特に重要とされています。
2. AstroGenesisの全体アーキテクチャ
システムの基本構成と処理の流れ
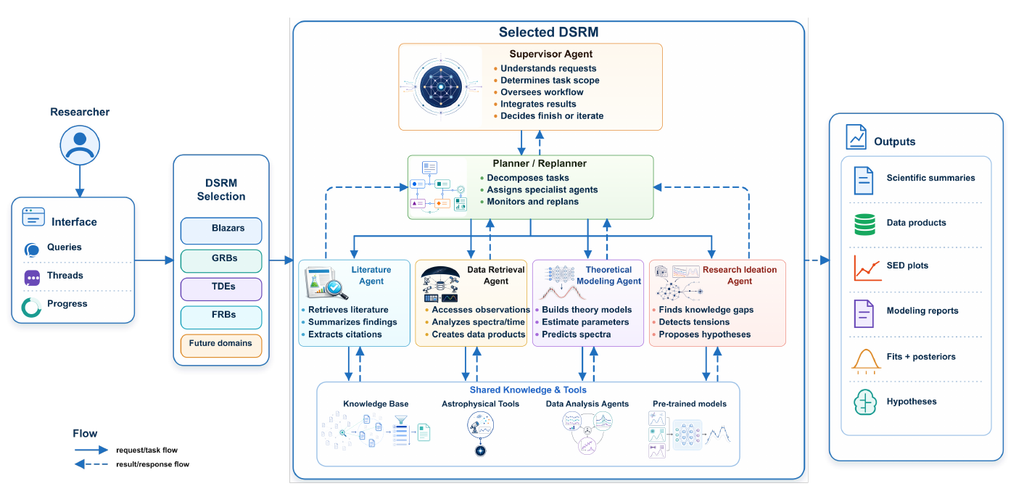
AstroGenesisは、ユーザー向けのチャットボットインターフェースと、対象天体クラスごとに用意されたDomain-Specific Research Module(DSRM: ドメイン特化型リサーチモジュール)群から構成されています。
- クラス選択: ユーザーがブレーザー、GRB(ガンマ線バースト)、TDE(潮汐破壊現象)などの対象クラスを選択すると、対応するDSRMが起動します。
- リソースの提供: その天体クラスに特化したデータ資源、モデリングフレームワーク、知識ベースへのアクセスが提供されます。
- エージェント間の協調: 選択されたDSRMの内部で複数の専門エージェントが協調し、情報の検索、データの解析、理論モデリングの実施、科学的な出力の生成を行います。
- 結果の統合と返却: 生成された科学的出力が統合され、チャットボットインターフェース経由でユーザーへ返されます。
なお、現時点で完全に実装されているのはブレーザー向けのDSRMのみであり、GRBやTDEなど他の天体クラス向けのDSRMは開発中とされています。
ドメイン分離設計の理由とシステムの位置づけ
DSRMがドメインごとに独立したマルチエージェントシステムとして設計されているのには、明確な理由があります。
- ドメイン間干渉の低減: ドメイン間の干渉を減らし、各エージェントがそのドメインに固有の仮定、モデリング手法、専門用語、観測上の制約に依拠できるようにします。
- 検索精度と一貫性の維持: ドメインごとに知識ベース、ベクトル空間、解析パイプラインを分離することで、検索結果の焦点を絞り込み、意味的な関連性と科学的な一貫性を保ちやすくなります。
- 高い拡張性: 既存モジュールのロジックや性能を変更することなく、新しいDSRMを追加できます。
ただし、この点については重要な留保があります。DSRMや個々のエージェントは「自律的な科学的実体」ではなく、あくまで事前に定義されたワークフローに従って動くソフトウェアのオーケストレーション構造です。その出力は、埋め込みに基づく類似度検索、ルールベースの検証、通常の統計的手法、事前学習済みサロゲートモデル、あるいはベイズ推論といった計算手続きに条件づけられた結果として解釈されるべきであり、研究者による科学的な検証の対象であり続けるという位置づけになっています。
DSRMを構成する6つのコンポーネント
DSRMの内部構成を担うのは、次の6つのコンポーネントです。
| コンポーネント | 主な役割 |
|---|---|
| Supervisor Agent | ワークフロー全体を統括し、ユーザーの問い合わせに応じて適切な専門エージェントへタスクを割り振る |
| Planner / Replanner | リクエストを実行可能な手順へ分解し(Planner)、実行結果を評価して計画を更新・再計画する(Replanner) |
| Literature Agent | RAGパイプラインに基づき、関連する科学論文を検索・要約する |
| Data Retrieval Agent | 公開アーカイブから観測データを取得し、可視化可能な形式に整える |
| Theoretical Modeling Agent | 事前学習済みサロゲートモデルを用いて理論スペクトルの生成やSEDのフィッティングを実施する |
| Research Ideation Agent | 文献と観測データを組み合わせ、新しい研究テーマの候補を提示する |
ワークフローを制御するエージェント群の詳細
Supervisor Agentの仕様と役割
- 採用モデルとパラメータ: gpt-5.6-lunaが採用されており、応答のばらつきを制御するtemperatureパラメータは0.7に固定されています。これは、あいまいで不完全なユーザーの問い合わせに対しても適度な柔軟性を持たせるための設定です。
- ルーティング判断: Pydanticによる構造化出力のスキーマ(AgentRouting)に基づいて行われます。各判断には選択先のエージェント、その理由、必要に応じた最終応答が含まれます。
- 応答の検証と統合: 専門エージェントからの応答が返ってきた後、Supervisor Agentはその完全性と整合性を検証します。そして、文献の引用やデータセットの識別子などの出典情報を保持したまま、ユーザー向けの単一の応答へ統合します。
- エラー処理の仕組み: サブエージェントが失敗した場合には、パラメータを変えて再試行する、別のエージェントへ振り替える、あるいはユーザーへ確認を求めるといったフォールバック機構が備わっています。
Planner AgentとReplanner Agentの役割分担
両エージェントの役割は明確に分かれています。
- Planner Agent: ユーザーの科学的な目的を分析し、それを順序立てられたタスクキューへ変換する初期分解を担当します。
- Replanner Agent: 個々のエージェントがタスクを完了した後にその出力を評価し、実行計画を更新します。後続のステップを当初どおり進めるべきか、修正が必要かを判断する、実行中の適応的な制御を担当します。
3. 文献検索エンジンLiterature Agentの設計
Literature Agentは、RAGの枠組みに基づいてユーザーの問い合わせに関連する科学論文を特定・要約するコンポーネントです。
知識ベースの構築とデータ前処理
- 文献の収集: 知識ベースの構築段階では、ADSのAPIをブレーザー研究に関連するキーワード(例えば”galaxies: active”や”BL Lacertae objects: general”など)で検索し、査読付きの天文学・物理学ジャーナルに限定して論文を収集しています。2026年8月24日時点で、この手順により約21,241本の論文から成るコーパスが構築されました。
- テキスト変換とクリーニング: ダウンロードされたPDFは、DeepSeek OCRと呼ばれる視覚言語モデルのフレームワークによって構造化テキストへ変換されます。その後、ルールベースの処理とLLM支援によるクリーニングを経て、謝辞や参考文献リストといった非科学的な部分が除去されます。なお、Introductionセクションは特定の技術的詳細よりも一般的な文脈の説明が中心になりがちであるため、埋め込み対象からは意図的に除外されています。
- チャンク分割とベクトル格納: クリーニング済みの本文は5,000文字・200文字のオーバーラップでチャンクに分割され、OpenAIのtext-embedding-3-smallモデルによって1,536次元のベクトルへ埋め込まれた上で、ベクトルデータベースのWeaviateに格納されます。全文チャンク用のデータベースに加えて、抄録のみを対象にした補助的なデータベースも別途構築されています。
4段階の検索パイプライン
実際の検索は、次の4段階のパイプラインで進みます。
- ハイブリッド密-疎検索(hybrid dense-sparse search):
意味的類似度を捉える密ベクトル検索と、語彙的な一致を捉えるBM25(疎検索)を組み合わせ、上位1,200件の全文チャンクを取得します。密検索の寄与度を\(\alpha\)としたときの重みは\(\alpha = 0.8\)です。同一論文由来のチャンクはbibcode(文献識別子)ごとに集約され、各論文はその中の最大スコアで代表されます。 - 引用グラフ展開(citation-graph expansion):
上位25論文をピボットとして、それぞれが引用する文献と、それを引用する後続文献の両方を候補に加えます。これにより、クエリと直接的な意味的・語彙的類似性を持たない文献でも、科学的につながりのある研究を候補集合に含められるようにしています。 - cross-encoderによる再評価:
cross-encoder(交差符号化器)は、クエリと文書のペアを同時に読み込んで関連度を直接判定するモデルです。各候補論文の抄録とクエリをcross-encoder/ms-marco-MiniLM-L6-v2モデルで同時に処理し、密検索やBM25とは独立した関連度スコアを追加で得ます。 - 多信号のスコア融合:
密検索、BM25、cross-encoderの3種類のスコアをそれぞれ平均・標準偏差でz-score標準化した上で、重み付き和として合成します。採用されている算出式は以下のとおりです。
$$S_{fusion}(d) = w_{vec},z_{vec}(d) + w_{BM25},z_{BM25}(d) + w_{CE},z_{CE}(d)$$
実際に使われている重みは\((w_{vec}, w_{BM25}, w_{CE}) = (1, 1, 2)\)です。密検索とBM25の2倍の重みをcross-encoderに与えているのは、単なる意味的・語彙的な近さだけでは拾いきれない関連性の判断を、cross-encoderによる直接的な query-document 比較で補うという設計意図によるものです。
公開年の補正と出力
スコア算出後、公開年の新しいものをわずかに優遇する補正項が最終スコアに乗じられます。ただし、その寄与度は\(\epsilon = 0.1\)と小さく抑えられ、半減期に相当する時定数も\(\tau = 5\)年に設定されており、あくまで補助的な役割にとどまるよう設計されています。
この一連の処理を経て、最終的に上位5論文がLiterature Agentへの科学的根拠として供給され、Supervisor Agentへ返されます。
4. 文献検索ベンチマークが示す性能と課題
2種類の評価ベンチマークの設計
文献検索の信頼性を検証するため、性質の異なる2種類のベンチマークが構築されています。
- 単一論文ベンチマーク:
1つの設問に対して1本の正解論文が存在するように設計されています。抄録を除いた本文から証拠となる記述を抽出し、GPT系モデルに設問を生成させました。その後、タイトル・著者名との重複度チェックやLLMによる自己審査を経て247問に絞り込まれ、最終的に209問がLiterature Agentへ実際にルーティングされて評価対象となりました。 - 複数論文ベンチマーク:
1つの設問に対して複数の文献から得られる証拠の統合が必要になるよう設計されています。少なくとも2つの異なる引用を含む文章を出発点として設問が生成されました。
複数論文ベンチマークにおける正解データの厳格化
複数論文ベンチマークでは、引用関係だけから導かれる証拠集合をそのまま正解(gold standard)として扱うことはできないと判断されました。
実際、設問の生成に使われた引用由来の証拠論文のうち、関連度が高いと評価されたのはわずか28.3%にとどまりました。その一方で、証拠集合から意図的に除外されていた出典論文自体は、69.5%のケースで関連度が高いと評価されています。この差は、ある文章中の引用が必ずしもその文章から生成された設問への直接的な回答にはならないことを示しています。
そこで、より保守的な正解判定基準が採用されました。
- 2系統のLLMによる独立採点: 生成された各設問と候補論文の組み合わせについて、主たる審査役のgpt-5.6-lunaと、別系統のモデル系列であるdeepseek-v4-flashの2つのLLMが、0から3の関連度を独立に採点します。
- 正解の採用条件: 両方の審査員が「3(その論文単独で設問の主要な科学的根拠になりうる)」と判定した場合にのみ、その論文を正解集合に含めます。
この厳格な手順により、最終的に154問・平均6.1本の正解論文から成る評価セットが構築されました。
ベンチマーク評価結果の比較
主要な指標の検証結果は下表のとおりです。
| 指標 | 単一論文ベンチマーク | 複数論文ベンチマーク |
|---|---|---|
| 評価対象の設問数 | 209問 | 154問 |
| 1問あたりの平均正解論文数 | 1.00本 | 6.10本 |
| ルーティング再現率 | 84.6% | 94.5% |
| 候補プール再現率 | 96.2% | 92.0% |
| Hit@5 | 76.6% | 79.2% |
| Hit@10 | 80.9% | 86.4% |
| Recall@10 | 80.9% | 49.7% |
| MRR@10 | 0.647 | 0.563 |
| nDCG@10 | 0.686 | 0.441 |
評価結果の分析:Hit@10とRecall@10の乖離
ここで特に注目すべきなのは、複数論文ベンチマークにおけるHit@10とRecall@10の差です。
- Hit@10 (86.4%): 「上位10件の中に正解論文が1本でも含まれているか」を測る指標であり、高い水準にあります。
- Recall@10 (49.7%): 「必要な正解論文をどれだけ網羅的に回収できたか」を測る指標であり、半分程度にとどまっています。
つまり、少なくとも1本の主要な文献を見つけることはほぼできていても、複数の文献にまたがる証拠を完全に集めきるという、より高度な要求に対してはまだ半分程度しか応えられていないことになります。
実際、この評価セットに含まれる正解論文数の分布から理論上の上限を計算すると、完璧なランキングであればRecall@10は94.4%まで到達できるはずであり、実測値の49.7%とは大きな開きがあります。
もっとも、検索対象を上位10件から広げた場合の検証では、以下のとおりRecallの上昇が確認されています。
- 上位50件: Recall 78.7%
- 上位100件: Recall 86.8%
この結果から、取りこぼされた証拠の多くはランキングの奥に存在しているものの、完全に検索不可能というわけではないことが示唆されています。
クエリ拡張手法HyDEの検証結果
query拡張手法であるHyDE(Hypothetical Document Embeddings)についても比較評価が実施されています。
- 単一論文ベンチマークでの影響:
HyDEによってRecall@10が0.803から0.744へ、nDCG@10が0.677から0.586へ、MRR@10が0.637から0.534へと有意に低下し、query拡張がかえってランキング精度を悪化させる結果となりました。 - 複数論文ベンチマークでの影響:
HyDEによって候補プール再現率が92.0%から94.3%へ有意に向上した一方、最終的なランキング精度そのものには目立った改善が見られませんでした。
この非対称な結果を踏まえ、現行の実装ではchunkレベルの検索に元のクエリをそのまま使う方式が採用されています。HyDEについては、候補生成の補助としてのみ将来的に活用する案が検討されています。
5. 観測データ取得・解析を担うData Retrieval Agent
Data Retrieval Agentは、SED(Spectral Energy Distribution: スペクトルエネルギー分布)の構築や可視化に必要な、科学的に利用可能な形の観測データを取得するコンポーネントです。
天体座標の特定と4段階のフォールバック
天体名から座標を解決する際には、命名の揺れや別名表記があっても頑健に座標を特定できるよう、4段階のフォールバック戦略が実装されています。
- MMDC(Markarian Multiwavelength Data Center): オートコンプリートAPIをまず試行します。
- SIMBADデータベース: MMDCが失敗した場合にフォールバックします。
- Astropy SkyCoord機能: SIMBADが失敗した場合に続いて試行します。
- NED(NASA/IPAC Extragalactic Database): 最後にNEDへフォールバックします。
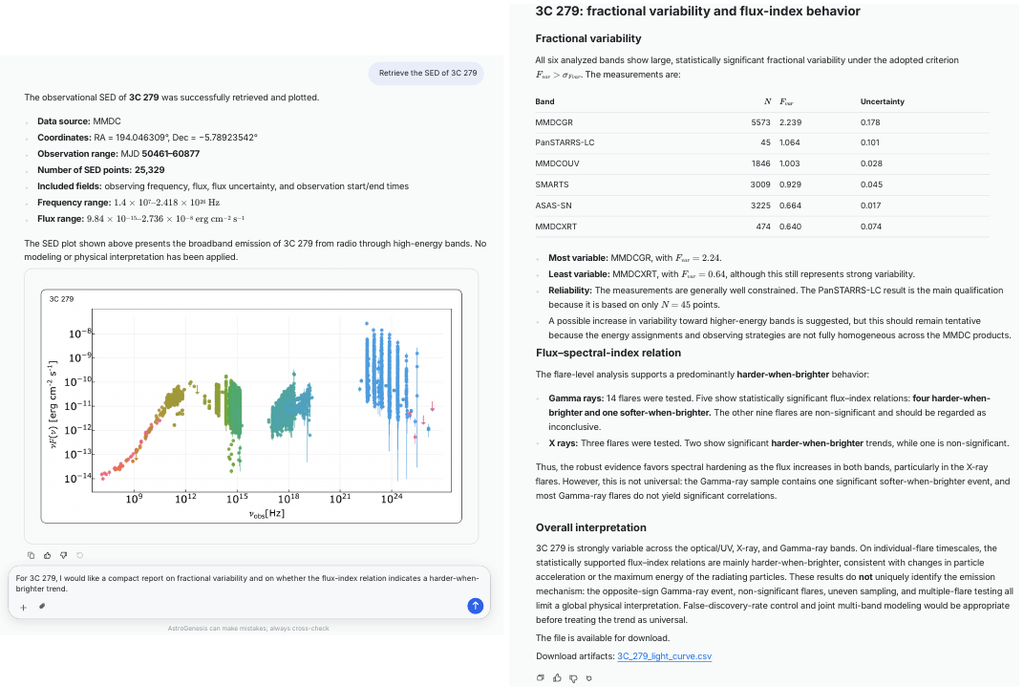
多波長データの取得とSED可視化
座標が特定されると、80種類を超える装置・カタログを保有し、特にブレーザー観測に重点を置いたMMDCへ問い合わせが行われます。
ここでは、Swift-UVOT、Swift-XRT、NuSTAR、Fermi-LATなど複数の装置にまたがるアーカイブデータおよび新規解析済みデータが取得されます。その後、以下の項目をチェックする検証・正規化レイヤーを経た上で、フロントエンドにおいてSEDとして可視化されます。
- フィールドの欠損
- 単位の不整合
- 装置ラベルの不一致
光度曲線を解析する3つのサブエージェント
取得された光度曲線(light curve)データは、さらに3つの解析サブエージェントによって処理されます。
| サブエージェント | 目的 | 主な手法 |
|---|---|---|
| Fractional Variability Sub-agent | 波長帯ごとの内在的な変動振幅を定量化する | 観測誤差を差し引いた分散推定とブートストラップによる不確かさの評価 |
| Flaring Event Sub-agent | フレア(局所的な増光)を検出し、波長帯間の時間差を評価する | Bayesian Blocks(観測データを統計的に均質な区間へ自動分割するアルゴリズム)による区分化と、赤方偏移補正後のピーク時刻差の算出 |
| Spectral Trend Sub-agent | フラックスの増減に伴うスペクトル指数の変化傾向を分類する | フレア区間内でのスペクトル指数と対数フラックスの線形回帰。傾きが負であれば明るくなるほどスペクトルが硬くなる「harder-when-brighter」、正であれば軟らかくなる「softer-when-brighter」と判定し、相関が弱く有意でない場合は判定不能として扱う |
各サブエージェントの算出手法と処理の詳細は以下のとおりです。
Fractional Variability Sub-agentの算出式
計算する指標\(F_{var}\)は、次の式で定義されています。
$$F_{var} = \frac{\sqrt{S^2 – \langle \sigma_{err}^2 \rangle}}{\langle F \rangle}$$
- \(S^2\): 観測されたフラックスの分散
- \(\langle \sigma_{err}^2 \rangle\): 観測誤差の二乗の平均
- \(\langle F \rangle\): 平均フラックス
観測誤差そのものに由来するばらつきを分散から差し引くことで、測定ノイズではなく天体そのものが持つ内在的な変動の大きさを取り出す指標となっています。
Flaring Event Sub-agentの処理手順
Bayesian Blocksアルゴリズムで光度曲線を区分化し、各ブロックのフラックス分布の中央値と、外れ値に強いスケール推定量である1.4826倍のMAD(中央絶対偏差)を組み合わせて活動の閾値を定義します。その上で、統計的に有意な超過を示すブロック群をフレアとして採用します。
異なる波長帯で検出されたフレアのピーク時刻の差は、天体の赤方偏移\(z\)による時間の引き伸ばしを補正するために\((1+z)\)で割ることで、天体自身の静止系での時間差(rest-frame lag)に変換されます。
Spectral Trend Sub-agentの分類基準
フレア区間内でのスペクトル指数と対数フラックスの線形回帰を行い、その傾きによって以下のように分類します。
- harder-when-brighter: 傾きが負の場合(明るくなるほどスペクトルが硬くなる)
- softer-when-brighter: 傾きが正の場合(明るくなるほどスペクトルが軟らかくなる)
- 判定不能: 相関が弱く有意でない場合
適用実例:ブレーザー「3C 279」の解析結果
これらのサブエージェントを組み合わせた実例として、ブレーザー「3C 279」に対する解析結果が示されています。
- γ線帯の変動: \(F_{var} = 2.239\)が観測され、解析対象となった6つの波長帯の中で最も大きな変動振幅を示しました。
- X線帯のスペクトル傾向: フラックスが増加するほどスペクトルが硬くなる「harder-when-brighter」の傾向が、傾き\(-0.478\)、相関係数\(r=-0.91\)、有意確率\(p=1.9\times10^{-3}\)という統計的に有意な形で確認されました。
- クロスバンドラグ測定: 6つの波長帯にまたがる31件のクロスバンドラグ測定のうち、統計的に有意だったのはわずか11件でした。しかも正負の符号が入り混じっており、単一の放射領域が全波長帯の変動を一貫した順序で説明するという単純なシナリオでは説明しきれないと解釈されています。
6. 理論モデリングを担うTheoretical Modeling Agent
Theoretical Modeling Agentは、科学的に利用可能な形のSEDデータを、物理的に解釈可能なモデルパラメータへ変換するコンポーネントです。指定したパラメータに基づいて理論スペクトルを生成する用途と、観測されたSEDに物理モデルをフィッティングする用途の両方に対応しています。
サロゲートモデルとベイズサンプリングによる高速フィッティング
このエージェントが利用するモデリングバックエンドは、事前学習済みの畳み込みニューラルネットワーク(CNN)サロゲートモデルです。以下の各種放射モデルに対応しています。
- SSC(Synchrotron Self-Compton: シンクロトロン自己コンプトン)
- EIC(External Inverse Compton: 外部逆コンプトン)
- ハドロニックモデル
- ハイブリッドなレプト-ハドロニックモデル
計算コストの高い輻射シミュレーションの出力を再現するように訓練されたこれらのサロゲートモデルは、MultiNestによるベイズサンプリングと組み合わされています。これにより、パラメータ空間の効率的な探索と、ベストフィットパラメータ・事後分布・不確かさの推定が可能になっています。
特に、通常は直接的な数値計算が非常に高コストになるハドロニックモデルやマルチメッセンジャーモデリングにおいて、対話的なワークフローの中でリアルタイムに近い速度でフィッティングを実施できる点が、現時点でこのシステムに固有の能力と位置づけられています。
具体例:ブレーザー「PKS 2155-304」へのフィッティング
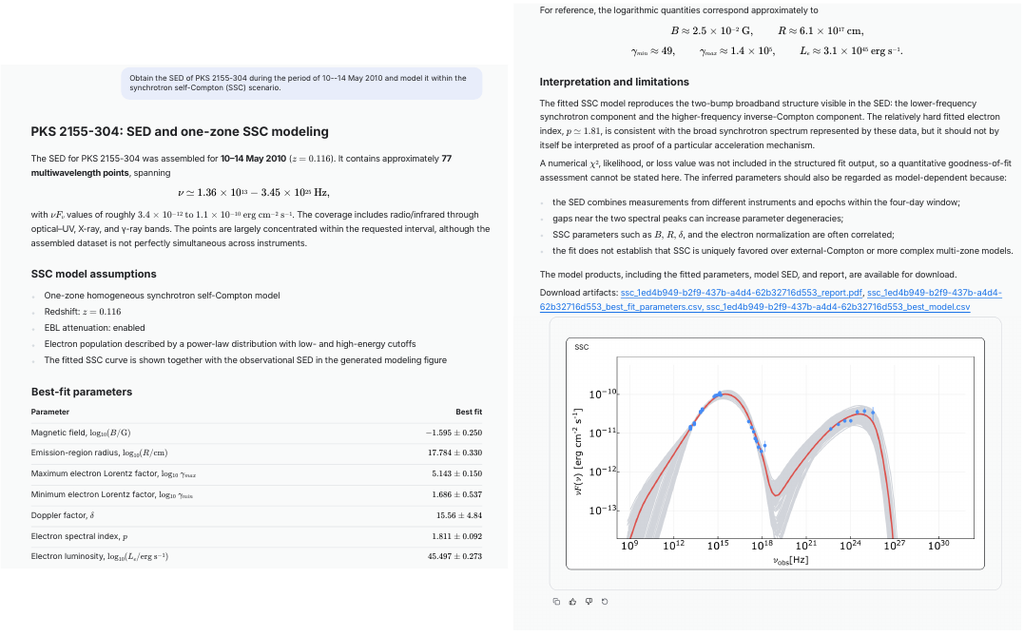
具体例として、天体「PKS 2155-304」の2010年5月10日から14日までのSEDを、単一領域(one-zone)のSSCモデルでフィッティングした結果が示されています。
約77個の多波長データ点から成るこのSEDに対し、それぞれ不確かさとともに以下のベストフィットパラメータが得られました。
- 磁場 (\(B\)): \(B \approx 2.5\times10^{-2} [\mathrm{G}]\)
- 放射領域の半径 (\(R\)): \(R \approx 6.1\times10^{17} [\mathrm{cm}]\)
- Doppler因子 (\(\delta\)): \(\delta \approx 15.6\)
- 電子のスペクトル指数 (\(p\)): \(p \approx 1.81\)
モデリング結果における留意点と限界
ただし、この結果に対してはいくつかの明確な限界も指摘されています。
- 定量的適合度指標の欠如: 構造化された出力には\(\chi^2\)(カイ二乗)や尤度といった定量的な適合度の指標が含まれておらず、その場では良し悪しを数値的に判断できません。
- パラメータの縮退: SEDが異なる装置や異なる観測時期のデータを混在させているため、スペクトルの二つのピーク付近でパラメータ間の縮退が生じやすくなります。
- モデル優位性の非証明: 得られた結果はあくまでSSCという特定のモデルを仮定した場合の推定値であり、外部コンプトンモデルやより複雑な多領域モデルに対してSSCが優れていることを証明するものではありません。
7. 研究アイディエーションを担うResearch Ideation Agent
Research Ideation Agentは、急速に拡大する文献と複雑化する多波長・マルチメッセンジャーデータセットの中から、科学的に有望な問いを見つけ出すという課題に取り組むコンポーネントです。
アイデア創出に向けた情報収集と観測診断
処理は以下の流れで進みます。
- トピック記述への変換: ユーザーの問い合わせを、研究の範囲、関連する物理過程、動機、制約を含む構造化されたトピック記述へ変換します。このトピック記述がLiterature Agentへの検索クエリとして使用されます。
- 天体の特定とデータ取得: Source Data Analysis Agentが、トピックと検索された文献をもとに最も関連性の高い天体を特定し、その天体の光度曲線データをMMDCから取得します。
- 時間的・スペクトル的診断: 前述のFractional Variability、Flaring Event、Spectral Trendの各サブエージェントを呼び出し、天体の時間的・スペクトル的な振る舞いを診断します。
3段階のアイデア生成・選別パイプライン
文献レビューと観測診断のまとめが得られた後、3段階のパイプラインでアイデアが生成・選別されます。
- 候補アイデアの生成 (30件):
探索的な種となる研究アイデアの生成段階として、以下の4要素から成る候補アイデアが30件生成されます。- 科学的動機
- 提案する手法
- 関連する観測設定
- 既存アプローチに対する優位性
- Feasibility Agentによる実現可能性評価:
技術的な実現可能性、実装のしやすさ、単発の実証実験を超えたスケーラビリティ、過大なリソース要求がないことといった観点から各候補を評価し、基準を満たさないものを除外します。 - NoveltyAgentによる独自性評価とランキング:
残った候補に対し、判定者(judge)として独自性、科学的意義、潜在的なインパクトの観点から順位付けを行います。最終的に選ばれた上位5件が、Supervisor Agent経由でユーザーへ返されます。
具体例:ブレーザー「3C 279」のフレア解明アイデア
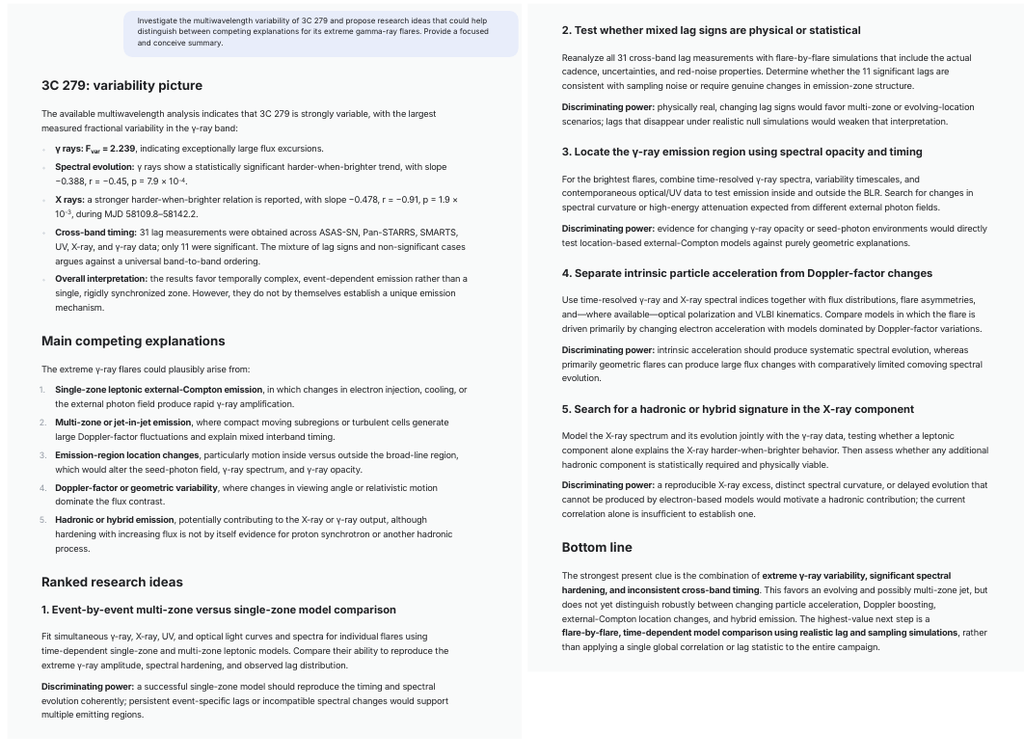
実例として、3C 279の極端なγ線フレアに対する競合する説明を切り分けるための研究アイデアが提示されています。
根拠として用いられたのは、以下の3つの観測的特徴です。
- γ線帯の極端な変動
- 統計的に有意なスペクトル硬化
- バンド間のタイミングの不整合
これらを根拠に、いずれも検証可能な観測・モデリング戦略として以下の具体案が提案されました。
- 単一領域モデルと多領域モデルの比較
- γ線放射領域の位置変化の検証
- 粒子加速そのものの変化とDoppler因子の変化の切り分け
- ハドロニック成分の兆候の探索
なお、こうして生成されたアイデアはあくまで「さらなる調査のための出発点」であり、確立された科学的結論ではないという位置づけが明確にされています。科学的な妥当性の評価・検証・解釈の責任は、研究者自身に残るとされています。
8. 実装基盤と運用体制
フロントエンドの構成とプロジェクト管理
AstroGenesisのフロントエンドは、ホーム、About、Research、Team、Partnership、Pricing、Contactといった案内ページに加え、実際の科学的処理の中心となるチャットインターフェースから構成されています。
- インターフェース構造: サイドバー、メッセージストリーム、クエリ入力欄から成ります。
- プロジェクト管理: スレッドやフォルダ単位で複数の研究プロジェクトを管理できます。
- リアルタイム表示: 文献検索、アーカイブ照会、データ正規化、SED構築、モデル選択、パラメータ推定、結果統合といった一連の処理進行状況がリアルタイムに表示されます。
バックエンドアーキテクチャと使用技術
バックエンドは、会話スレッド、ユーザーメッセージ、ジョブ実行を管理するFastAPI製の中核サービスを中心に構成されています。
- ジョブ実行とエージェント調整: ユーザーのリクエストは非同期ジョブとして即座に登録され、LangGraphベースのマルチエージェントワークフローの中で、PlannerやSupervisorといった調整コンポーネントが専門エージェントの実行を統括します。
- API通信とリアルタイムストリーミング: REST APIによるスレッド管理・メッセージ送信に加え、WebSocket接続を通じて中間的な進捗情報がリアルタイムにフロントエンドへストリーミングされます。Redisがこのメッセージ配信のパブリッシュ・サブスクライブ層を担っています。
- データベース構成:
- PostgreSQL: 会話履歴、ジョブメタデータ、アップロードファイルの記録などの永続化に使用されます。
- MongoDB: 補助的なメタデータストレージとして併用されています。
- Weaviate: 意味検索用のベクトルデータベースとして利用されています。
- 認証・サブスクリプション管理: JWT(JSON Web Token)によるセキュリティを備えた別系統のDjango REST Frameworkサービスが担当しています。課金や個人情報に関わる処理を科学的な処理から切り離す設計です。
- コンテナ化とゲートウェイ: バックエンド全体はDockerでコンテナ化され、Nginxがゲートウェイとしてルーティングとヘルスモニタリングを担っています。
ハードウェア仕様とスケーラビリティに関する注記
現行の稼働環境は、以下のスペックを備えた専用サーバー1台で構成されており、複数のエージェントワークフローを並行して処理できる計算資源が確保されています。
- CPU: 128スレッド AMD EPYC 9534プロセッサ
- メモリ (RAM): 251GB
- ストレージ: 約3.5TB
ただし、この構成は単一ノードでの運用実績にとどまっており、ユーザー数、エージェント数、同時実行タスク数といった観点でのスケーラビリティ自体は評価の対象になっていません。
9. 限界とトレードオフ
現時点で明らかになっているシステムの限界やトレードオフは多岐にわたります。
対象範囲と検索・ルーティングにおける課題
- 対象天体クラスの制限: 現行バージョン(v1.0)で完全に実装されているのはブレーザー向けのDSRMのみであり、GRB、TDE、FRBといった他の突発天体クラス向けのDSRMは開発段階にとどまっています。
- 複数論文検索の網羅性: 複数論文にまたがる証拠を要求される設問に対するRecall@10が49.7%にとどまっており、少なくとも1本の主要文献を見つけることと、必要な証拠を漏れなく回収することの間には依然として大きな差が存在します。
- 文脈依存クエリのルーティング: 単一論文ベンチマークの247問のうち27問は、”this study”や”the paper”のような文脈依存の表現を含んでいたために、正解論文がコーパス内に存在していたにもかかわらずLiterature Agentへ送られず、ユーザーへの確認要求として処理されました。
理論モデリングと評価における制約
- 定量的な適合度指標の欠如: \(\chi^2\)のような定量的な適合度指標が構造化出力に含まれていません。
- パラメータの縮退: 複数の装置や異なる観測時期を混在させたデータでは、パラメータ間の縮退が生じやすくなります。
- 特定モデルの優位性証明の不可: 得られたベストフィットは、特定のモデル(例えばSSC)を他のモデルより優れていると証明するものではありません。
- 他システムとの直接比較の難しさ: 他の文献検索システムとの定量的な比較は、対象コーパスの構成や規模、ベンチマーク設問・正解データの構築方法、返却する文献数といった条件が異なるため、単純には成立しないとされています。
システム出力の位置づけ
全体を通じて繰り返し強調されているのは、AstroGenesisの出力があくまで利用可能なデータ、モデル、検索手順、ワークフロー設定に条件づけられた計算結果であり、研究者による科学的な検証の対象であり続けるという位置づけです。
おわりに
AstroGenesisは、文献検索、観測データの取得と解析、理論モデリング、研究アイデアの生成という、天体物理学研究のワークフローを構成する主要な要素を単一のマルチエージェント環境へ統合したシステムです。特に、事前学習済みサロゲートモデルとベイズ推論を組み合わせることでハドロニックモデリングとマルチメッセンジャー解析を対話的に実行可能にした点、そして文献検索の評価において「1本見つかる」ことと「必要な証拠をすべて回収する」ことを明確に区別するベンチマーク設計を採用した点は、科学応用向けのAIシステムを設計するうえで具体的な参考になります。
科学分野向けのRAGシステムやAIエージェントの実装に取り組むエンジニアにとって、クロスエンコーダに重い重みを与えるスコア融合設計や、引用関係だけに頼らず独立した複数のLLM審査員で正解データを検証する評価手法は、他分野への応用を検討する際にも参考になる具体的な設計判断です。一方で、複数文献にまたがる証拠の完全な回収や、モデルフィッティング結果の定量的な妥当性評価には依然として改善の余地があり、今後の課題として位置づけられています。
今後の展望としては、GRB、TDE、FRBといった追加の天体クラスへのDSRMの拡張、装置レベルの生データを扱うパイプラインの統合、JetSeTのような汎用モデリングフレームワークとの連携に加えて、Nancy Grace Roman Space TelescopeやVera C. Rubin Observatoryといった次世代サーベイのアラートに反応し、新規天体を既存の文献・観測データの文脈に自動的に位置づけるエージェントの追加が挙げられています。研究者が定義した問いに答えるシステムから、継続的に更新される観測データストリームと対話しながら発見を支援するシステムへと発展させることが、長期的な目標として掲げられています。
More Information
- arXiv:2609.28579, N. Sahakyan et al., 「AstroGenesis: A Domain-Specific Multi-Agent AI for Astrophysical Research」, https://arxiv.org/abs/2609.28579
関連記事

PINN入門: 物理法則を組み込んだAIで微分方程式を解く
近年、ディープラーニングの技術は目覚ましい進歩を遂げ、画像認識、自然言語処理、ロボティクスなど、多岐にわたる実世界の問題解決に応用されています。しかし、複雑な物理現象や数学的な問題、特に微分方程式の解決においては、従来の […]

The Multimodal Universe: 天文学向け大規模機械学習用ビッグデータ
天文学は、その観測対象の広大さと複雑さから、常に膨大なデータを扱う分野です。近年、技術の進歩に伴い、画像、スペクトル、時系列データなど、多種多様な形式のデータが取得できるようになりました。これらのデータを統合的に解析する […]

AstroAlertBench: マルチモーダルLLMによる天体分類の現在地
現在の天文学の最前線では、ZTF (Zwicky Transient Facility) などの大規模な観測プロジェクトによって、毎晩数百万件もの天文アラート(突発天体などの観測通知)が生成されています。しかし、データ量 […]