Tokenizer解体新書: BPEとUnigramの比較から迫るLLM性能の真実
LLMを開発していると、モデルの構造や学習データには注意を払っても、入口にあるトークナイザは「とりあえずBPE」で済ませてしまうことが少なくありません。BPE(Byte-Pair Encoding: バイト対符号化)とUnigramLM(ユニグラム言語モデル方式)のどちらを選ぶかについても、明確な根拠なしに既定値を使っている、という方は多いはずです。
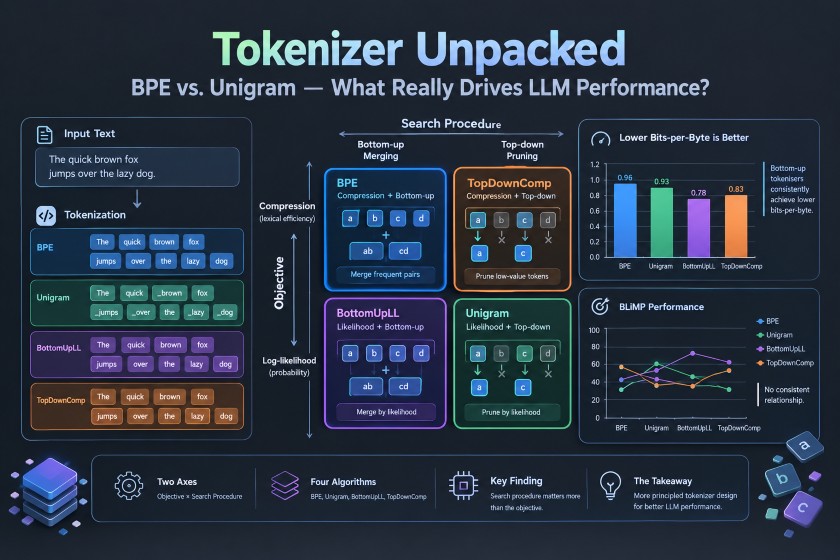
この「何が良いトークナイザなのか」という素朴な問いに対して、本質的な分析を行います。BPEとUnigramLMの違いは「何を最適化するか(目的関数)」と「どう最適化するか(探索手順)」という2つの軸で生じており、従来の比較ではどちらが性能差の原因なのか切り分けることができませんでした。そこで、2つの軸を掛け合わせた2×2の設計空間を用意し、空いていた2つのマスを埋める新しいアルゴリズムとしてBottomUpLLとTopDownCompが提案されました。
この記事では、この設計空間の整理と新手法の仕組みを、基礎的な数式に絞って噛み砕いて解説します。続いて、語彙の中身を調べた分析と、bits-per-byte(BPB: 1バイトあたりのビット数)およびBLiMP(文法性判定タスク)による評価結果を数値とともに紹介します。最後に、実務でトークナイザを選ぶ際の示唆と、現時点で確認されている限界を整理します。
1. トークナイザの基礎
トークナイザの定義と構成要素
トークナイザの役割は、文字列を語彙(vocabulary)に含まれるトークンの列へ変換することです。トークナイザは以下の3つ組として定義されます。
- 語彙 \(S\)
- 符号化関数 \(\mathrm{tok}\): 文字列をトークン列にする関数
- 復号関数 \(\mathrm{detok}\): トークン列を文字列に戻す関数
復号は各トークンの文字列を連結するだけであるため、実質的な違いを生むのは語彙と符号化関数です。
分割規則の重要性
厄介なのは、語彙が決まっても分割の仕方が1通りに定まらない点です。たとえば語彙が \({a, aa, aaa}\) のとき、文字列 \(aaa\) は以下のいずれにも分割できます。
- \(\langle a, aa\rangle\)
- \(\langle aa, a\rangle\)
- \(\langle a, a, a\rangle\)
つまり、トークナイザは語彙だけでなく、「どの分割を選ぶか」という規則まで含めて設計対象になります。
現在の主流手法と従来の比較における落とし穴
現在の主流となっている手法は以下の2つです。
- BPE: 学習コーパスの圧縮率が最大になるように語彙を作成(Gage, 1994; Sennrich et al., 2016)
- UnigramLM: コーパスのユニグラム対数尤度が最大になるように語彙を作成(Kudo, 2018)
既存研究では、BPEで学習した言語モデルがUnigramLMのものより高性能になりやすいという結果が報告されており、これは「圧縮のほうが良い最適化目標である」証拠として読まれがちでした。
しかし、この解釈には注意が必要です。両者には以下の通り、2つの軸で同時に違いが存在します。
- BPE: 圧縮を目的関数とし、語彙を下から積み上げるbottom-up(ボトムアップ)で探索
- UnigramLM: 尤度を目的関数とし、大きな語彙から削っていくtop-down(トップダウン)で探索
両者は2つの軸で同時に異なるため、性能差を片方の軸だけに帰属させることはできません。
2. 目的関数と探索手順
目的関数: 圧縮と対数尤度
トークナイザの最適化において考慮される目的関数は主に2つあります。
圧縮(Compression)
データセット \(D\) をトークナイズしたときの総トークン数を最小化します。
$$G_{comp}(\mathrm{tok}, D) = \sum_{c \in D} |\mathrm{tok}(c)|$$
- 効果: トークン列が短いほど、限られたコンテキスト長を有効に使え、モデルが処理するステップ数も減ります。
対数尤度(Log-Likelihood)
コーパスに確率モデル \(p_\theta\) が割り当てる負の対数確率を最小化します。
$$G_{ll}(\mathrm{tok}, D) = -\sum_{c \in D} \log p_\theta(\mathrm{tok}(c))$$
- ユニグラムモデルへの制限: ここで \(p_\theta\) が本物の言語モデルだと、評価のたびに学習が必要になり現実的ではありません。そのためUnigramLMと同様に、\(p_\theta\) をユニグラムモデルに制限します。
- 確率の定義: 具体的には、トークン \(s\) の確率を「コーパス中の出現回数 \(n_s\) を総トークン数 \(N\) で割った値」である \(p_\theta(s) = n_s / N\) とします。以降、「対数尤度」はこのユニグラム対数尤度を指します。
探索手順: bottom-upとtop-down
厳密な最適解を求める問題は、圧縮の場合にNP困難であることが証明されており、尤度の場合も同様と考えられています。そのため実際には、貪欲な近似探索が必要になります。
| 探索手順 | 出発点 | 1ステップの操作 | 選択基準 |
|---|---|---|---|
| bottom-up(マージ) | アルファベットのみ | 隣接する2トークンを1つに統合 | 目的関数の改善が最大のペア(merge gain) |
| top-down(剪定) | 大きな候補語彙 | トークンを1つ削除 | 目的関数の悪化が最小のトークン(deletion cost) |
各探索手順における符号化の仕組みは以下の通りです。
- bottom-up: マージ手順のリストが符号化関数を決定します。
- top-down: 語彙が決まれば最適な分割が決まる仕組みです(圧縮なら最短の分割、尤度なら最も確率が高い分割を採用)。
2×2の設計空間
この2軸を組み合わせると、既存の2手法と新しい2手法が2×2の空間に収まります。
従来のBPEとUnigramLMは対角線上にあるため、比較しても2軸の効果が混ざってしまいます。新手法を加えることで、以下の切り分け比較が可能になります。
- 探索手順を固定して目的関数だけを変える比較:
- BPE 対 BottomUpLL
- TopDownComp 対 UnigramLM
- 目的関数を固定して探索手順だけを変える比較:
- BPE 対 TopDownComp
- BottomUpLL 対 UnigramLM
| bottom-up(マージ) | top-down(剪定) | |
|---|---|---|
| 圧縮 | BPE | TopDownComp(新規) |
| 対数尤度 | BottomUpLL(新規) | UnigramLM |
3. 新手法BottomUpLLとTopDownCompの仕組み
bottom-up: マージ利得の計算
bottom-upでは、各ペアをマージしたときの利得を毎回コーパス全体から再計算するのは高コストです。そこで、利得を出現回数だけから計算できる形に落とし込んでいます。
圧縮の場合(BPE)
ペア \(\langle s_1, s_2 \rangle\) のマージ利得は、そのペアの非重複な出現回数 \(n_{s_1,s_2}\) そのものです。1回の置換でトークンが1つ減るため、出現回数の分だけコーパスが短くなります。これはBPEが「最頻出ペアをマージする」ことの理論的な裏付けになっています。
尤度の場合(BottomUpLL)
尤度の場合は少し複雑です。ある \(n\) が \(n_1\) から \(n_2\) に変わると、尤度への寄与は \(n_2 \log n_2 – n_1 \log n_1\) だけ変化します。マージでは以下の変化が同時に起こります。
- 元の2トークンの出現回数が減少する
- 新しいトークンの出現回数が0から \(n_{s_1,s_2}\) に増加する
- 総トークン数 \(N\) も \(n_{s_1,s_2}\) だけ減少する
これらの変化を足し合わせたものがBottomUpLLの利得です。BPEと同様に統計量を差分更新できるため、効率的に実装できます。
この利得を一次のテイラー近似すると、次の形になることが示されています。
$$\Delta G_{ll} \approx n_{s_1,s_2},\bigl(\mathrm{PMI}_{adj}(s_1,s_2) – 1\bigr), \quad \mathrm{PMI}_{adj}(s_1,s_2) = \log \frac{N, n_{s_1,s_2}}{n_{s_1}, n_{s_2}}$$
- 指標の意味: \(\mathrm{PMI}_{adj}\) は、2つのトークンが偶然より多く連続する度合いを測る指標(pointwise mutual information: 自己相互情報量)です。つまりBottomUpLLは、頻度が高いだけでなく、系統的に共起するペアを優先します。
- 既存手法との関連: WordPieceは「PMIが最大のペアをマージする」と説明されることがありますが、この式から出現回数の因子を除いたものに相当します。また、S-BPE(Vilar and Federico, 2021)は出現回数を掛けたPMI基準であり、「\(-1\)」の項を除けばこの式と一致します。
top-down: 局所置換近似
top-downでは事情が変わります。トークンを1つ削除すると、そのトークンだけでなく、コーパス全体の最適な分割が変わり得るためです。尤度の場合はさらに、分割が確率モデル \(p_\theta\) に依存し、\(p_\theta\) は分割から推定される、という循環が生じます。
局所置換近似の考え方
そこで、削除コストは「局所置換近似」で見積もります。これは、削除対象のトークンを、残りの語彙で最適に置き換えたときの変化だけを数えるという近似です。
- 圧縮(TopDownComp): 削除コストは \(n_s(|s^{rep}_s| – 1)\)、すなわち出現回数に置換後増えるトークン数を掛けた値になります。
- 尤度(UnigramLM): 尤度版の同種の近似を用い、削除のたびにEM法(期待値最大化法)で \(p_\theta\) を再推定します。
先行手法との相違点と設計理由
TopDownCompに最も近い先行手法はPathPieceですが、削除の評価で「対象のトークンを部分文字列に含む他の語彙トークンの再分割」も考慮する点が異なります。PathPieceの方式を採ると目的関数以外の違いも混入するため、UnigramLMとの差を目的関数だけに絞る目的から、局所置換のみを使う設計が採用されています。
なお、bottom-upのマージ利得は厳密ですが、top-downの削除コストは近似です。この非対称性はtop-down探索に本質的なものであり、手法上の限界の1つでもあります。
4. 実験設定
比較する4手法は、すべて同じ前処理(NFC正規化と、GPT-2の正規表現によるバイトレベル事前トークン化)と同じコーパスで学習されています。違いが目的関数と探索手順だけに由来するようにするための設計です。
言語とモデルの設定
- 英語設定:
- データ: FineWeb-Eduから約20億トークンを抽出してトークナイザを学習
- 語彙サイズ: 8k、32k、128kの3種類
- 言語モデル: 同じFineWeb-Eduで、100M、300M、500M、1Bパラメータの4サイズを学習
- 学習トークン数: パラメータ数の約20倍(Chinchilla方式)
- シード数: 100Mは3シードの平均、それより大きいモデルは1回の学習(1Bは128kのみで、BPBは3シード平均)
- 多言語設定:
- コーパス: 英語100億トークンに加え、ドイツ語、スペイン語、トルコ語、中国語を各25億トークン、計200億トークン
- トークナイザ: その10%のサブサンプルで学習
- 語彙サイズ: 128kのみ
- 言語モデル: 1Bパラメータ
評価指標
評価指標は以下の2系統が用いられています。
- 外的指標(extrinsic、言語モデルの性能):
- BPB(bits-per-byte): 検証データでの評価値
- 文法性の最小対判定(minimal pair)正解率:
- BLiMP(英語)
- MultiBLiMP(英独西土)
- ZhoBLiMP(中国語)
- 内的指標(intrinsic、トークナイザ自体の性質):
- 圧縮量 \(G_{comp}\)、尤度 \(G_{ll}\)
- エントロピー
- Zipf指数 \(\alpha\)
- Coverage 50%
- 語彙利用率
- 平均トークン長
5. 語彙とトークン分布の分析
圧縮量と尤度の目的関数への対応
英語のテストデータ(47,384文書)での結果は以下の通りです(\(G_{comp}\) はトークン総数が少ないほど良い値です)。
- 語彙サイズによる対応の変化:
- 8kの場合: 圧縮ではBPEとTopDownComp、尤度ではBottomUpLLとUnigramLMが優れており、目的関数と結果が一致します。
- 32k以上の場合: この対応が崩れます。128kではBPEが46.86M、BottomUpLLが47.11Mと、bottom-upの2手法が圧縮でも尤度でも優れ、top-downの2手法は目的関数にかかわらず劣っています。目的関数が最適化の結果を素直に決めるわけではないことがわかります。
- エントロピーの傾向:
- エントロピーは \(-\sum_s p_\theta(s)\log p_\theta(s)\) ですが、\(p_\theta(s)=n_s/N\) を代入すると \(G_{ll}/G_{comp}\) に等しくなります(\(N\) は総トークン数で、\(G_{comp}\) そのものです)。
- 8kでは目的関数に沿った差が出ますが、128kではtop-downのほうが一貫して低エントロピーになります(BPEの11.132に対しUnigramLMは9.996)。
| 語彙 | 手法 | \(G_{comp}\)(トークン総数) | 平均トークン長 | Coverage 50% |
|---|---|---|---|---|
| 8k | BPE | 59,559,835 | 5.53 | 242 |
| 8k | TopDownComp | 59,304,113 | 5.67 | 268 |
| 8k | BottomUpLL | 61,170,714 | 6.05 | 152 |
| 8k | UnigramLM | 68,444,350 | 6.72 | 39 |
| 128k | BPE | 46,859,565 | 7.06 | 204 |
| 128k | TopDownComp | 50,312,483 | 6.01 | 149 |
| 128k | BottomUpLL | 47,111,733 | 7.48 | 191 |
| 128k | UnigramLM | 55,546,423 | 6.46 | 53 |
目的関数の痕跡はトークン頻度に残る
Zipf指数 \(\alpha\) は、頻度と順位の関係を両対数グラフで直線近似したときの傾きの符号反転です。\(\alpha\) が大きいほど、順位が下がるにつれて頻度が急速に減少します。また、Coverage 50%は、出現数の合計が全体の半分に達するまでに必要な上位トークンの種類数です。
- 少数のトークンへの集中: いずれの探索手順でも、尤度系のほうが頻度が少数のトークンに集中します。
- 指数の比較: 128kでは、BottomUpLLの \(\alpha\) が1.574でBPEの1.484より大きく、UnigramLMの1.717はTopDownCompの1.443より大きい値を示します。
- 結論: したがって、\(G_{comp}\) や \(G_{ll}\) の値自体は探索手順に支配されても、目的関数の違いはトークン頻度の分布にしっかりと現れます。
語彙の使われ方と重なり
語彙利用率
テストデータで1回以上使われた語彙の割合は、8kと32kではほぼ100%(99.0〜99.9%)でした。しかし128kでは、尤度系が96.8%(BottomUpLL)と97.1%(UnigramLM)となり、圧縮系(98.9%と99.8%)より低くなります。BottomUpLLについては、マージの途中で作られたあと、二度と使われない中間トークンが原因として説明されています。
平均トークン長
平均トークン長は語彙サイズによって傾向が逆転します。
- 小さな語彙: 初期候補語彙にあった長いトークンを保持できるため、top-downのほうが長くなります。
- 大きな語彙: マージを重ねて長いトークンを作れるため、bottom-upのほうが長くなります。
- 目的関数による差: どちらの探索手順でも、尤度系のほうが圧縮系より長いトークンを持ちます。
語彙の重複率
語彙そのものの重なりを見ると、探索手順による違いがより鮮明に現れます。128kでの語彙重複率は以下の通りです。
- 探索手順の影響: 同じ探索手順の手法同士は語彙が近く、探索手順が違う組み合わせは約50%以下の重なりにとどまります。探索手順が最終的な語彙の内容を強く左右することがわかります。
- 近似の精度: なお、BottomUpLLの正確版とPMI近似版は94.5%が一致しており、近似の影響は軽微であることも確認されています。
| 組み合わせ | 語彙重複率 |
|---|---|
| BPEとBottomUpLL | 82.3% |
| TopDownCompとUnigramLM | 60.7% |
| BPEとTopDownComp | 50.2% |
| BottomUpLLとTopDownComp | 45.1% |
| BPEとUnigramLM | 41.8% |
| BottomUpLLとUnigramLM | 41.2% |
6. BPBとBLiMPによる評価
BPB: bottom-upがほぼ全条件で優位
BPB(bits-per-byte)は低いほど良い指標であり、トークナイザが異なるモデル間でも直接比較できます。英語での結果から、主な条件を以下にまとめます。
- bottom-upの優位性: bottom-upの手法が、ほぼすべての条件でtop-downより低いBPBを達成しています。唯一の例外は、300M・32kでTopDownCompがBPEを0.0003だけ上回った場合のみです。
- 尤度系同士の比較: BottomUpLLとUnigramLMの比較では、すべての設定でbottom-upが勝利しています。差が小さい比較も多いため、文書単位のブートストラップ検定が実施され、これらの差が統計的に有意であることが確認されています。
- 目的関数の影響: 同じ探索手順の中で目的関数を比べると、圧縮系がやや有利な傾向にありますが、その影響は探索手順ほど強くありません。8kや32kではBottomUpLLが最良になる条件も複数あり、小さな語彙では尤度目的にも利点が残ります。
| 設定 | BPE | TopDownComp | BottomUpLL | UnigramLM |
|---|---|---|---|---|
| 100M・8k | 1.0736 | 1.0750 | 1.0715 | 1.0819 |
| 100M・128k | 1.0138 | 1.0172 | 1.0149 | 1.0298 |
| 300M・128k | .8462 | .8492 | .8467 | .8547 |
| 500M・128k | .8210 | .8226 | .8207 | .8283 |
| 1B・128k | .7790 | .7816 | .7803 | .7872 |
BLiMP: 一貫した傾向なし
文法性の判定では、BPBのような明確な優劣は見られません。
- 英語の1B・128kにおけるBLiMPスコアは、BPE 0.805、TopDownComp 0.816、BottomUpLL 0.799、UnigramLM 0.818となり、むしろtop-downのほうが高い結果となっています。
- したがって、BPBの優劣がそのまま文法能力に対応するわけではない点に留意が必要です。
多言語での結果
多言語設定(1B・128k)においても、BPBはbottom-upが明確に優位となっています。
- 中国語での大差: 特に中国語では、top-downの2手法が1.34〜1.36であるのに対し、bottom-upは1.24台と大きな差をつけています。
- 最小対の正解率: 言語ごとに最良の手法が分かれます。
- ドイツ語: TopDownComp(.966)が最高
- スペイン語・トルコ語: UnigramLM(.959と.897)が最高
- 中国語: BottomUpLL(.803)が最高であり、TopDownComp(.718)とUnigramLM(.728)は大きく劣る
- 考察: ドイツ語、スペイン語、トルコ語のように形態論が豊かな言語ではtop-downが有利になる可能性が示唆されますが、トークナイザごとに異なる帰納バイアスが言語との相性を生むという解釈にとどめられており、詳しい検証は今後の課題とされています。
| 言語 | BPE | TopDownComp | BottomUpLL | UnigramLM |
|---|---|---|---|---|
| 英語 | .8080 | .8276 | .8082 | .8311 |
| ドイツ語 | .9426 | .9711 | .9416 | .9683 |
| スペイン語 | .9025 | .9284 | .9030 | .9303 |
| トルコ語 | .8936 | .9260 | .8929 | .9252 |
| 中国語 | 1.2464 | 1.3430 | 1.2436 | 1.3575 |
7. 実務への示唆
以上の検証結果から得られる、実務上のヒントを整理します(ただし、検証された範囲が1Bパラメータまでである点には留意が必要です)。
- BPB重視ならbottom-up型を第一選択に:
- BPBで見る限り、性能差の主因は目的関数ではなく探索手順でした。「圧縮が良いからBPEが強い」という説明は、この検証結果とは整合しません。BPBを重視するなら、bottom-upのマージ型(BPEまたはBottomUpLL)が既定の選択肢になります。
- 小語彙(8k程度)での選択:
- 語彙が8k程度の場合は、圧縮と尤度の優劣が目的関数と対応し、BottomUpLLがBPBで最良になる条件もありました。
- 形態論が豊かな言語での検証:
- 形態論の豊かな言語が中心のモデルでは、文法性の指標でtop-downが優れる場面がありました。BPBだけで判断せず、対象言語の下流タスクでも検証する価値があります。
- WordPieceの実装差異に注意:
- WordPieceは元の論文でも実装でも、尤度と圧縮のどちらを最適化するかが揺れており、Hugging Face版は圧縮を最適化していることが指摘されています。同じ名前でも実装が異なり得るため、内部の仕組みを確認することが欠かせません。
8. 限界とトレードオフ
結果の解釈や適用にあたっては、以下の制約とトレードオフを考慮する必要があります。
実験上の制約
| 制約 | 内容 |
|---|---|
| スケール | 学習したモデルは1Bパラメータまで。より大きなモデルや長い学習で結果が変わる可能性がある |
| 言語 | 多言語実験は5言語のみ。うち4言語はラテン文字で、いずれも高資源言語である |
| シード数 | 300M・500Mの英語モデルと、多言語1Bモデルは1シードのみ。小さな差の解釈には注意が必要 |
| 学習コーパス | トークナイザと言語モデルを同一コーパスで学習しており、ドメインが異なる場合は未検証 |
| 評価指標 | BPBと最小対判定のみで、推論力や長文脈での挙動は測っていない |
| top-down近似 | 局所置換近似のため、厳密な削除コストで作った語彙との重複は小規模実験で81.5% |
top-down近似に関する追加検証
top-downの近似については、追加の検証も行われています。
- 剪定割合の影響: 1ラウンドに剪定する割合を10%から1%や0.1%に下げても、語彙の重複はUnigramLMで97%以上、TopDownCompで99%以上でした。したがって、複数トークンを同時に剪定する近似の影響は限定的と考えられます。
- 残る可能性: ただし、局所置換近似そのものの影響は実験で使われた語彙サイズでは確認されておらず、top-downが不利になった一因である可能性は残されています。
おわりに
本記事では、BPEとUnigramLMの性能差を「目的関数」と「探索手順」という2つの軸に分解して検証した知見を紹介しました。BottomUpLLとTopDownCompを加えた2×2の比較の結果、英語および多言語のほぼすべての条件で、bottom-up方式がtop-down方式よりも優れた(低い)BPBを達成することが確認されています。目的関数の違いはトークン頻度の分布やZipf指数といった語彙の性質に明確に現れるものの、言語モデルのBPBに対する影響度としては探索手順のほうが支配的であるといえます。
実務的には、トークナイザ選定において「圧縮か尤度か」以上に「マージ型か剪定型か」を意識するほうが、BPBの観点では有効です。一方で、文法性を測るBLiMP系の指標では一貫した傾向が見られず、形態論の豊かな言語ではtop-downが有利になる場面もありました。そのため、対象言語やタスクが定まっている場合は、小規模モデルを用いて複数の候補を実測・比較することが安全です。
今後の展望としては、BPEの語彙を洗練する手法など、他の目的関数や探索手順の検証が挙げられます。加えて、モデルのスケール、言語の範囲、下流タスクを広げた際に、今回の傾向がどこまで保たれるかも重要な検証課題です。
More Information
- arXiv:2609.19145, Ahmetcan Yavuz, Clara Meister, Tiago Pimentel, 「Objective vs. Search: Decomposing What Makes a Good Tokeniser」, https://arxiv.org/abs/2609.19145
関連記事

DeepOD入門: ディープラーニングによる異常検知の実践
システム運用や製造現場のデータ分析において、異常検知(Anomaly Detection:通常とは異なるデータを見つけ出す手法)は欠かせない技術です。ですが、データが複雑になるにつれて、従来の統計的な手法では十分な精度を […]

LLMを活用したDeep Researchエージェント開発-設計、アーキテクチャ、実装について
大規模言語モデル(LLM)の急速な進化は、近年、人間が数時間を要するような複雑な調査・分析プロセスを自律的に完了させるDeep Research(ディープリサーチ)エージェントという新しいカテゴリーのAIシステムを誕生さ […]

Random Attention: KVキャッシュ削除により推論を加速させる
DeepSeek-R1 や Qwen3、Phi-4-reasoning といった推論特化型の大規模言語モデルは、難しい問題を解くために数万トークンにおよぶ思考連鎖(Chain of Thought: 思考の途中経過をテキ […]