Dr. Claw: Vibe Research のためのAI研究ワークスペース
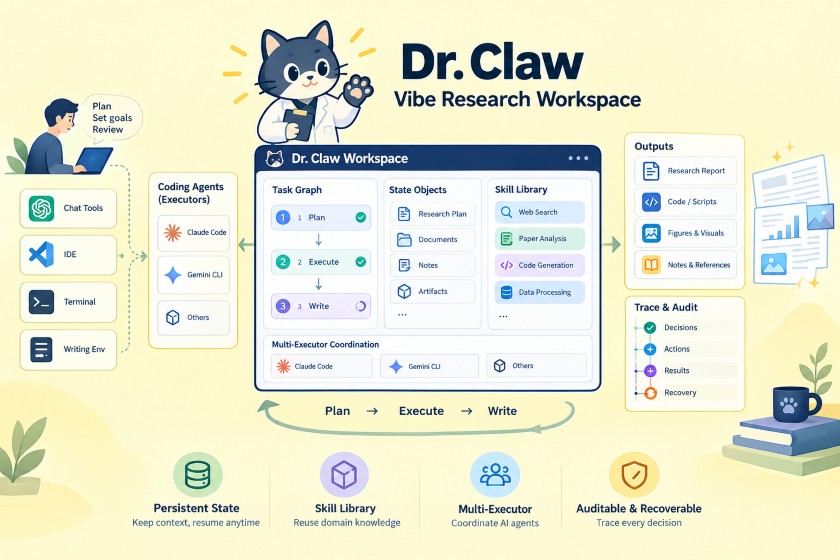
Claude Code や Gemini CLI といったコマンドラインで動作するコーディングエージェントは、ファイルの読み書きや長時間にわたるセッションの維持をこなせるまでに実用段階に入ってきました。しかし、研究という営みを見渡すと、文献調査、着想、実装、分析、執筆という一連の工程は依然としてチャットツール、IDE(Integrated Development Environment: 統合開発環境)、ターミナル、執筆環境の間でばらばらに進行しがちです。どの実験設定をなぜ選んだのか、どの結果を採用してどの結果を捨てたのかという意思決定の経緯は、ツールをまたぐたびに失われやすく、後から振り返って検証できる形では残りません。
こうした課題に対し、Lehigh Universityなどの研究チームからは、新しい自律型の研究エージェントを追加するのではなく、既存のコーディングエージェント(Executor)を人間主導かつ監査可能なワークフローで包み込むというアプローチが提案されています。この着想は「Vibe Research」と名付けられ、その実装として Dr. Claw というオープンソースのワークスペースが公開されています。Dr. Clawは、素のコーディングエージェントと同じ実行系を共有させた状態で比較評価されており、研究の完全性を高めながら監査可能で復旧可能なプロセスの記録を残せることが示されています。
この記事では、Vibe Researchというパラダイムの課題設定から、Dr. Clawを支える状態管理の仕組みとスキルライブラリ、実際のインターフェースで確認できるワークフロー、素のコーディングエージェントとの比較評価の結果、導入にあたって押さえておきたい限界、そして実際にDr. Clawを試すための導入手順までを順番に解説します。
1. AI研究がツール間で分断される課題
既存のCLIコーディングエージェントが抱える課題
大規模言語モデル(LLM: Large Language Model)とエージェントツールは、研究における5つの中核操作をそれぞれ改善してきました。
- 文献レビュー
- 着想
- コード実装
- 結果分析
- 執筆
Claude Code や Gemini CLI のようなCLIコーディングエージェントはこれをさらに一歩進め、ターミナルに常駐してプロジェクトファイルを読み書きし、長いセッションにわたって文脈を保持できます。
しかし、これらのエージェントは「実行」を最適化しているのであって、「制御」を最適化しているわけではないと指摘されています。計画や中間的な意思決定、研究プロセスを振り返り可能にするアーティファクトは散逸するか失われがちです。さらに、人間が明示的に主導権を取り戻せるポイントもほとんど用意されていません。
人間とAIの協調におけるボトルネック
HCI(Human-Computer Interaction: 人間とコンピュータの相互作用)分野の知見として、共同作業のコストは検証と文脈維持に集中し、プロセスの可視性と割り込み可能な制御が重要であることが一貫して示されています。
ここでのボトルネックは個別の能力ではなく、研究プロセス全体を横断するオーケストレーション(Orchestration: 複数の工程を調整・統率すること)にあります。
「Vibe Research」という新たなアプローチ
こうした課題認識から定式化されたのが、「Vibe Research」という考え方です。
研究者が高レベルの目標と制約を自然言語で示し、AIがそれを実行可能な研究ループへとコンパイルして5つのコア操作を実施します。そして最終的な受け入れ判断は、観測可能な成果物に基づいて人間が下します。この人間とAIの役割分担こそが、Vibe Researchの骨格です。
- AIが担う領域: 高スループットで並列化・定型化しやすい実行(検索、コーディング、実行、要約、執筆)
- 人間が握る領域: 研究の方向性、評価基準、重要なトレードオフ、最終的な受け入れ判断
完全な自律性を目指すのではなく、上記のように明確な分業を行う点が特徴です。
既存システムとの比較とDr. Clawの独自性
このアプローチは、AI Scientistのような End-to-End の自律型研究エージェントや、AutoGen StudioやLangGraphのような汎用マルチエージェント基盤とは一線を画しています。
比較の軸は3点に整理できます。それぞれ単体では先行する取り組みにも前例があるものの、3つを同時に満たす点にDr. Clawの独自性があります。
| 比較の軸 | 意味 | Dr. Clawの位置づけ |
|---|---|---|
| 既存CLIエージェントのラップ | 新しい実行系を作らず、既存のコーディングエージェントに処理を任せているか | 実行系は自作せず既存エージェントを利用(TinyScientistにも同様の前例あり) |
| 研究状態の標準搭載 | 開発者が独自にスキーマを設計する必要なく、タスクグラフなどの研究アーティファクトが標準で永続化されるか | Task Graph・Artifact Store・Decision Log・Execution Traceの4種類を標準搭載 |
| 実行途中の人間介入 | ステージの区切りだけでなく、実行途中の任意のタイミングで人間が主導権を取り戻せるか | チェックポイント単位での介入に対応 |
各軸を個別に見ると、構造化された実験ツリーを永続化しているAI Scientist-v2や、チェックポイントだけでなく任意の時点で一時停止できるResearStudioのように、部分的にはDr. Clawより柔軟な先行例も存在します。
それでも3つの軸を同時に満たすシステムは他になく、着想から実験、発表に至る一連の流れを通じて人間の主導権を維持し続ける設計こそが、Dr. Clawの独自の位置づけとなっています。
2. Dr. Clawの仕組み
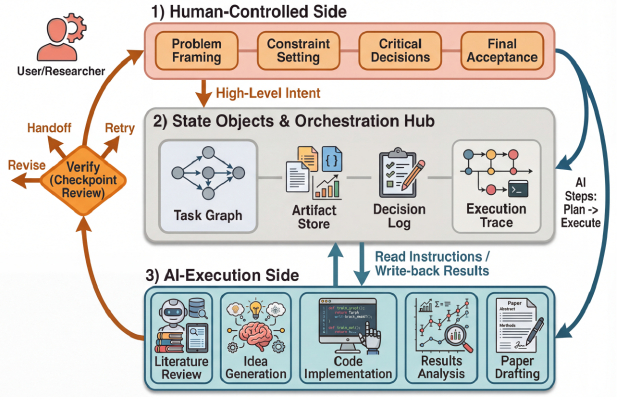
研究プロセスを支える4つの永続状態オブジェクト
Dr. Clawの設計は、「研究者が問題定義・実験の進行・論文作成を、ツールを行き来せずに連続したワークフローの中で完了するにはどうすればよいか」という一つの問いに集約されます。
これに応えるため、Dr. Clawは研究プロセスを以下の4つの永続状態オブジェクトに落とし込みます。
- Task Graph(タスクグラフ): タスク同士の依存関係と進捗を表す構造
- Artifact Store(アーティファクトストア): 生成された成果物の保存領域
- Decision Log(意思決定ログ): 誰が何を承認・却下したかの記録
- Execution Trace(実行トレース): 実際に何が実行されたかの時系列記録
これらが揃うことで、研究のやり取りは一過性のチャット履歴にとどまらず、後から振り返って検証できるプロセスとして確実に残ります。
状態更新の定式化と設計思想
この仕組みの核にあるのが、「ある時点の作業状態は直前の状態、実行されたアクション、得られた観測結果の3つによって決まる」という反復更新の考え方です。数式では次のように表されます。
$$\text{State}_{t+1} = f(\text{State}_t, \text{Action}_t, \text{Obs}_t)$$
各要素の意味は以下の通りです。
- \(\text{State}_t\): 時刻 \(t\) における作業状態(Task Graph・Artifact Store・Decision Log・Execution Traceを合わせたもの)
- \(\text{Action}_t\): システムまたはユーザーが起こしたアクション
- \(\text{Obs}_t\): 得られた観測結果(フィードバック)
この定式化が示す通り、Dr. Clawは単発の応答を返すシステムではなく、状態を継続的に更新していくプロセスそのものを最適化の対象として設計されています。
3層アーキテクチャと実行サイクル
これらの状態オブジェクトを土台として、Dr. Clawは3層のアーキテクチャで動作します。
- Interaction層: チャット・タスクビュー・ファイル・バージョン管理を統合した単一のワークスペース
- Orchestration層: 高レベルの意図をステージ単位のタスクへ変換する状態・ライフサイクル管理
- Execution層: バックエンドの呼び出しと結果の反映、例外処理
ワークフローの実行単位は、以下のサイクルを繰り返す反復処理です。
- Plan(計画)
- Execute(実行)
- Verify(検証)
- Write-back(結果の書き戻し)
制約違反や失敗が起きた場合には、人間が介入できるよう4種類のチェックポイント操作が用意されています。
- Verify: 検証のやり直し
- Revise: 修正
- Retry: 再試行
- Handoff: 人間への引き継ぎ

5つの研究ステージとスキルライブラリ
実際の実行を担うのは、5つの研究ステージにマッピングされたスキルライブラリ(skill library)です。ステージ別の内訳は次のようになっています。
| 研究ステージ | 対応するスキル数 |
|---|---|
| Survey(文献調査) | 11 |
| Ideation(着想) | 14 |
| Experiment(実験) | 18 |
| Publication(執筆・出版) | 22 |
| Promotion(発信) | 3 |
主要なステージ対応スキルとして紹介されているのは上記の計58種類ですが、実運用のカタログにはより広範な171種類のスキルが収録されています。
そのうち87種類が独自のSKILL.md(スキルの仕様を記述するマニフェストファイル)を持つトップレベルのエントリです。その多くは社内で開発されたスキル群(aris-*系44種、inno-*系16種、ds-*系14種)が占めており、残りは公開されているスキル集から取り込まれています。
スキルがタスクに紐づけられる経路には、以下の3つがあります。
- 自動マッピング: タスクのステージや種別に応じたマッピング
- 自動読み込み: 指示文中のキーワード検出による読み込み
- 手動呼び出し: ダッシュボードからの直接呼び出し
第一級の安全機構(ポリシー制約)
外部呼び出しやコード実行に伴うリスクに対しては、許可されたポリシーに含まれるアクションしか実行できないという制約が、第一級の安全機構として組み込まれています。
$$\text{Action}_t \in \mathcal{A}(\text{Policy}_t)$$
この式は、時刻 \(t\) における権限設定 \(\text{Policy}_t\) が定める実行可能なアクション集合 \(\mathcal{A}(\text{Policy}_t)\) の範囲内でしかアクションを起こせないという制約を表しています。
3. インターフェースで見るワークフロー
連携する三画面のインターフェース構成
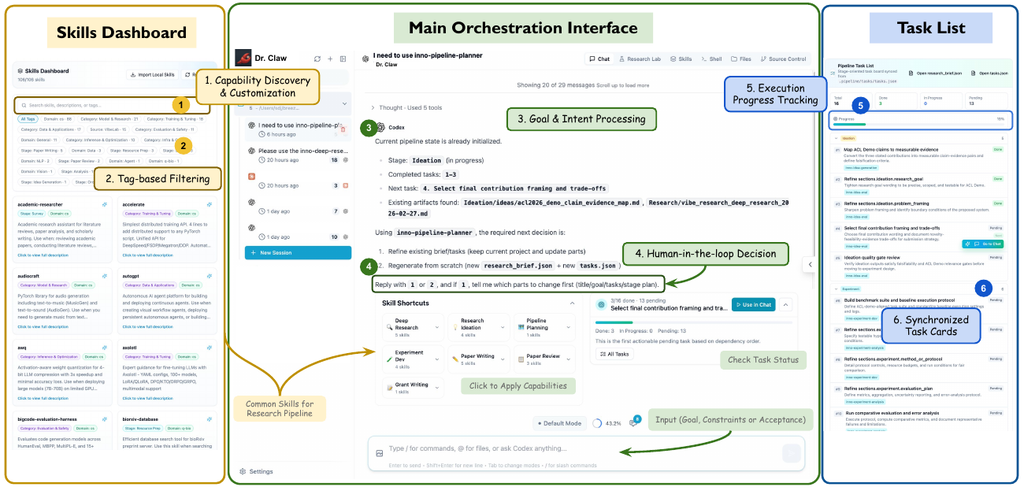
Dr. Clawの操作画面は、連携して機能する3つの画面から構成されています。
- 左側:Skills Dashboard(スキルダッシュボード)
- ステージ別にスキルを閲覧し、タグで絞り込んで目的のスキルを見つけるための画面です。
- 中央:メインオーケストレーション画面
- 目標・制約・受け入れ基準を統一されたプロンプトとして受け付ける主画面です。
- ユーザーが研究リード(目標の確認と重要な意思決定を担う役割)として振る舞い、Dr. Claw側がタスクの分解・実行の振り分け・状態のフィードバックを担います。
- 右側:Task List(タスクリスト)
- 全体・完了・進行中・保留といった進捗の集計と、ステージ別に整理されたタスクカードを表示します。
- 進捗確認やタスク単位の追跡を行えるほか、保留中の項目から次のアクションを直接起動できます。
スキル実行への変換プロセス
スキル画面において検証されているのは、スキルの個数そのものではなく、「ユーザーが発見した能力を実際に実行可能なステップへと変換できるか」という点です。
以下の3つの操作を通じて、この変換が円滑に機能することが確認されています。
- スキルボードの閲覧
- テーマによるタグベースの絞り込み
- プロジェクトへの新規スキルの手動追加
非破壊的な失敗リカバリの実証
非破壊的な失敗リカバリの実演例として、Derm7ptデータセットを使った皮膚病変分類のミニプロジェクトにおいて、意図的に誤ったファイルパスを与えて失敗を誘発させたケースがあります。
Dr. Clawのリカバリプロセスは以下の通りです。
- エラー検知と停止: エラーを検知しても黙って自己修正はせず、いったん実行を停止して失敗を報告します。
- 履歴の記録: 失敗に至る経緯を実行トレースと意思決定ログに記録します。
- 再試行と復旧: 正しいパスを与えて再試行すると、23件のツールイベントを経て精度0.892の成果物へと回復しました。
- 成果物の保護: 復旧の際、既存の5つのファイルはすべてそのまま保持されました。
このように、失敗した試行を上書きして消去するのではなく、修正後の成果物を積み増す形でワークスペースが復旧します。
なお、このデモは対になる素のコーディングエージェント側のリカバリ実行を伴わない単一条件での実演であり、あくまで「復旧可能であること」を示す実演にとどまる点も留意しておく必要があります。
4. 評価実験
評価実験の設計と設定
評価実験では、Dr. Clawが包んでいる素のコマンドラインコーディングエージェント(bare command-line agent)との差分を、モデルや権限設定ではなく、タスクグラフ・状態オブジェクト・スキルライブラリという「オーケストレーション層一式」に限定することが狙われています。
具体的な実験環境と設定は以下の通りです。
- バックエンド実行系: CodexプロバイダのGPT-5.4モデルに固定
- 権限プロファイル: danger-full-access/approval-neverという同一プロファイルを使用
- 比較対象: Dr. Clawと素のCodexエージェント
評価には、医療分野の以下の3タスクが使われました。
- メラノーマ分類(Derm7ptデータセットを使用)
- 母斑(nevus)分類(Derm7ptデータセットを使用)
- 臨床ノートのリスク評価
各タスクには「厳密で出版水準の研究を実施せよ」という同一の自由記述式(open-ended)の指示のみが与えられ、採点基準はエージェントには知らされていません。
完全性(Completeness)の比較
完全性(completeness)は、21個の研究ベストプラクティス要素のうち、成果物に自発的に含まれている要素の数を機械的に計測したカバレッジ指標です。内容そのものの正しさを判定する指標ではない点には留意が必要です。
この21要素には、コードの再現性、複数モデルの比較、交差検証、較正、アブレーション、統計的な厳密性、図表、自分の数値を引用した執筆のほか、限界節、サブグループ分析、実在する関連研究の引用といった「research-hygiene(研究上の作法)」要素が含まれます。
| タスク | 素のコーディングエージェント | Dr. Claw |
|---|---|---|
| メラノーマ分類 | 0.86 | 1.00 |
| 母斑(nevus)分類 | 0.91 | 1.00 |
| 臨床ノートのリスク評価 | 0.86 | 0.86 |
| プール平均 | 0.873 | 0.952 |
research-hygiene(研究上の作法)における明確な差
両者の差が生じている主な要因は、モデリングの精度ではなくresearch-hygiene要素にあります。
| research-hygiene要素 | 素のコーディングエージェント | Dr. Claw |
|---|---|---|
| 限界(Limitations)節の記載 | 0.33 | 1.00 |
| サブグループ分析 | 0.33 | 1.00 |
| 実在する関連研究の引用 | 0.00 | 0.67 |
交差検証・較正・アブレーションといった要素は両条件とも通過率1.00で差がつきませんでした。
その一方で、上記の3要素では明確な差が開いています。特に素のエージェントは、3タスクすべてにおいて実在する関連研究を一つも引用できませんでした。
ただし、プールした完全性の差(Δ=+0.079)の95%ブートストラップ信頼区間は[-0.00, +0.14]でゼロを含んでおり、統計的に有意とまでは言えません。3タスクすべてにおいて「Dr. Claw ≥ 素のエージェント」という傾向は一貫しているものの、限定付きの結果として捉える必要があります。
監査可能性(記録の保持)の違い
監査可能性の面でも大きな違いが確認されています。
- Dr. Claw: 平均14ノードのタスクグラフ、平均14件の実行トレース、平均10件の意思決定ログという問い合わせ可能な記録を保持
- 素のエージェント: 設計上、これらの状態オブジェクトを一切保持しない
これは単なるスコアの差ではなく、設計上のアフォーダンス(affordance:ある行動を可能にする性質)の違いであると位置づけられています。
なお、書き起こしファイルの参照解決率はDr. Clawが100%、素のエージェントが62%でした。ただし、参照数自体が48件対8件と大きく異なっているため、この規模の比較では優劣の断定は留保されています。
回顧的ヒューマンスタディによる操作者体験の評価
自動比較では測れない操作者側の効果を評価するため、AI博士課程の参加者7名(ハイパフォーマンスAI、医療AI、大規模言語モデルの3分野)を対象とした回顧的ヒューマンスタディも実施されています。
実験は以下のハイブリッドな設計で行われました。
- Dr. Claw条件: ライブログにより記録
- 他の2条件(AIツールなし、一般的なWeb・デスクトップAIアシスタント): 同じ指標定義に正規化した回顧的な自己申告データを使用
着想・実験・執筆の3段階を通じて、Dr. Clawには以下の傾向が確認されました。
- 完了時間が短い傾向にある
- 出力品質の主観評価が最も高くなる傾向にある
- ツール切り替え回数が少なく、体験評価が高い傾向にある
特に「体験」の指標に関しては、Friedman検定(Friedman test)およびHolm補正済みペアワイズWilcoxon検定の両方において、3段階すべてで統計的に有意な差が確認されています。
5. 導入時に押さえておきたい限界とトレードオフ
Dr. Clawの導入や評価結果の解釈にあたっては、いくつかの限界やトレードオフを押さえておく必要があります。
評価規模と検証範囲に関する限界
今回の評価は、限られたタスク数・参加者数による小規模で探索的な実証にとどまります。報告されている差は方向性を示す証拠であり、因果関係や統計的な検出力を備えた効果を主張するものではありません。また、1タスクにつき1回の試行しか行われていない点にも注意が必要です。
構成要素の個別効果が未分離(アブレーションの課題)
バックエンド実行系を固定した比較は、厳密なアブレーション実験ではありません。Dr. Clawが追加するタスクグラフ、永続状態オブジェクト、スキルライブラリ、ワークフロー指示は一つの束として比較されており、観測された差がどの要素に起因するのかは切り分けられていません。スキルのみ、あるいはオーケストレーションのみを分離した検証は今後の課題とされています。
完全性指標の性質と科学的妥当性の検証
完全性のスコアは、あくまで期待される21個の研究要素が存在するかどうかを数えるカバレッジ指標です。内容の正しさそのものを判定するものではないため、科学的な妥当性を確かめるには専門家によるアーティファクト単位のレビューが別途必要となります。
その他の留意点と運用上のトレードオフ
その他にも、以下のような留意点が挙げられます。
- 比較対象の範囲: 比較対象はDr. Clawが包んでいる素の実行系であり、最先端のオーケストレーションフレームワークそのものではありません。
- 事前習熟度の影響: 操作者がどちらのインターフェースに事前に慣れていたかという交絡要因が残ります。
- ドメインの限定性: 評価タスクが医療という単一ドメインに限られています。スキルライブラリやタスクグラフといった構造化された抽象化が、硬直的な構造がかえって足かせになりうる他分野の研究にそのまま転用できるかは未実証です。
- 構成への依存性: モデル自体の性能向上ではなく、あくまでワークフロー統合による効果です。そのため、バックエンドのモデル、権限設定、スキルの網羅性といった構成の選び方に効果の大きさが左右されます。
6. Dr. Clawの導入方法
Dr. Clawは、公式リポジトリ( https://github.com/OpenLAIR/dr-claw )にてオープンソースとして公開されています。リポジトリのドキュメントに基づき、手元で動かすまでの手順を解説します。
前提条件・システム要件
導入にあたって、以下の環境が必要です。
- Node.js: バージョン20以上(v22のLTS版=Long Term Support: 長期サポート版を推奨)
- コーディングエージェントCLIツール: Claude Code、Gemini CLI、Codexのいずれかに対応するCLIツール
- ネイティブビルドツール: node-ptyやbetter-sqlite3といった依存パッケージをビルドするために必要
インストール手順
手軽に試す場合
手早く試すだけであれば、インストール作業なしに実行できるコマンド、またはグローバルインストールが利用できます。
# インストールなしで直接実行
$ npx dr-claw

# またはグローバルインストール
$ npm install -g dr-claw
ソースから動かす場合(開発目的)
ソースコードから起動する場合は、以下の手順を実行します。
$ git clone https://github.com/OpenLAIR/dr-claw.git
$ cd dr-claw
$ npm install
$ cp .env.example .env
$ npm run dev
環境変数の設定(.env)
.envファイルでは、主に以下の項目を設定します。
PORT: バックエンドサーバーのポート番号VITE_PORT: フロントエンド開発サーバーのポート番号HOST: バインドするアドレスWORKSPACES_ROOT: 新規プロジェクトのワークスペースを保存する既定の場所
なお、認証に使用するJWT(JSON Web Token)のシークレットは、明示的に設定しなくても初回起動時にランダムな値が自動生成され、データベースと同じ場所に保存されます。
アクセス方法と運用オプション
起動後は、ブラウザから各環境のURLにアクセスしてワークスペースを利用します。
- 開発環境: http://localhost:5173
- 本番環境: http://localhost:3001
その他の運用オプションおよび仕様は以下の通りです。
- デスクトップアプリ: macOSおよびWindows向けのインストーラーが配布されています。
- CLI連携: ターミナル上で
claude、gemini、codexといった各種コマンドを介した利用に対応しています。 - モデルの拡張:
OPENROUTER_API_KEYを設定することで、OpenRouter経由で数百種類のモデルを切り替えて利用可能です。 - ライセンス: Dr. Claw自体はAGPL-3.0ライセンスの下で公開されており、GPL-3.0のアップストリームコンポーネントを含む構成となっています。
おわりに
Dr. Clawが目指しているのは、もう一つの自律型研究エージェントを作ることではありません。既存のコーディングエージェントには備わっていない状態管理・制御・監査というレイヤーを、後から補うことです。タスクグラフ・アーティファクトストア・意思決定ログ・実行トレースという4つの永続状態オブジェクトと、5つの研究ステージに対応したスキルライブラリを組み合わせることで、着想から実験、執筆に至る一連のプロセスを、人間が主導権を取り戻せる形のまま一本の流れとして扱えるようにしている点が大きな特徴です。
実務への示唆としては、誰が何を承認したかを後から追える監査可能性が課題になっている場面や、複数のツールを行き来するたびにコンテキストを失いがちな研究・開発フローから試すのが効果的です。一方で、完全性の差は統計的に有意とまでは言えず、評価対象も医療ドメインの3タスクに限られているため、あらゆる研究領域やワークフローにそのまま当てはまるとは限りません。バックエンドの実行系や権限設定、スキルの網羅性によって効果が左右されることも踏まえ、まずは小規模な試験導入から始め、監査ログや完全性の変化を確認しながら適用範囲を広げていくアプローチが現実的です。
今後の展望としては、スキルライブラリ単体やオーケストレーション層単体を分離したアブレーション研究による効果の切り分け、医療以外のドメインへの適用可能性の検証、そしてより大規模で統計的な検出力を備えた比較評価の実施が重要な課題として挙げられます。コーディングエージェントの能力そのものが急速に向上していく中で、その能力を研究プロセス全体でどのように制御し、監査可能な形に保ち続けるかという問いは、今後のエージェント活用を左右する重要な論点となるはずです。
More Information
- arXiv:2609.00365, Dingjie Song et al., 「Dr. Claw: An AI Scientist Workspace for Vibe Research」, https://arxiv.org/abs/2609.00365
関連記事
ASI-Bench: 科学的超知能への道のりと自理性の壁
LLMエージェントがコーディングやデータ分析、長時間にわたるタスク遂行など、様々なベンチマークで高いスコアを記録するようになってきました。そうした中で「AIは自律的に科学研究を進められるのか」という問いは、研究の場だけで […]

PySR: シンボリック回帰とは何か?
シンボリック回帰(Symbolic Regression、記号回帰とも呼ばれます)は、データを説明する数式を自動的に見つけ出す機械学習手法です。この手法では、関数の形式を事前に決めることなく、与えられたデータに最も合う数 […]

宇宙物理学における基盤モデル
近年、深層学習を大量のデータで一度事前学習し、それを多様なタスクに使い回す「基盤モデル(Foundation Model)」という言葉が、天文学のデータ解析でも目にする機会が増えています。ただし、Transformerを […]